分布式DBA渡劫:从通宵翻车到AI自治|DTCC2026演讲实录
🎙 DTCC2026 专场11现场分享|台下笑声、点头、拍照不断,不少DBA会后感慨:凌晨告警的故事,简直就是我的日常。
作者:马顺华(数据库界少华|shunwah星辰数智社)
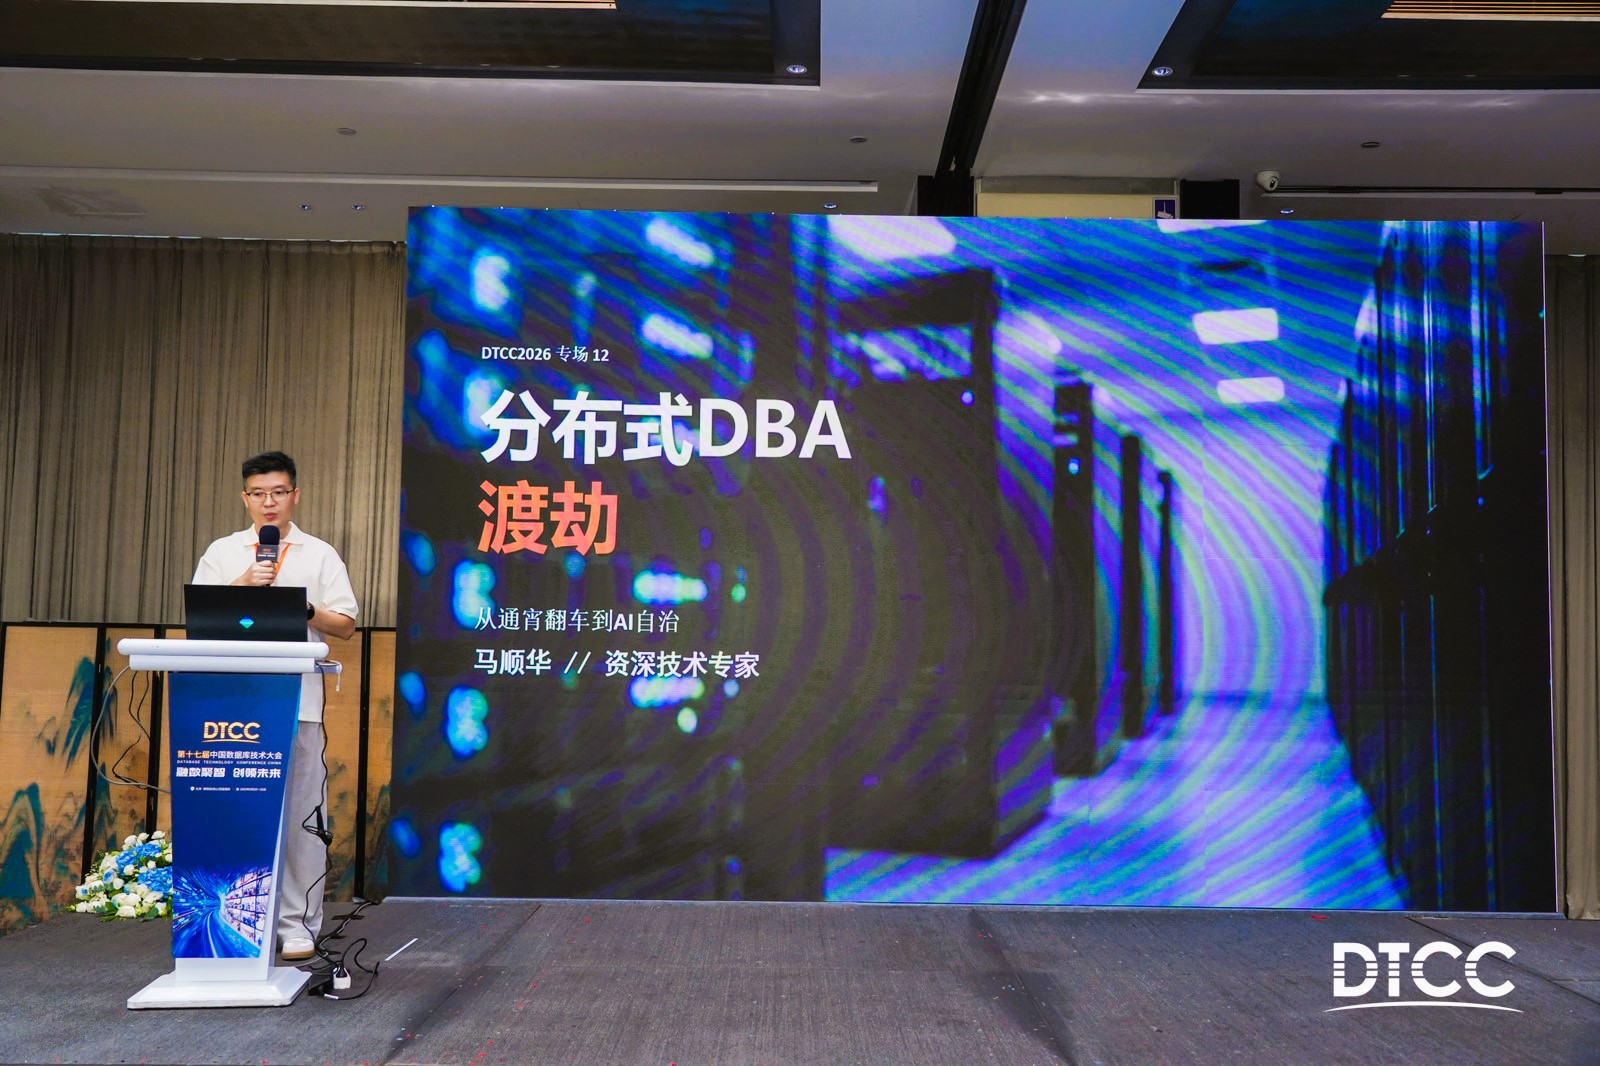
在参加完DTCC2026专场演讲后,我发现一个很扎心的现实: 认认真真堆砌术语的硬核干货,阅读寥寥;把踩坑故事、情绪共鸣和技术干货揉在一起,反而容易被人记住。
很多时候我们陷入内耗,不是技术能力不够,而是依旧在用老旧人肉模式对抗分布式时代的复杂度,越干越疲惫。
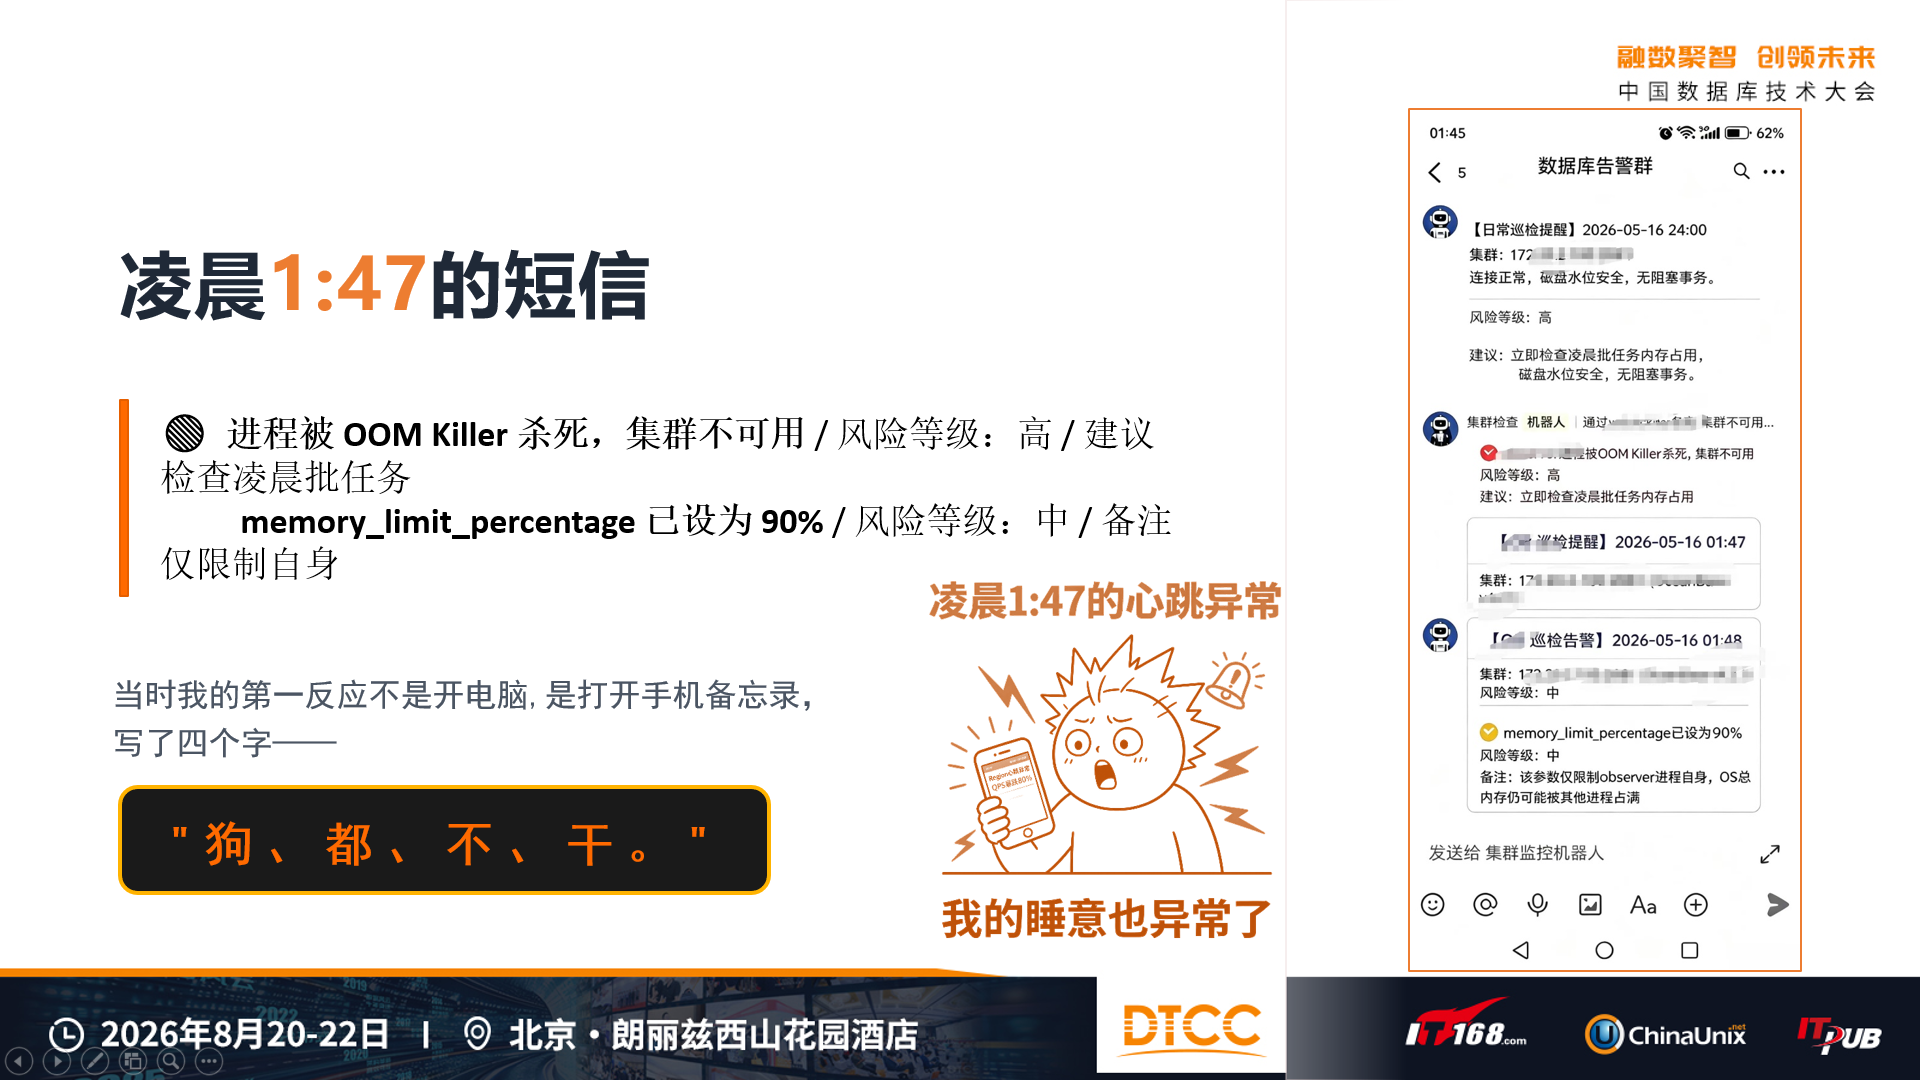
01 | 那条凌晨 1:47 的短信
先还原一条真实短信:
🔴 进程被 OOM Killer 杀死,集群不可用 / 风险等级:高 / 建议检查凌晨批任务
🟡 memory_limit_percentage 已设为 90% / 风险等级:中 / 备注:仅限制自身
发送时间: 凌晨 1:47。
当时我的第一反应不是开电脑,是打开手机备忘录,写了四个字——
“狗、都、不、干。”
但狗不干,我干啊。因为我是个DBA。吐槽归吐槽,活还是得干。
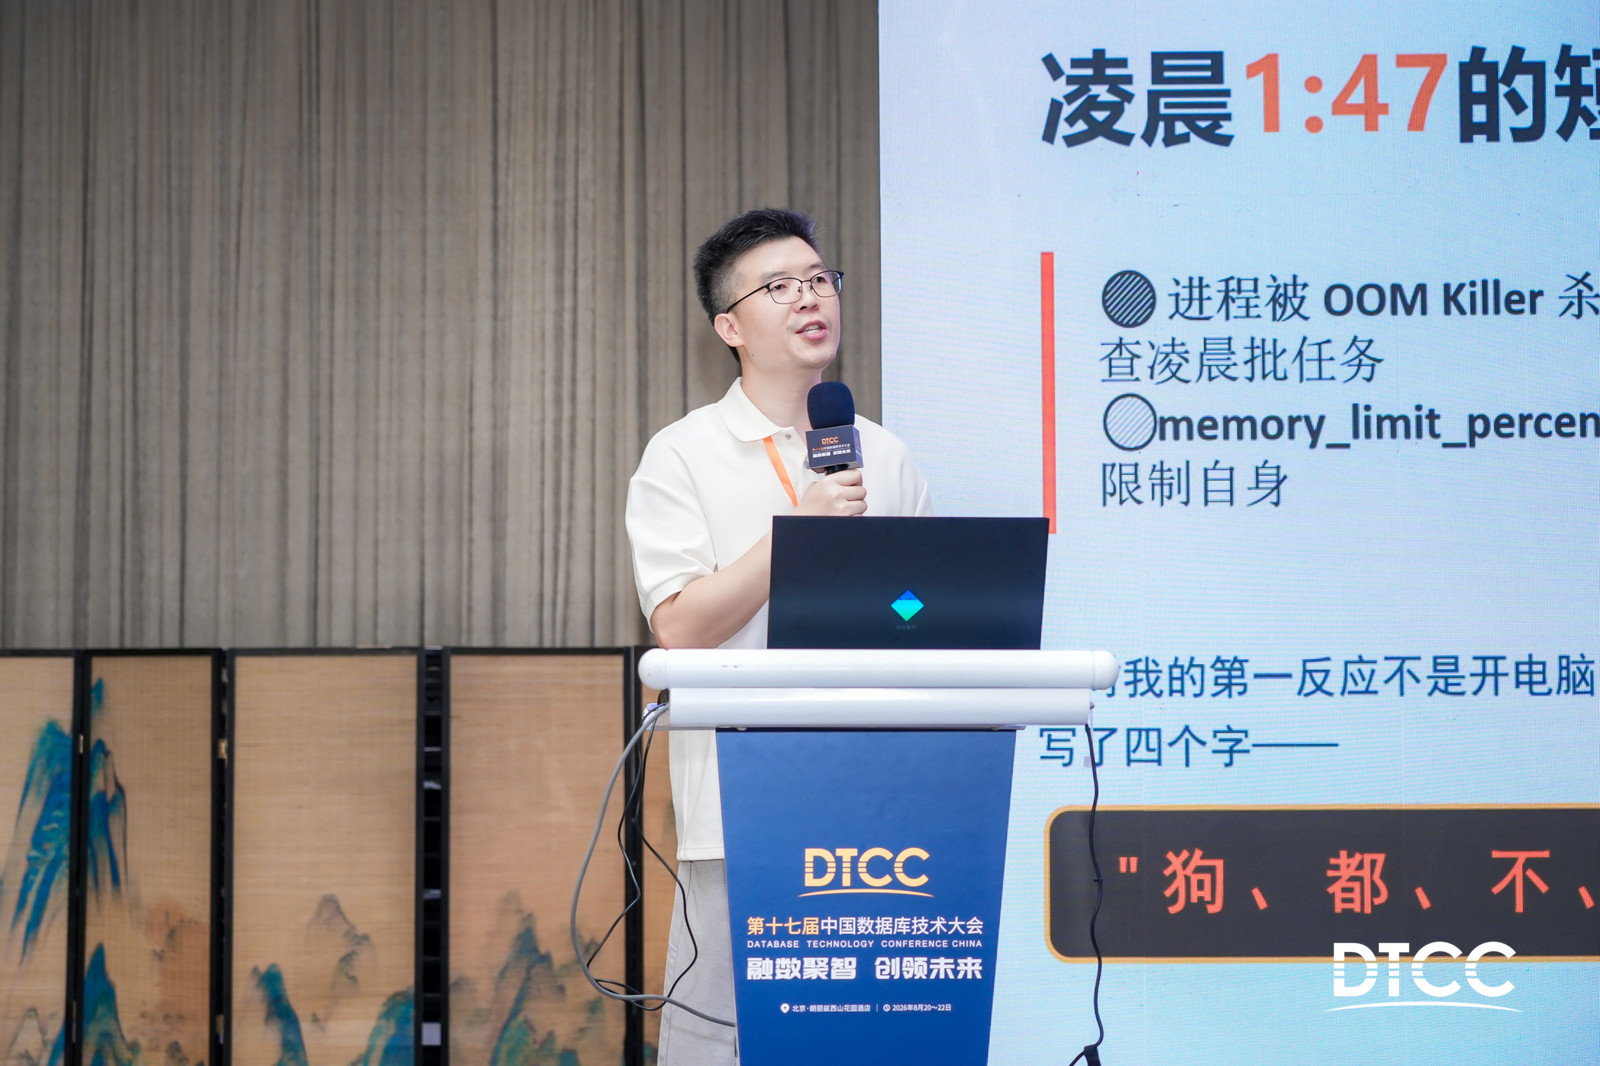
这是我在 DTCC 2026 专场11《分布式数据库管理应用实践》 的分享开场。8月22日上午,北京朗丽兹西山花园酒店,40分钟的分享,30分钟干货 + 10分钟互动。
台下有人笑了,有人点头,还有人举起手机拍那页PPT。散场后有位同行走过来,压低声音跟我说了一句我印象特别深的话:
“华少,你今天讲的那个凌晨两点电话的事,跟我之前经历的一模一样。”
你看,技术人的共鸣,从来不需要煽情。这种「痛」,懂的人都懂。
02 | 以前管分布式集群,全靠"人肉智能"
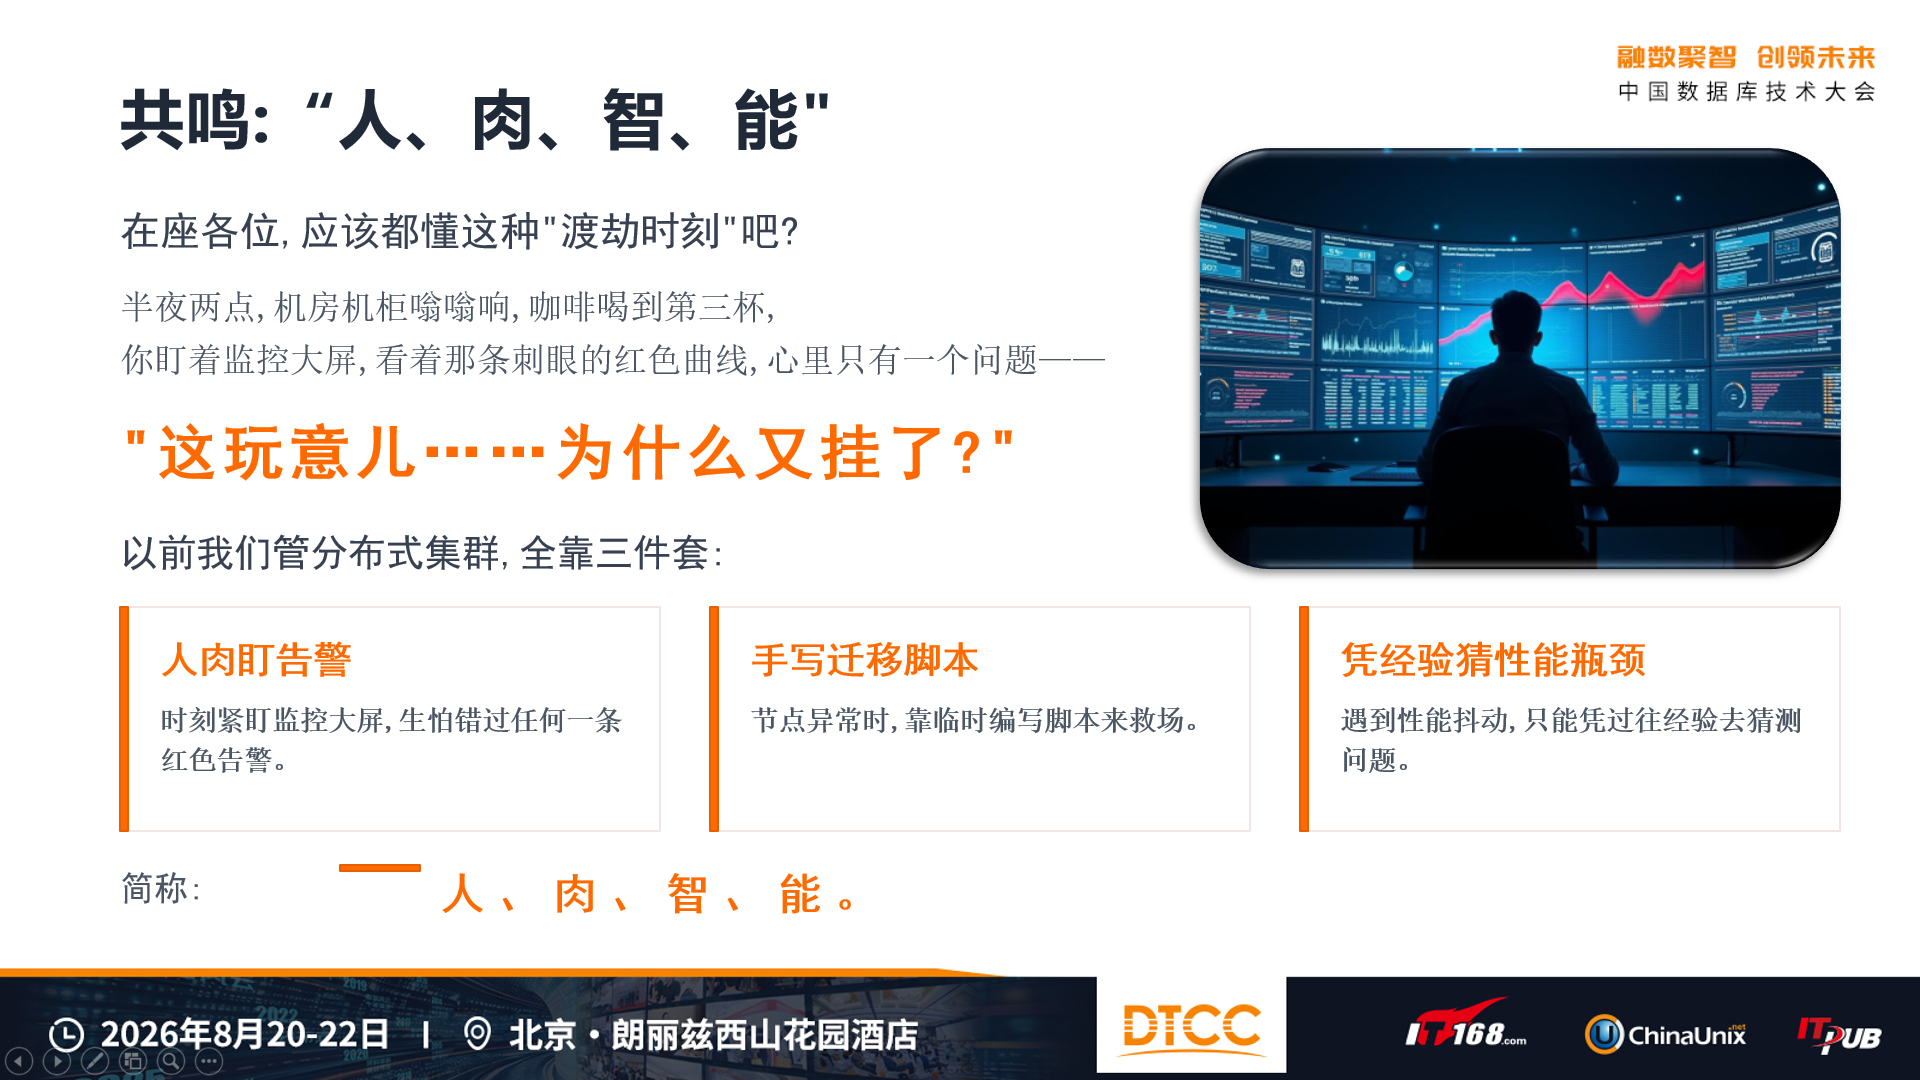
在座各位,应该都懂这种"渡劫时刻"吧?
半夜两点,机房空调和机柜嗡嗡响,咖啡喝到第三杯,你盯着监控大屏,看着那条刺眼的红色曲线,心里只有一个问题——
“这玩意儿……为什么又挂了?”
以前我们管分布式集群,全靠三件套:
- 人肉盯告警——时刻紧盯监控大屏,生怕错过任何一条红色告警
- 手写迁移脚本——节点异常时,靠临时编写脚本来救场
- 凭经验猜性能瓶颈——遇到性能抖动,只能靠过往经验去猜
简称: 人、肉、智、能。
人,就是整个分布式系统最大的容错组件。
为什么分布式?因为单机真的扛不住了
很多人问我:分布式是不是伪需求?
我说:你先把单机的"三座大山"扛住,再来聊这个。
第一座山:规模天花板。 租户数量超过2000,连接数、内存、IO全撞墙。就像开着小轿车拉货,最后要么卡死,要么散架。
第二座山:资源预留的"大冤种"模式。 一个用户一个实例,隔离性拉满,成本直接起飞。为了几天暴雨,天天背着大伞,资源闲置率极高。
第三座山:"意大利面条"架构。 业务既要事务,又要分析,还要向量检索。链路长、数据同步头疼、半夜被叫醒次数指数级上升。
总结:要么贵死,要么卡死,要么累死。
分布式不是万.能药,但它是 业务倒逼的必然之路。
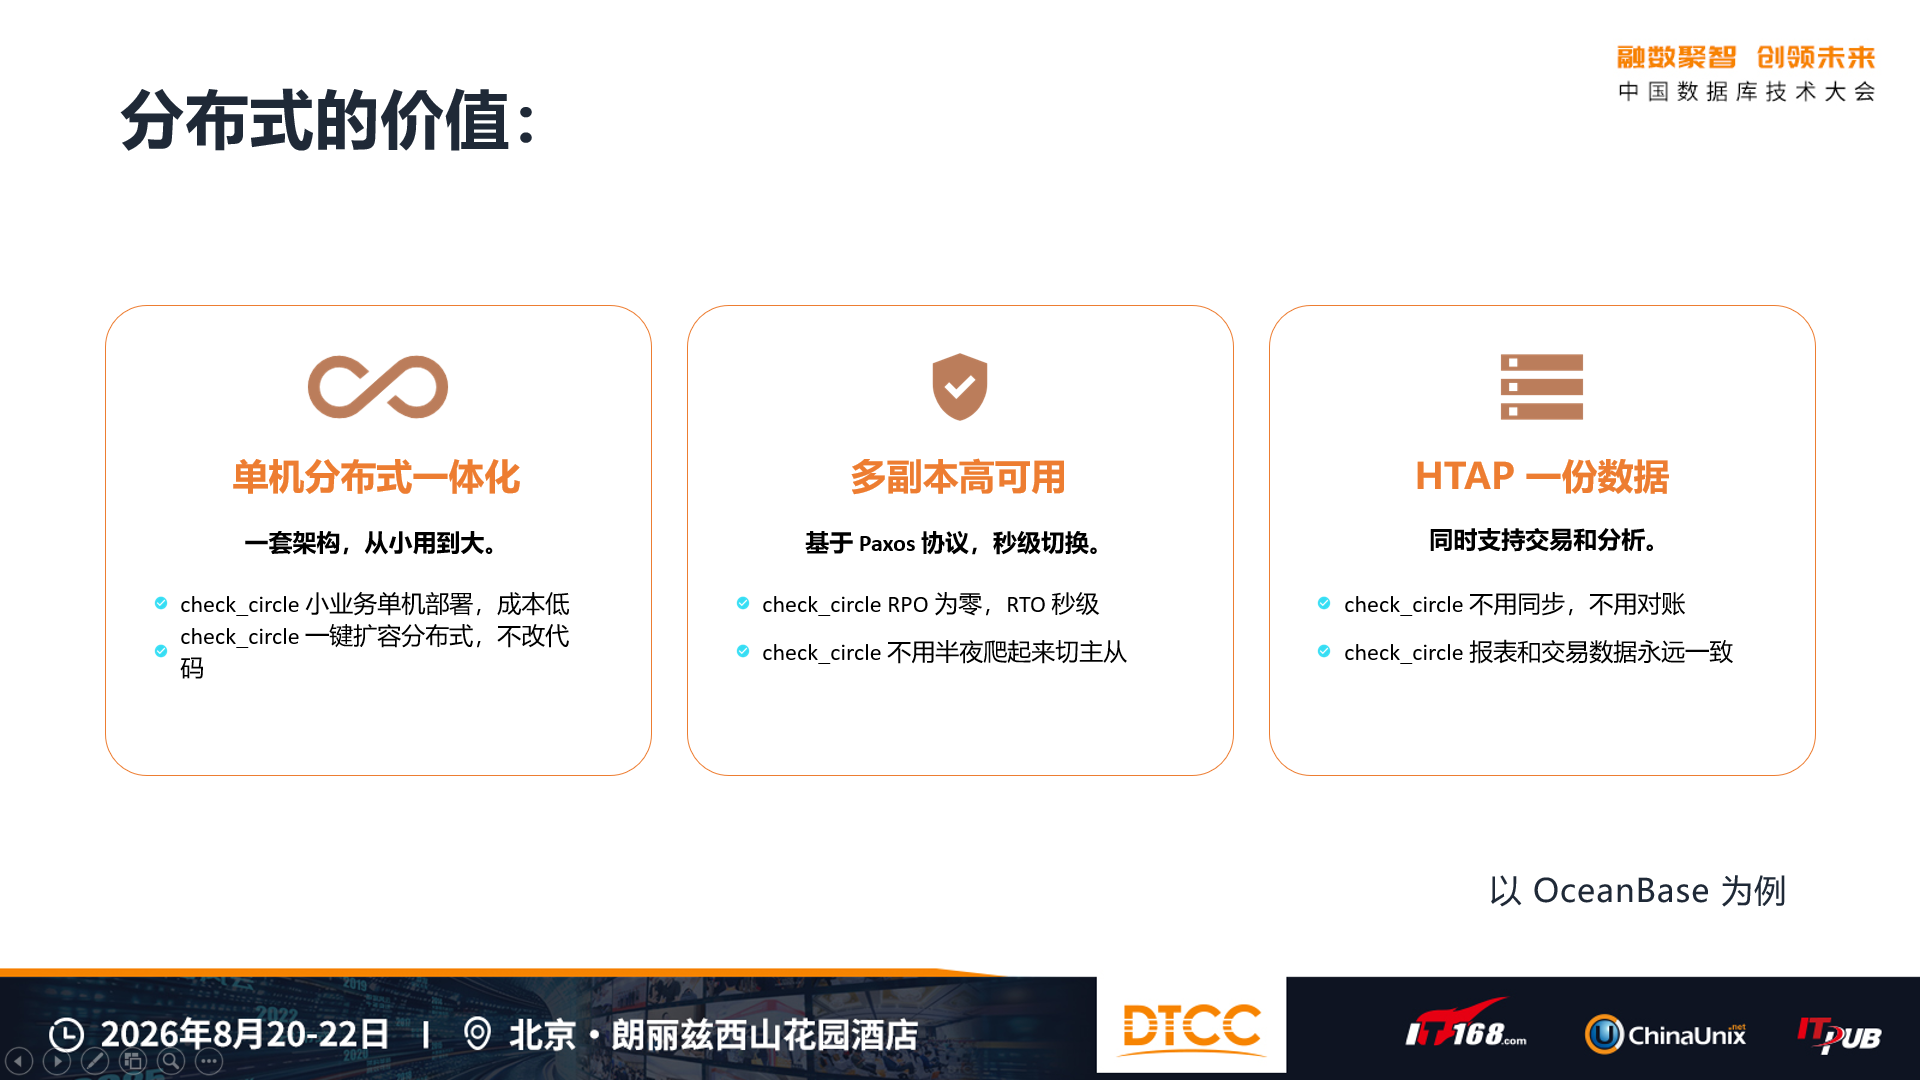
以 OceanBase 为例,单机分布式一体化,小业务单机部署成本低,一键扩容分布式不改代码;多副本高可用基于 Paxos 协议,RPO 为零,RTO 秒级—— 至少不用半夜爬起来切主从了。
03 | 三大"渡劫名场面",你中了几条?
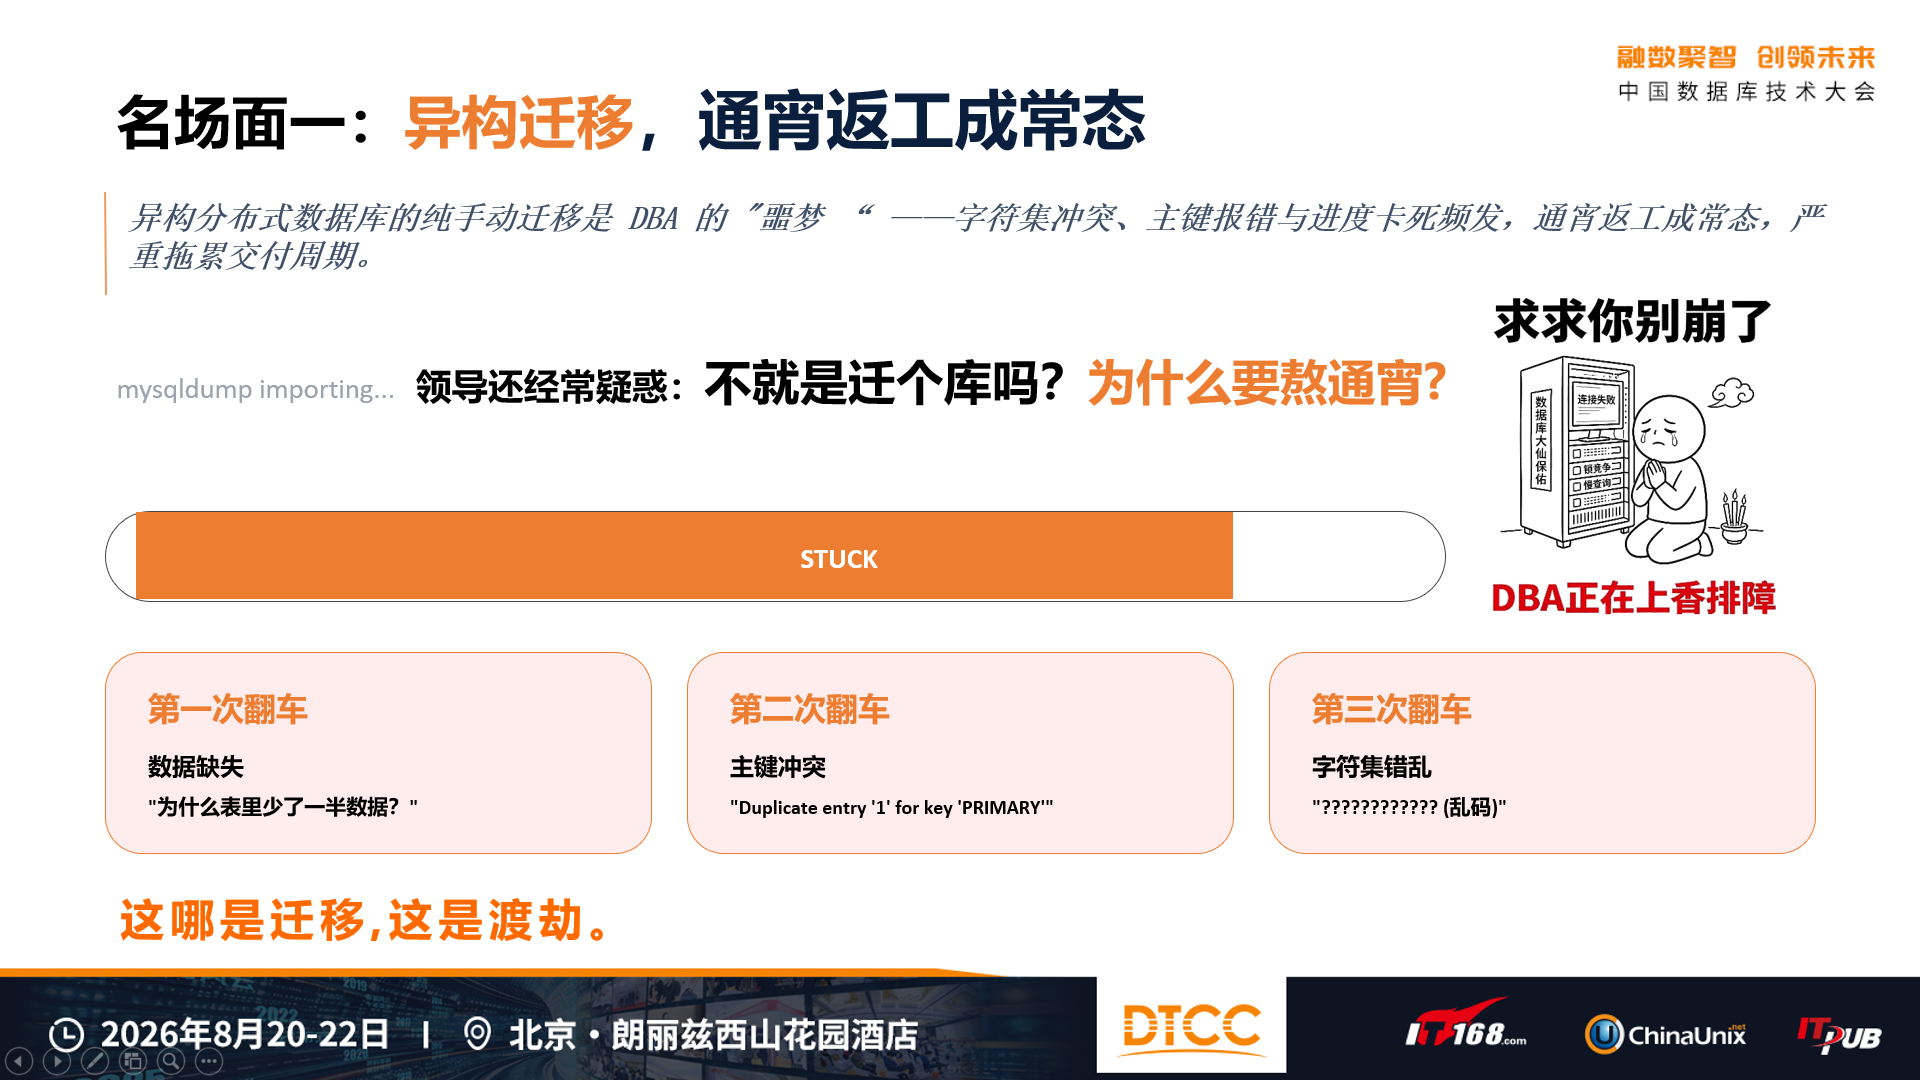
🛑 名场面一:异构迁移,通宵返工成常态
第一次翻车:数据缺失。“为什么表里少了一半数据?”
第二次翻车:主键冲突。“Duplicate entry ‘1’ for key ‘PRIMARY’”
第三次翻车:字符集错乱。“???(乱码)”
有次用 mysqldump 导 100G 数据,进度条卡在 87%,快两个小时没动。那个 87%,就像薛定谔的进度条—— 你永远不知道它是快好了,还是永远到不了 100% 了。
领导还经常疑惑:不就是迁个库吗?为什么要这么久还熬通宵了?
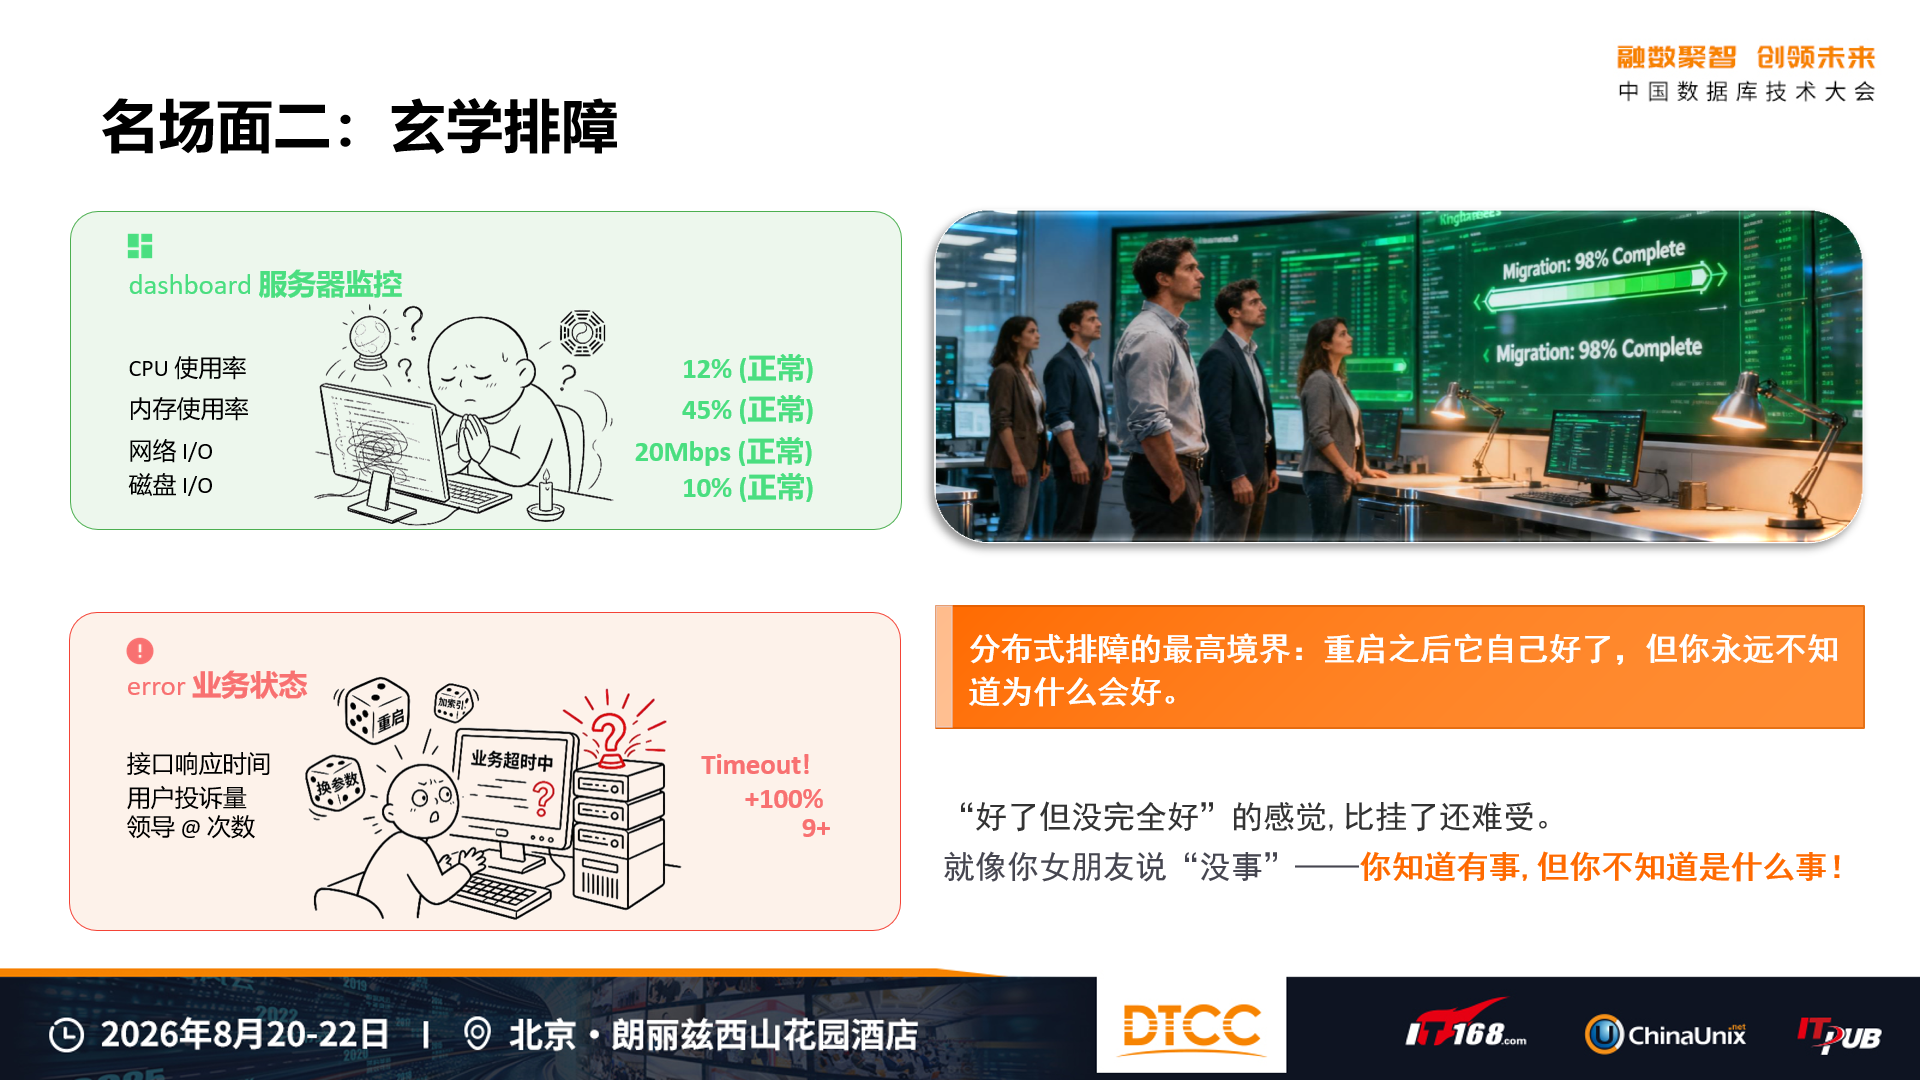
🛑 名场面二:玄学排障
所有监控面板一片翠绿:CPU 12%、内存 45%、网络 I/O 20Mbps、磁盘 I/O 10%——全正常。
但业务接口疯狂超时,用户投诉量 +100%,领导 @ 次数 9+。
你对着几十个分片的日志翻了三个小时,找不到根因。因为没有统一的负载快照工具,没有跨分片的慢 SQL 聚合分析,没有分布式链路追踪。
分布式排障的最高境界: 重启之后它自己好了,但你永远不知道为什么会好。
这种"好了但没完全好"的感觉,比挂了还难受。就像你女朋友说"没事"——你知道有事,但你不知道是什么事。
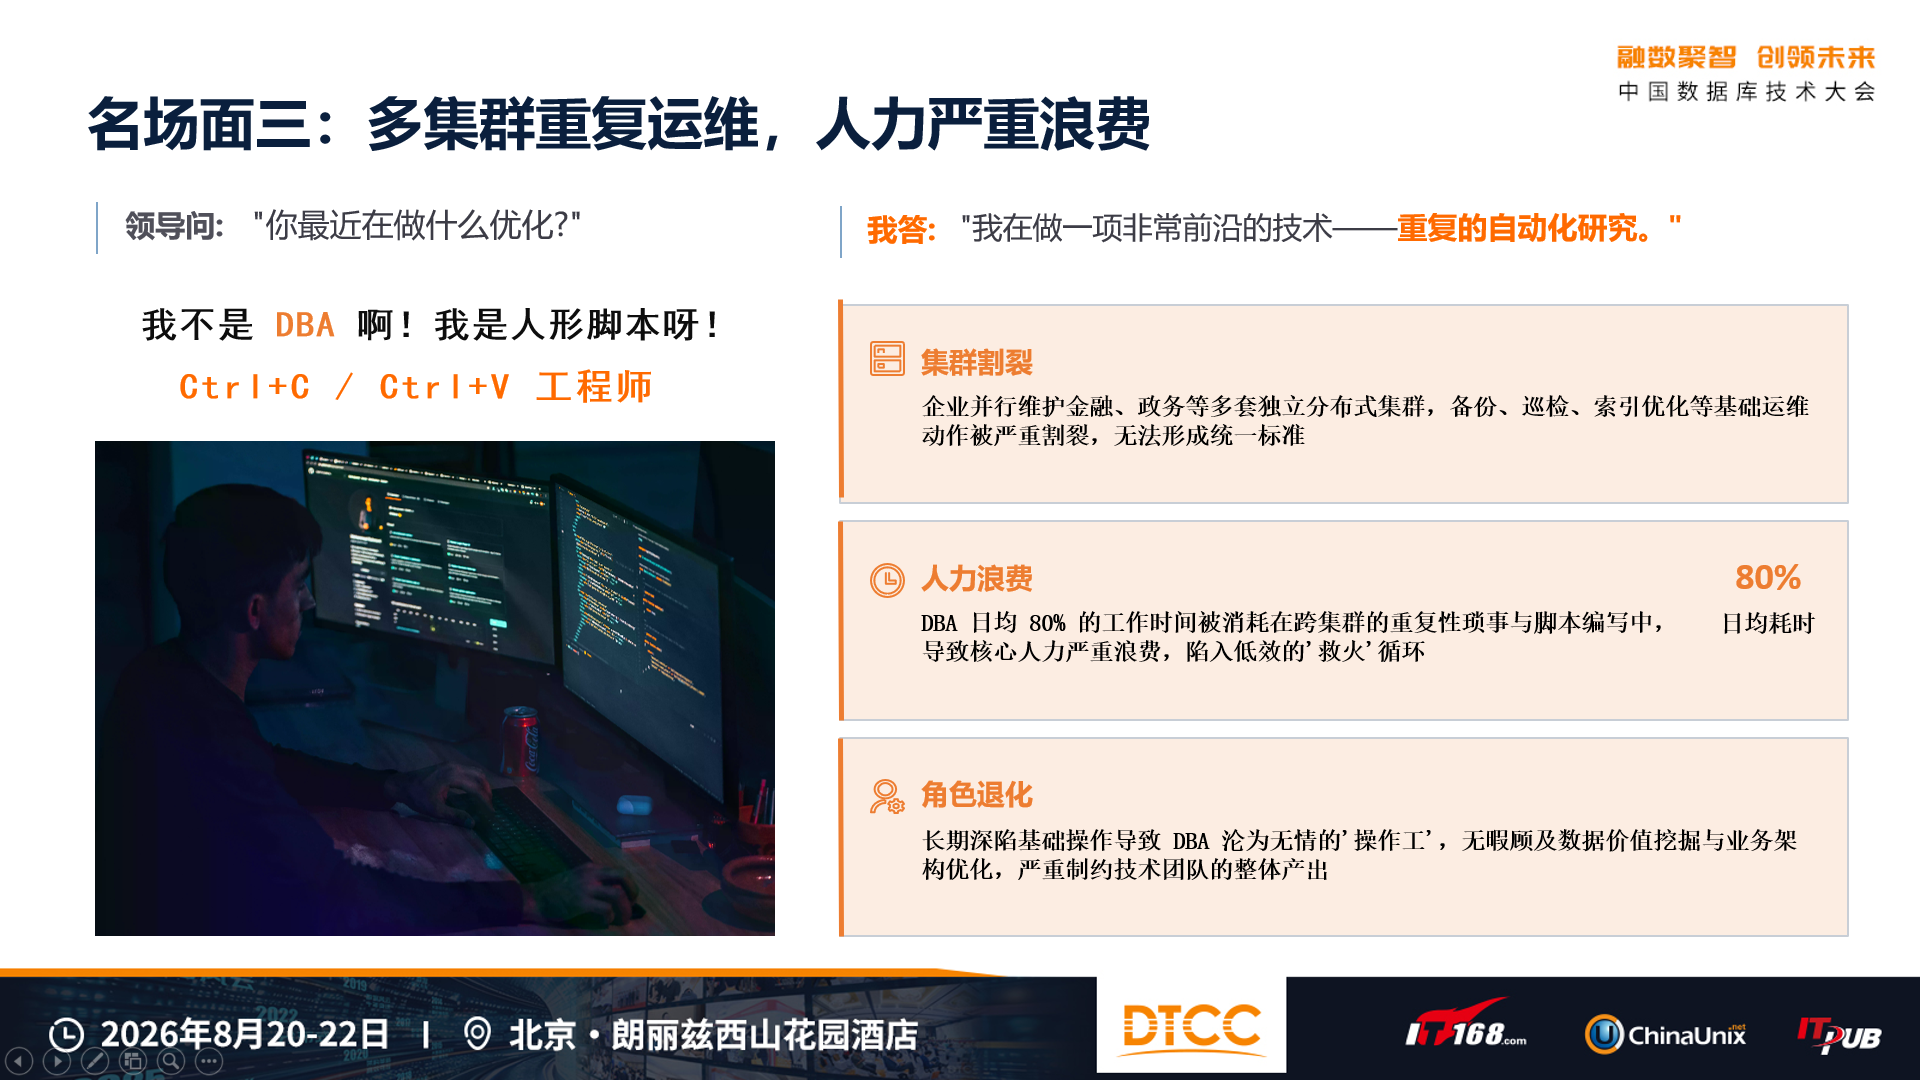
🛑 名场面三:重复运维,人力严重浪费
我手上同时维护金融、政务多套分布式集群。每天早上:金融集群备份 → 政务集群备份 → 金融集群巡检 → 政务集群巡检。
一模一样的操作,做两遍。
DBA 日均 80% 的工作时间被消耗在跨集群的重复性琐事与脚本编写中。
我不是 DBA。我是 人形脚本。还是不带循环语句的那种。
领导问:“你最近在做什么优化?”
我答:“我在做一项非常前沿的技术——重复的自动化研究。”
四大核心困境
| 维度 | 过去 | 现在 |
|---|---|---|
| 监控 | 看一个总面板 | 盯一墙子节点面板,碎片化 |
| 排障 | 查单库日志 | 排查几十节点海量日志,海量化 |
| 迁移 | 简单导出导入 | 全链路分片追踪校验,复杂化 |
| 人员 | 技术架构专家 | 熬夜体力劳动者,体力化 |
04 | 分布式不是万.能药——选型先想清楚三笔账
4.1 选数据库跟相亲一样: 没有最好的,只有最合适的。
领导拍板"上分布式!"之前,没人帮你算这三笔账:
- 业务账:真的需要分布式吗?还是大家都上了,所以你也要上?
- 团队账:团队有能力运维吗?出了事有人能处理吗?
- 规模账:存量几百 GB 硬上分布式,跟开卡车去买菜有什么区别?
4.2 选型心法:
第一,看场景,不看参数。 纯金融核心 OLTP、实时 HTAP、存量 PG 信创迁移,各有各的最优解。发布会上的 PPT 那是别人的孩子,长得再好看,也得你家养得起。
第二,看团队,不看发布会。 产品 90 分,团队 hold 不住,落地就是 0 分。团队要是没 DBA hold 住,就是电子垃圾。
第三,看验证,不看宣传。 没有"零成本迁移"。宣传是别人的,锅是你自己的。迁移之前不验证,上线之后你就是这个公司最稳定的背锅位。
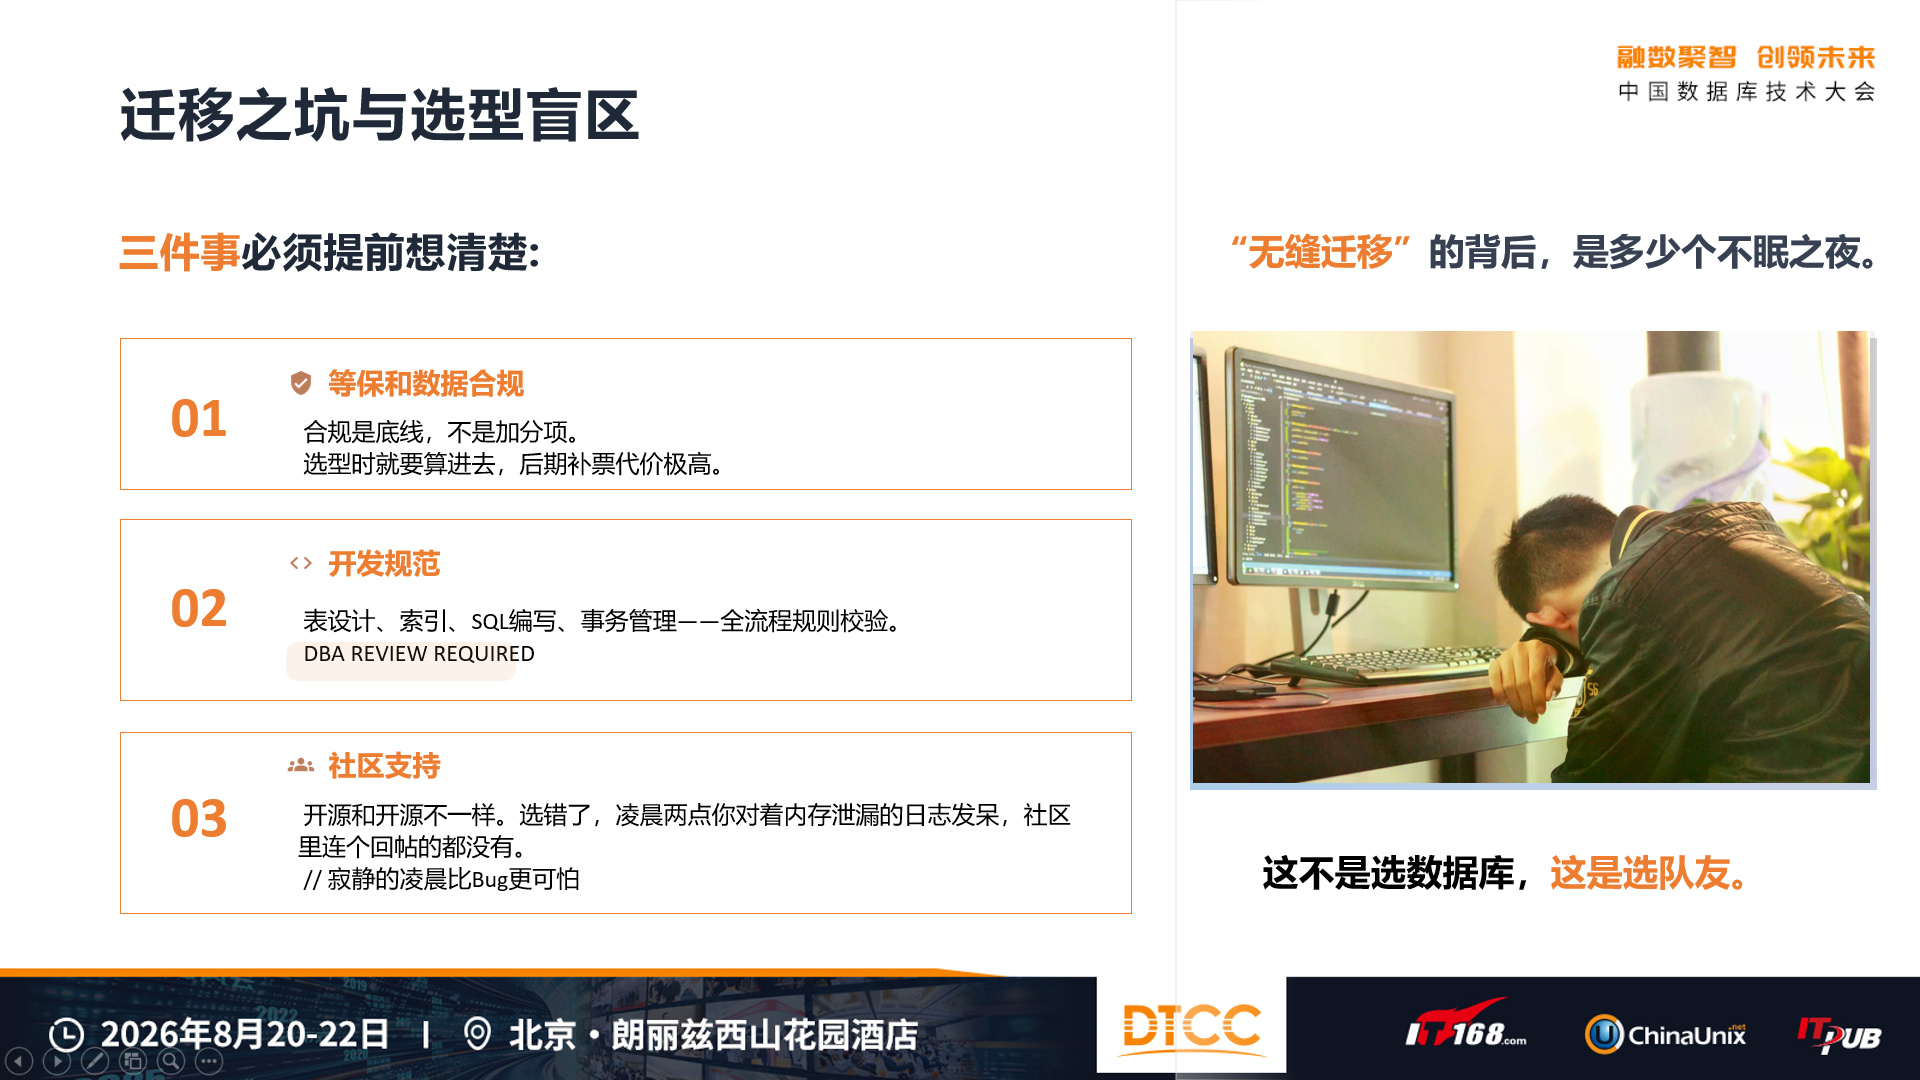
4.3 三件事必须提前想清楚:
等保和数据合规(合规是底线,不是加分项)
开发规范(表设计、索引、SQL 编写、事务管理全流程规则校验)
社区支持(凌晨两点你对着内存泄漏的日志发呆,社区里连个回帖的都没有——寂静的凌晨比 Bug 更可怕)。
05 | KDTS:从"通宵"到"20 分钟"
那个让我失眠的 87%,后来被一个工具终结了。
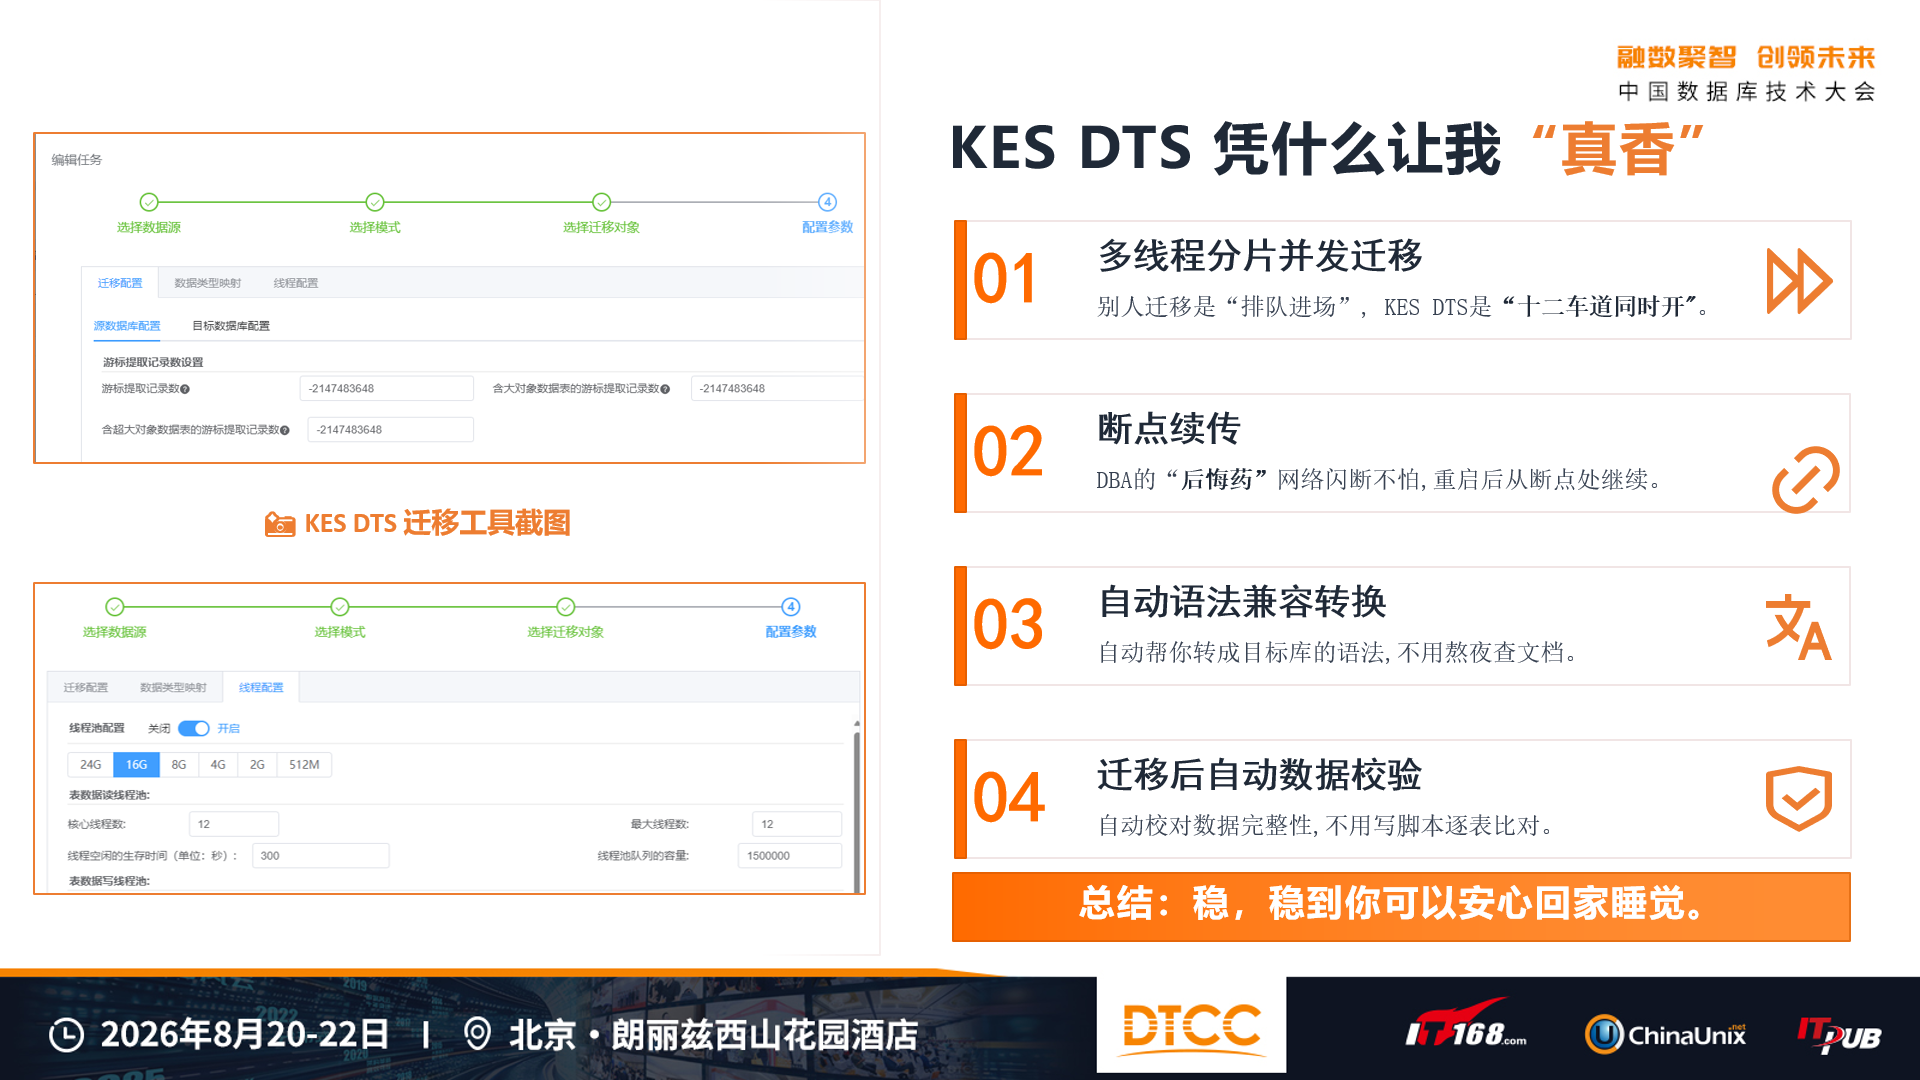
我以金仓KDTS为例,四大核心能力:
- 多线程分片并发迁移——别人迁移是"排队进场",KDTS 是"十二车道同时开"
- 断点续传——DBA 的"后悔药",网络闪断不怕,重启后从断点处继续
- 自动语法兼容转换——MySQL 的 LIMIT、Oracle 的 ROWNUM 自动转换,不用熬夜查文档
- 迁移后自动数据校验——自动校对数据完整性,不用写脚本逐表比对
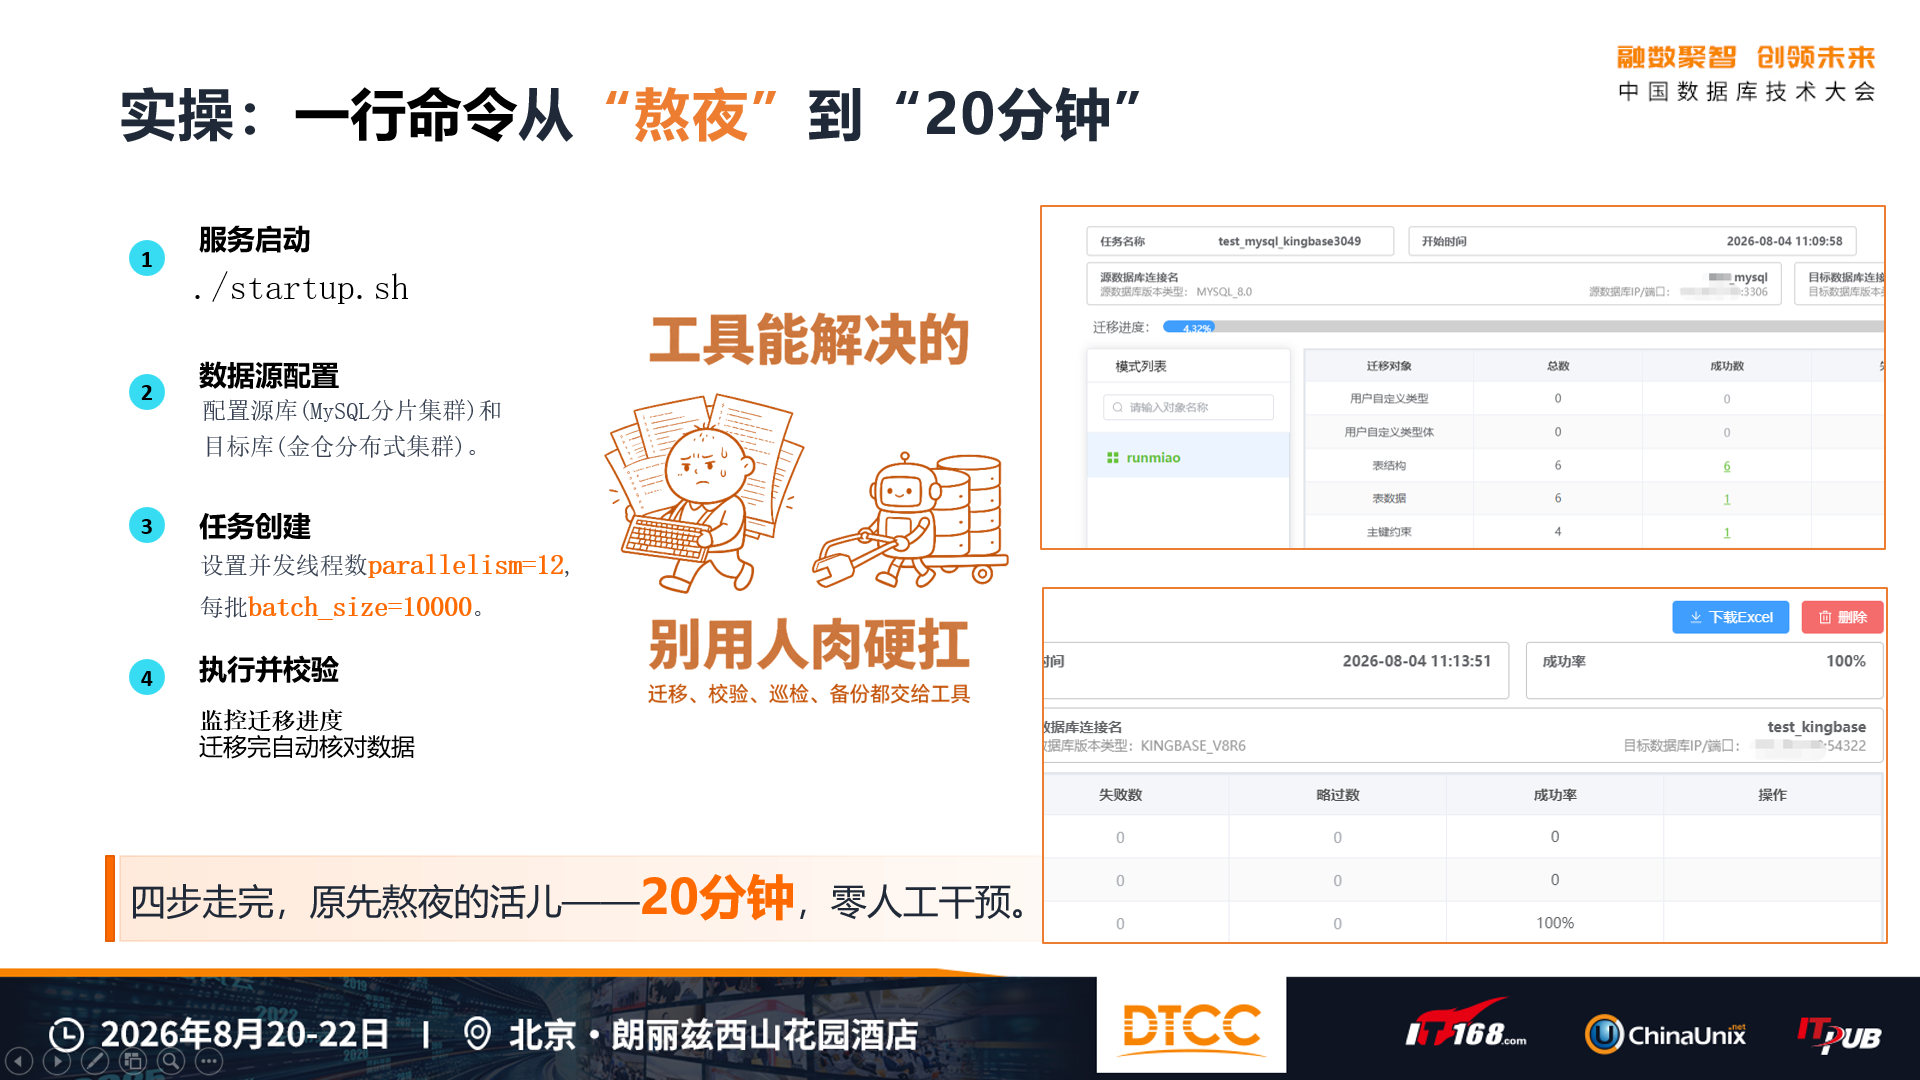
实操四步走:
# Step 1:服务启动./startup.sh# Step 2:数据源配置# 配置源库(MySQL 分片集群)和目标库(金仓分布式集群)# Step 3:任务创建# 设置并发线程数 parallelism=12, 每批 batch_size=10000# Step 4:执行迁移并校验# 监控迁移进度,迁移完自动核对数据
四步走完,原先通宵的活儿—— 20 分钟,零人工干预。
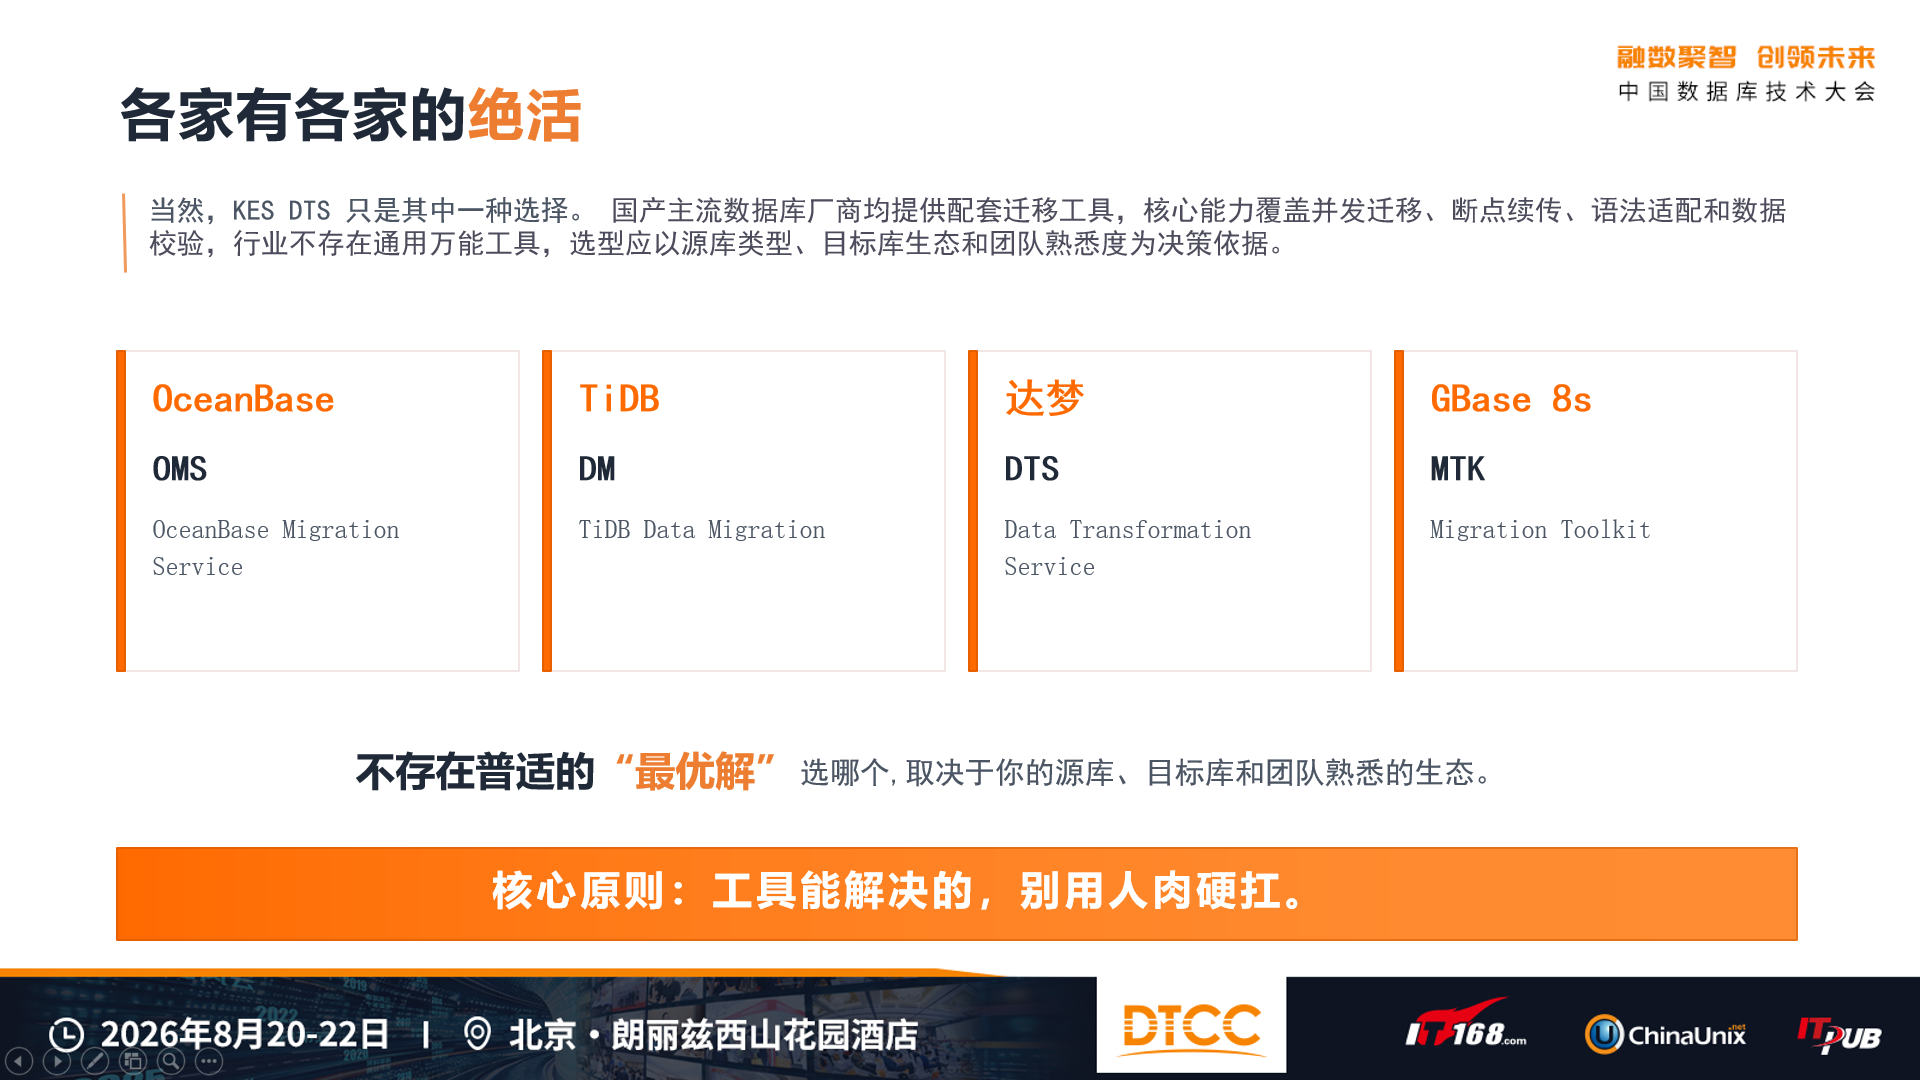
当然,KDTS只是其中一种选择。各家有各家的绝活:
| 厂商 | 工具 | 全称 |
|---|---|---|
| OceanBase | OMS | OceanBase Migration Service |
| TiDB | DM | TiDB Data Migration |
| 达梦 | DTS | Data Transformation Service |
| GBase 8s | MTK | Migration Toolkit |
核心原则:工具能解决的,别用人肉硬扛。
06 | KWR:从"玄学"到"量化"
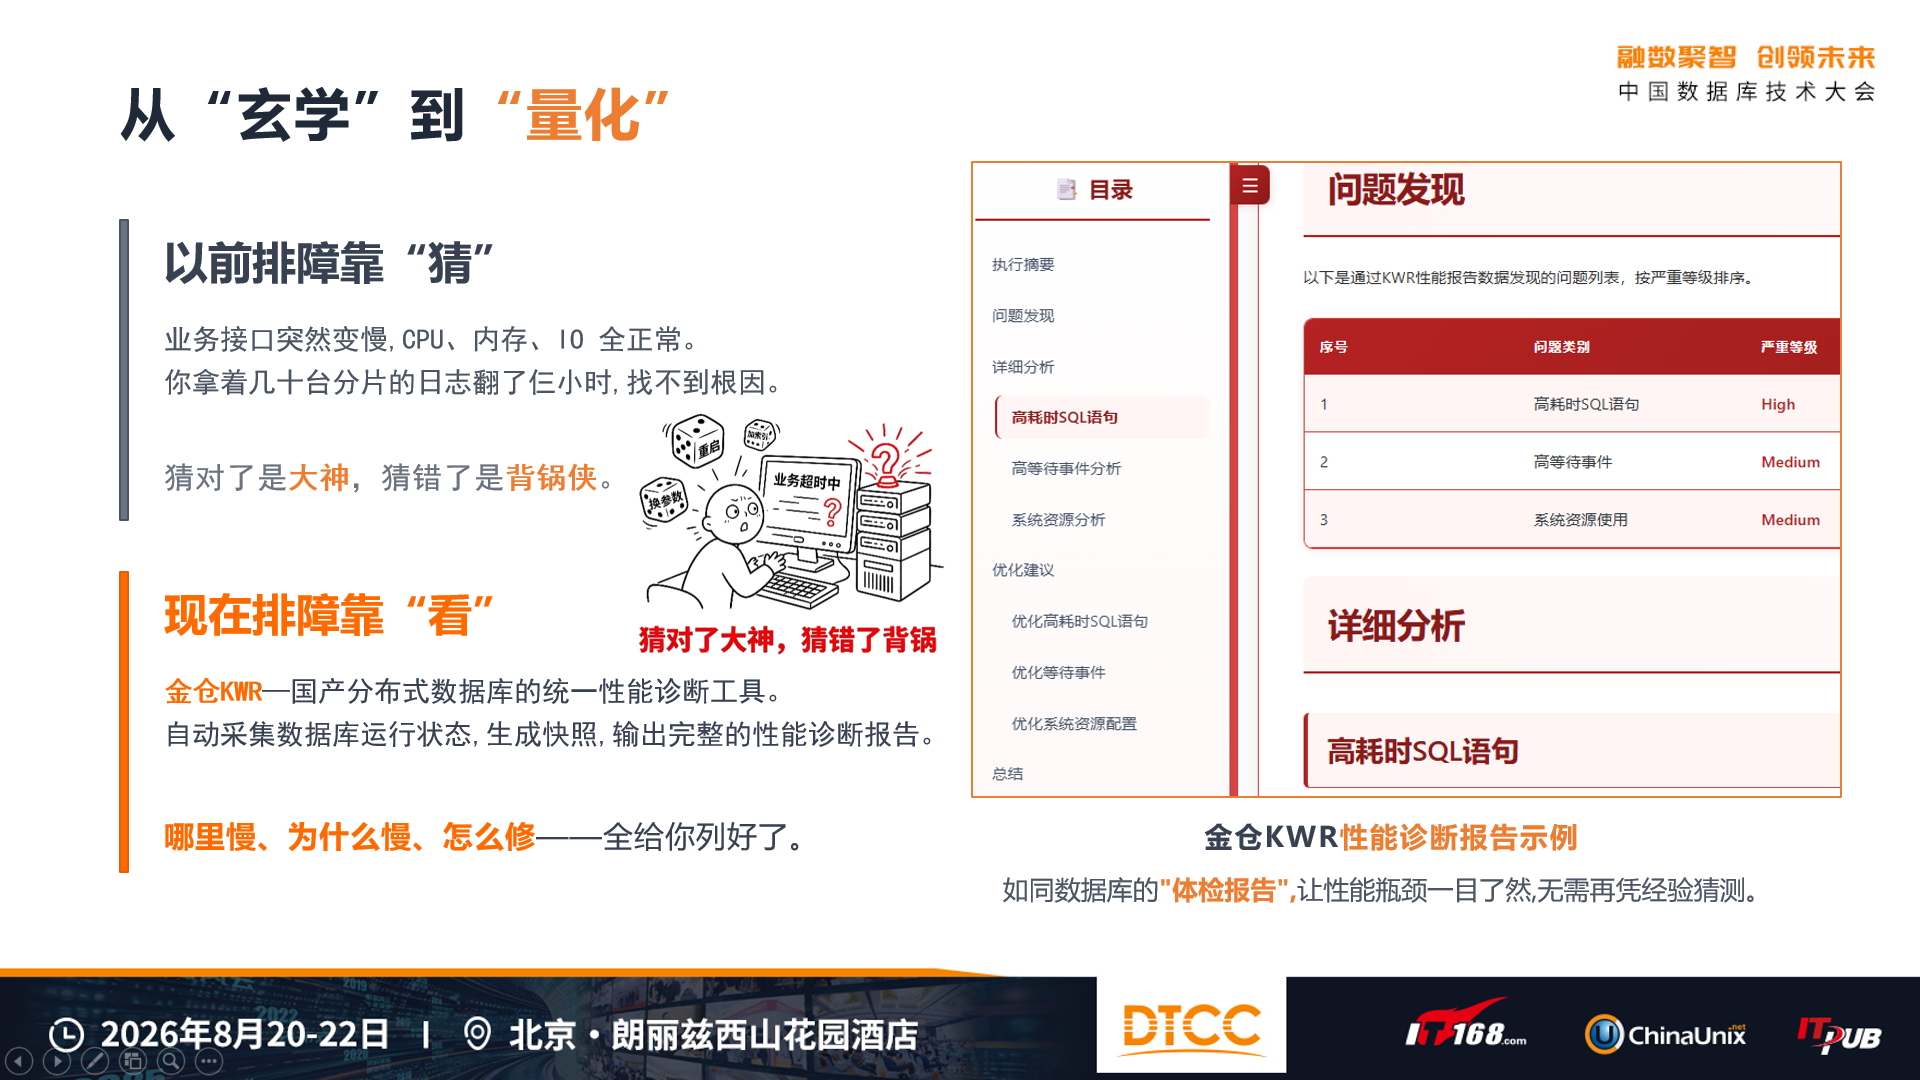
以前排障靠"猜",现在排障靠"看"。
金仓 KWR 是内置原生插件级负载快照工具,零部署零付费开箱即用,对标 AWR 企业级诊断能力, 三分钟精准定位故障根因。建议 10 分钟一次快照采集间隔,兼顾诊断精度与集群性能,快照采集几乎不占用集群资源。
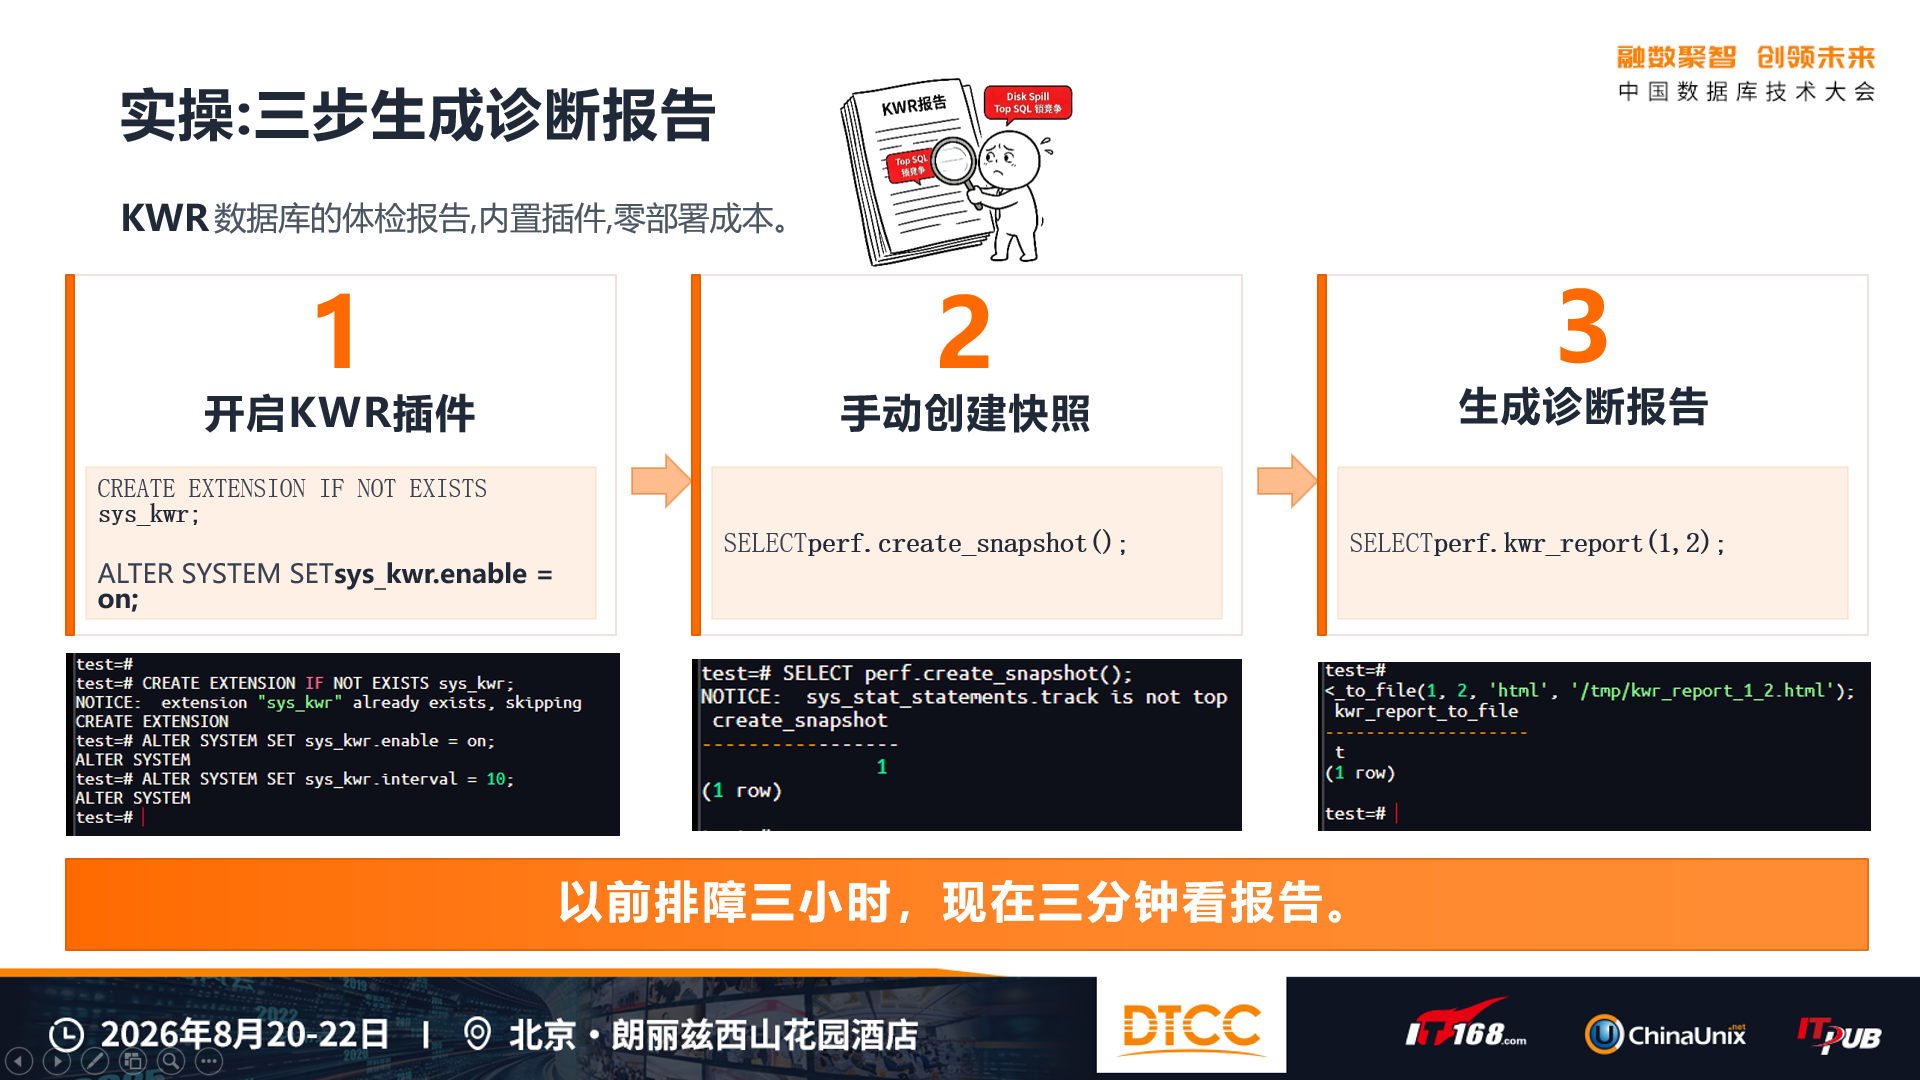
三步生成诊断报告:
-- 第一步:开启 KWR 插件CREATE EXTENSION IF NOT EXISTS sys_kwr;ALTER SYSTEM SET sys_kwr.enable = on;-- 第二步:手动创建快照SELECT perf.create_snapshot();-- 第三步:生成诊断报告SELECT perf.kwr_report(1, 2);
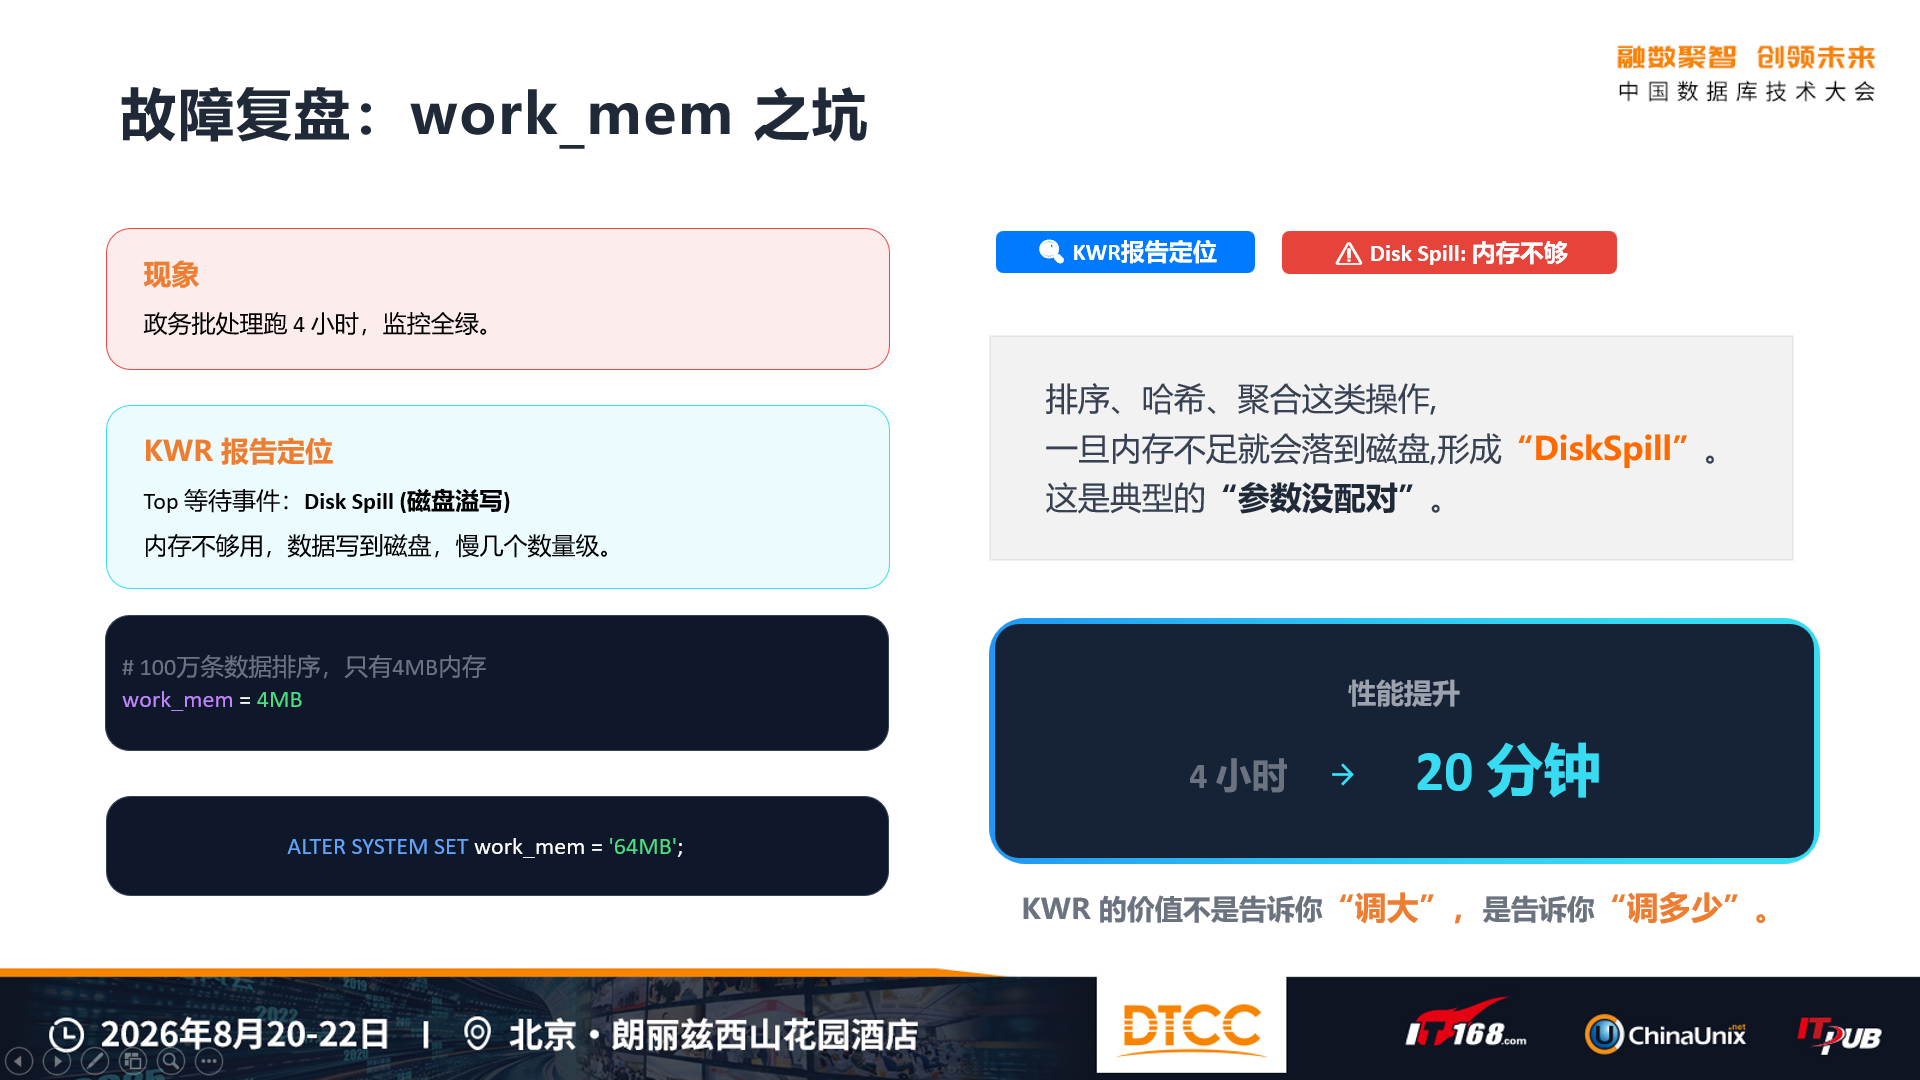
真实故障复盘:work_mem 之坑
某政务系统分布式批任务,跑了整整 4 个小时。CPU、内存、磁盘 IO 全正常,监控一片绿。
KWR 报告一看,Top 等待事件排名第一: Disk Spill(磁盘溢写)——内存不够用,数据写到磁盘,慢几个数量级。
根因:
work_mem = 4MB。100 万条数据排序、哈希、聚合——4MB 内存够干什么的?
ALTER SYSTEM SET work_mem = '64MB';
修改前: 4 小时 → 修改后: 20 分钟。
KWR 的价值不是告诉你"调大",是告诉你"调多少"。
07 | AI 自治运维:DBA 的"新同事"来了
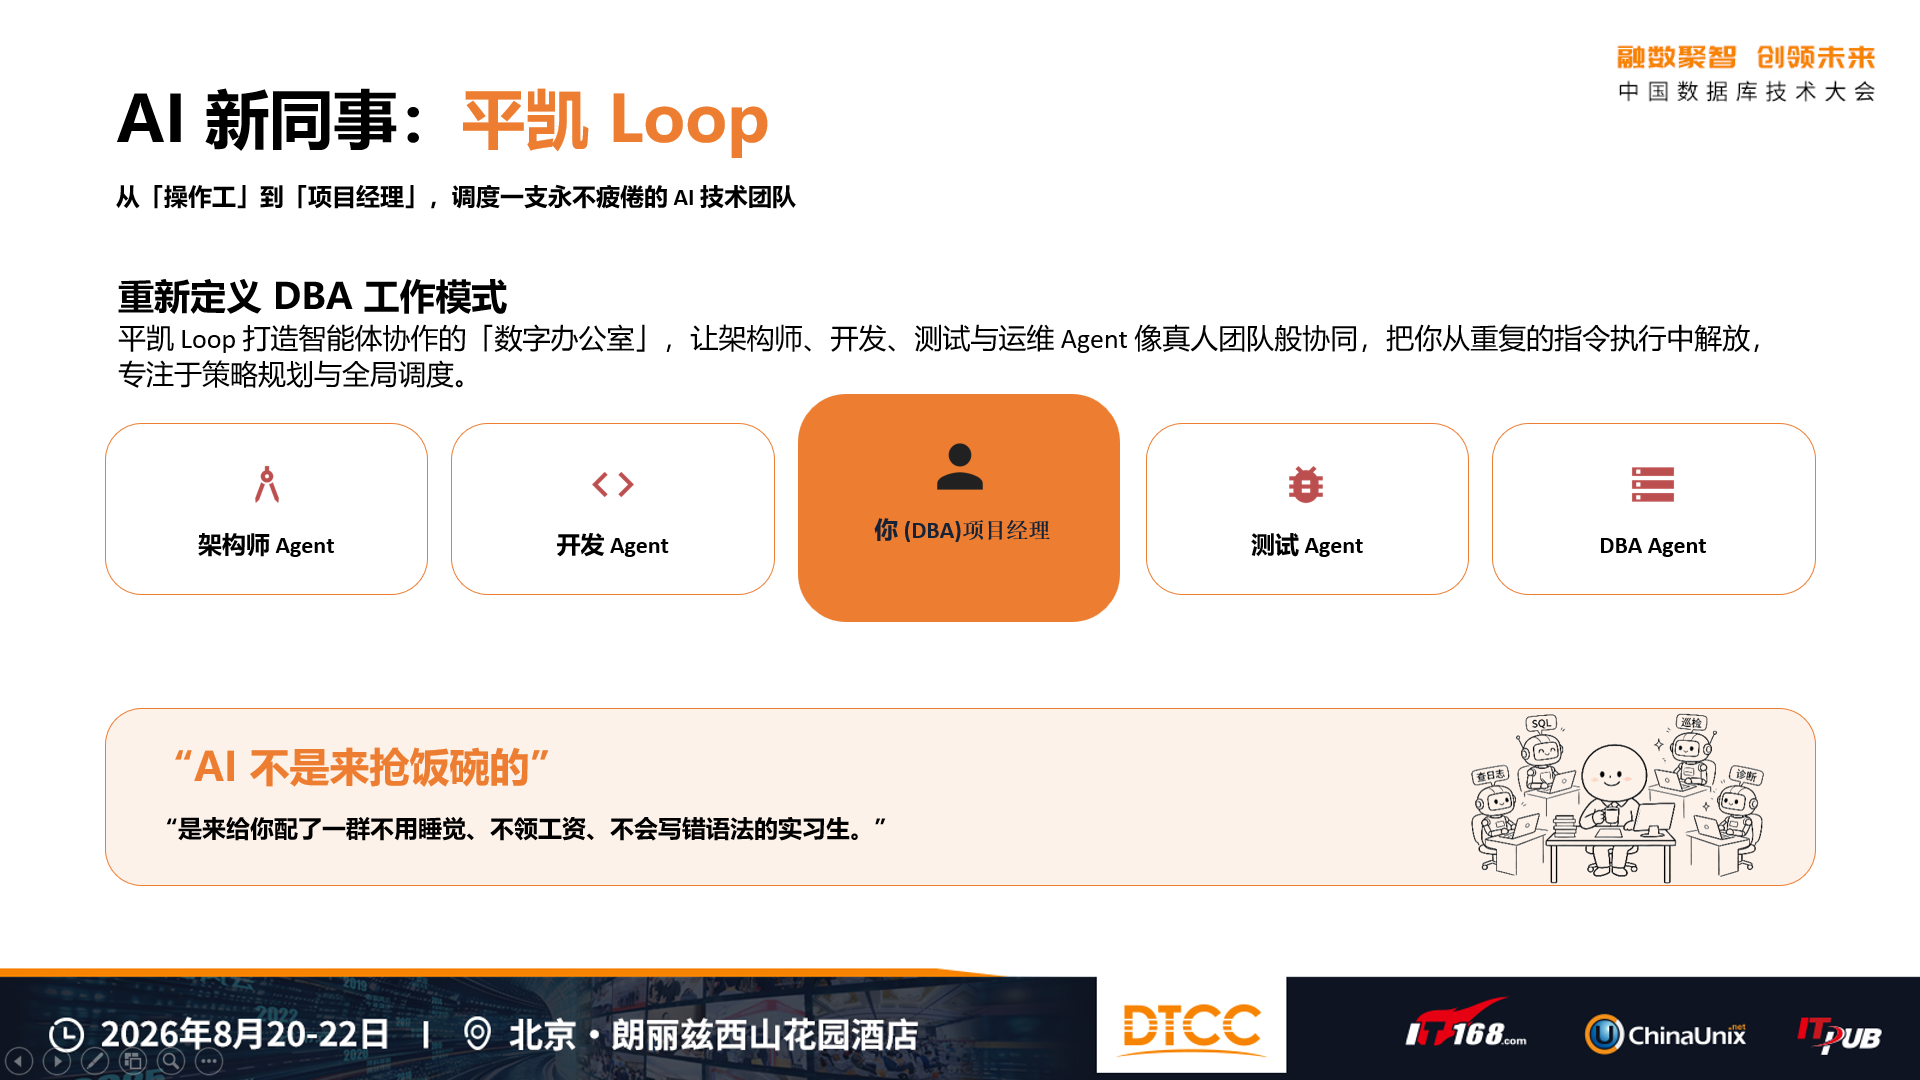
说句实在话: AI 不是来抢饭碗的,是来给你配了一群不用睡觉、不领工资、不会写错语法的实习生。
平凯 Loop:从"操作工"变成"项目经理"
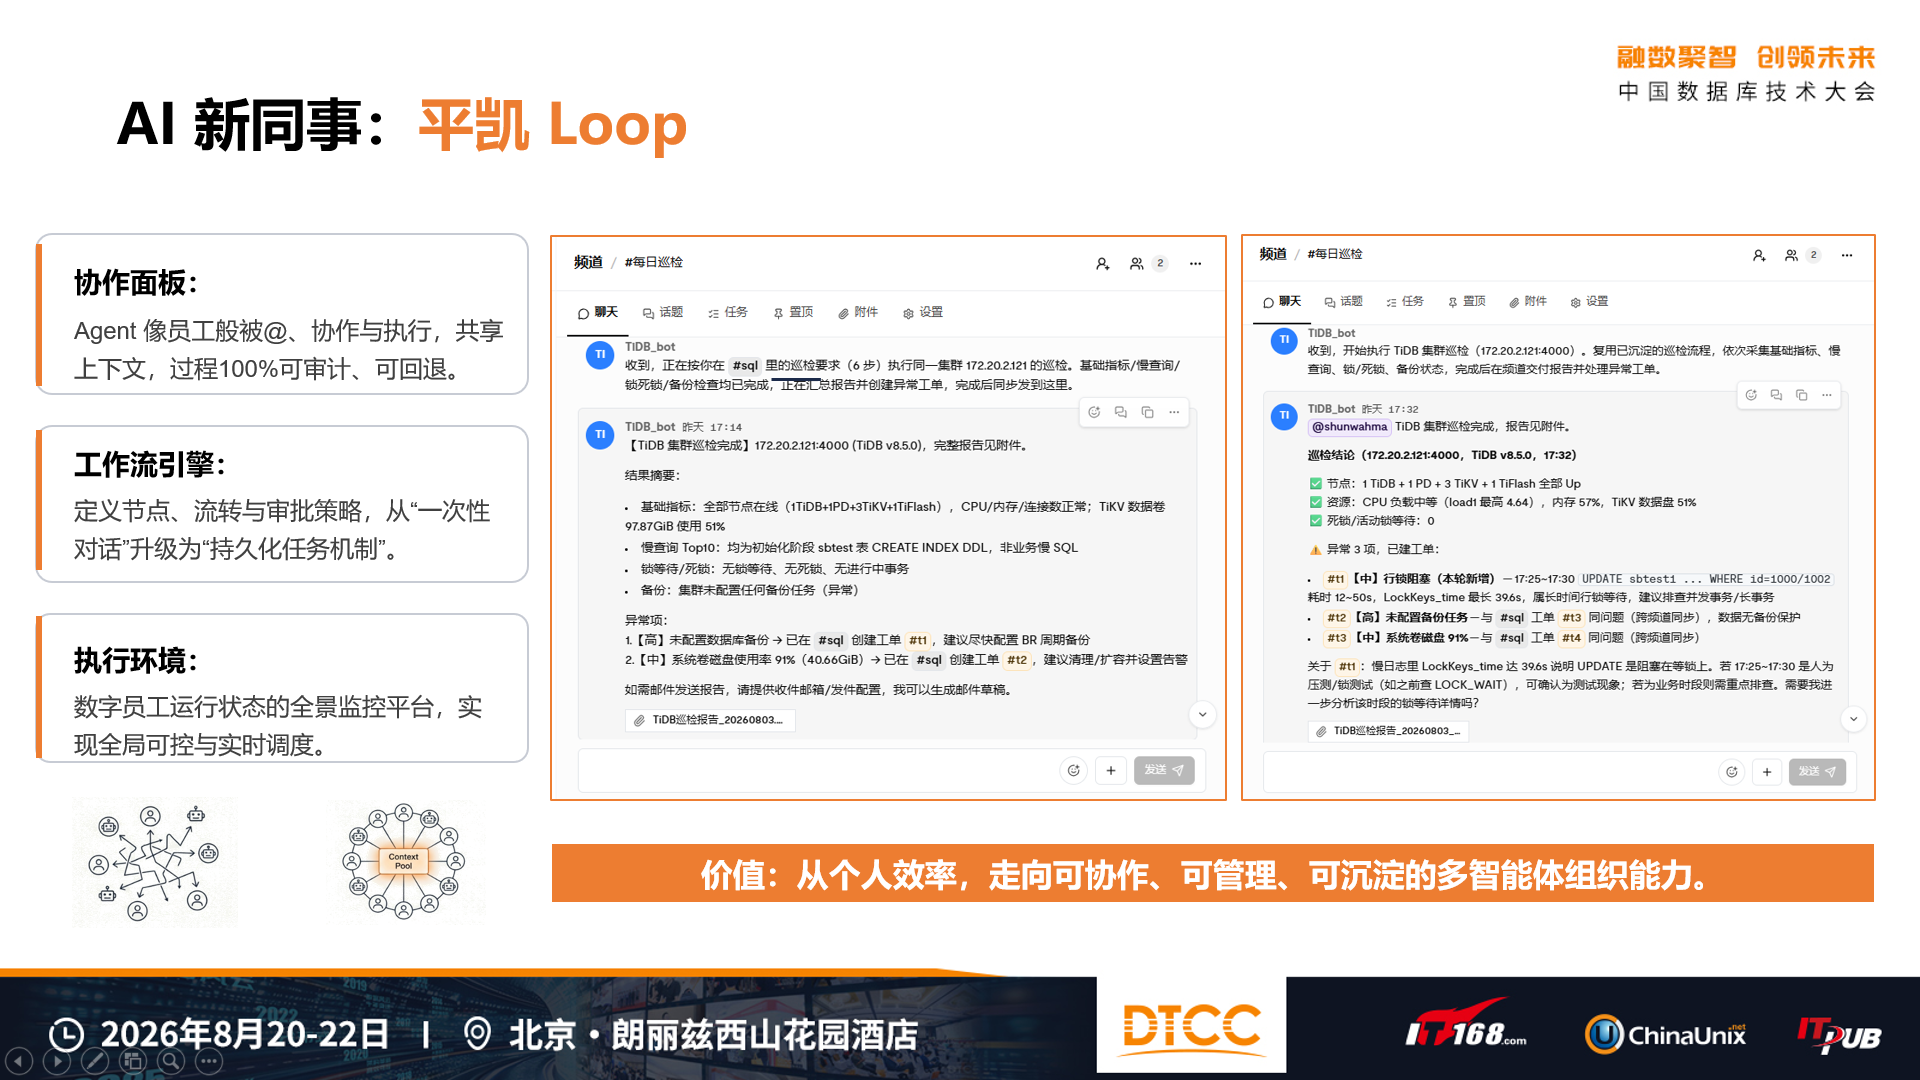
在这里,多个专业化的AI Agent像真人同事一样组队工作——架构师Agent负责设计,开发Agent负责编码,测试Agent负责部署,DBA Agent负责SQL优化。
飞书告警触发后,平凯Loop自动接管:从告警发现 → AI介入分析 → 自动执行排障与修复,实现从被动响应到主动治理的闭环。
你负责拍板,他们负责执行。 从"操作工"到"项目经理",调度一支永不疲倦的AI技术团队。
当然,多智能体协作的本质挑战也在这里:多维协同、长程任务、权限隔离与业务全链路的可靠运转——记忆上下文持久化、多Agent编排协作、工具系统深度集成、安全合规数据主权、可观测性结果验证。缺一环,就翻车。
金仓 MCP Server:给 AI 装一双眼睛
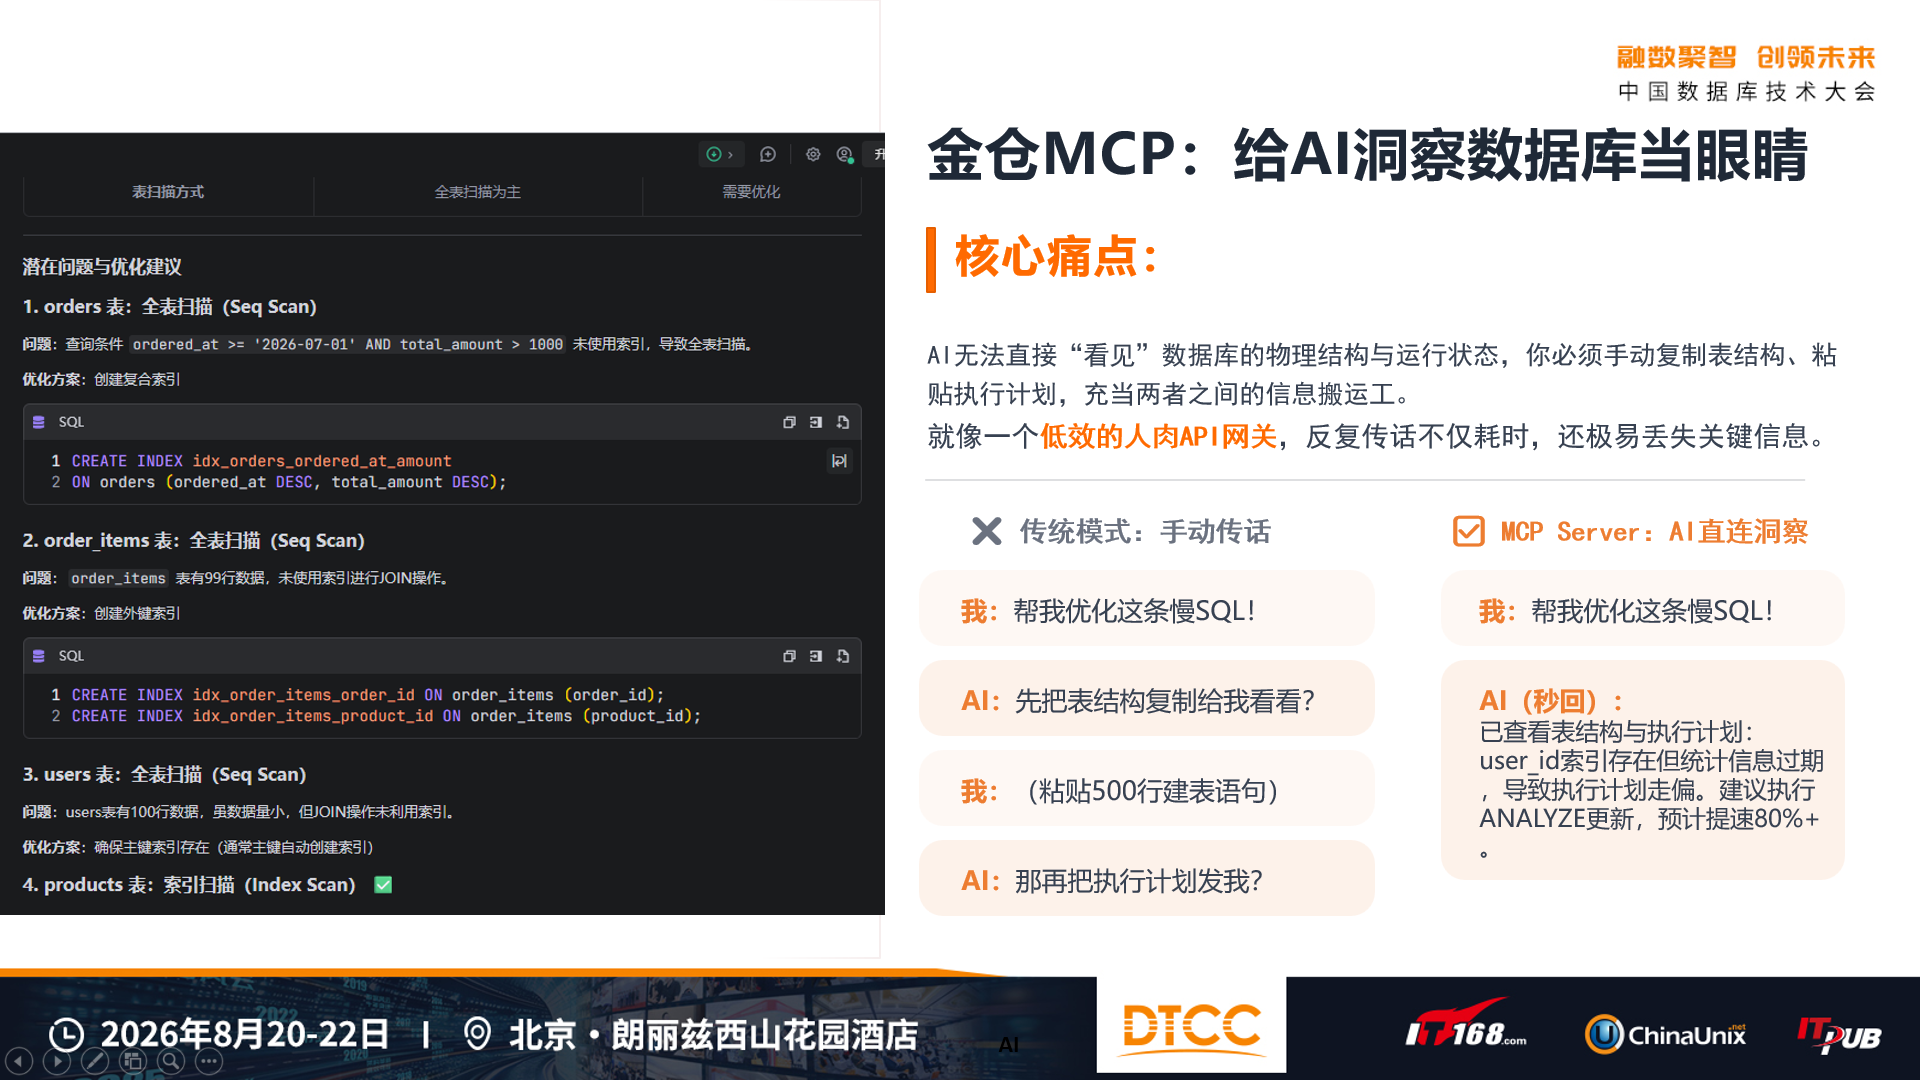
以前让AI写SQL,它只能"盲写"——不知道你有哪些表,不知道字段类型,不知道有没有索引。
你得先把表结构复制出来贴给AI,再把执行计划贴回去问它怎么优化—— 你就像个人肉API网关,反复传话不仅耗时,还极易丢失关键信息。
MCP Server给AI装了一个"USB-C接口"——表结构、字段类型、索引信息、执行计划,实时可见。
从此AI写SQL不再靠猜,靠的是"视力"。 实测效果:orders扫描从Seq Scan(全表)变Index Scan(索引),预估成本从22.53降至5-10。
AI vs DBA:协作而非替代
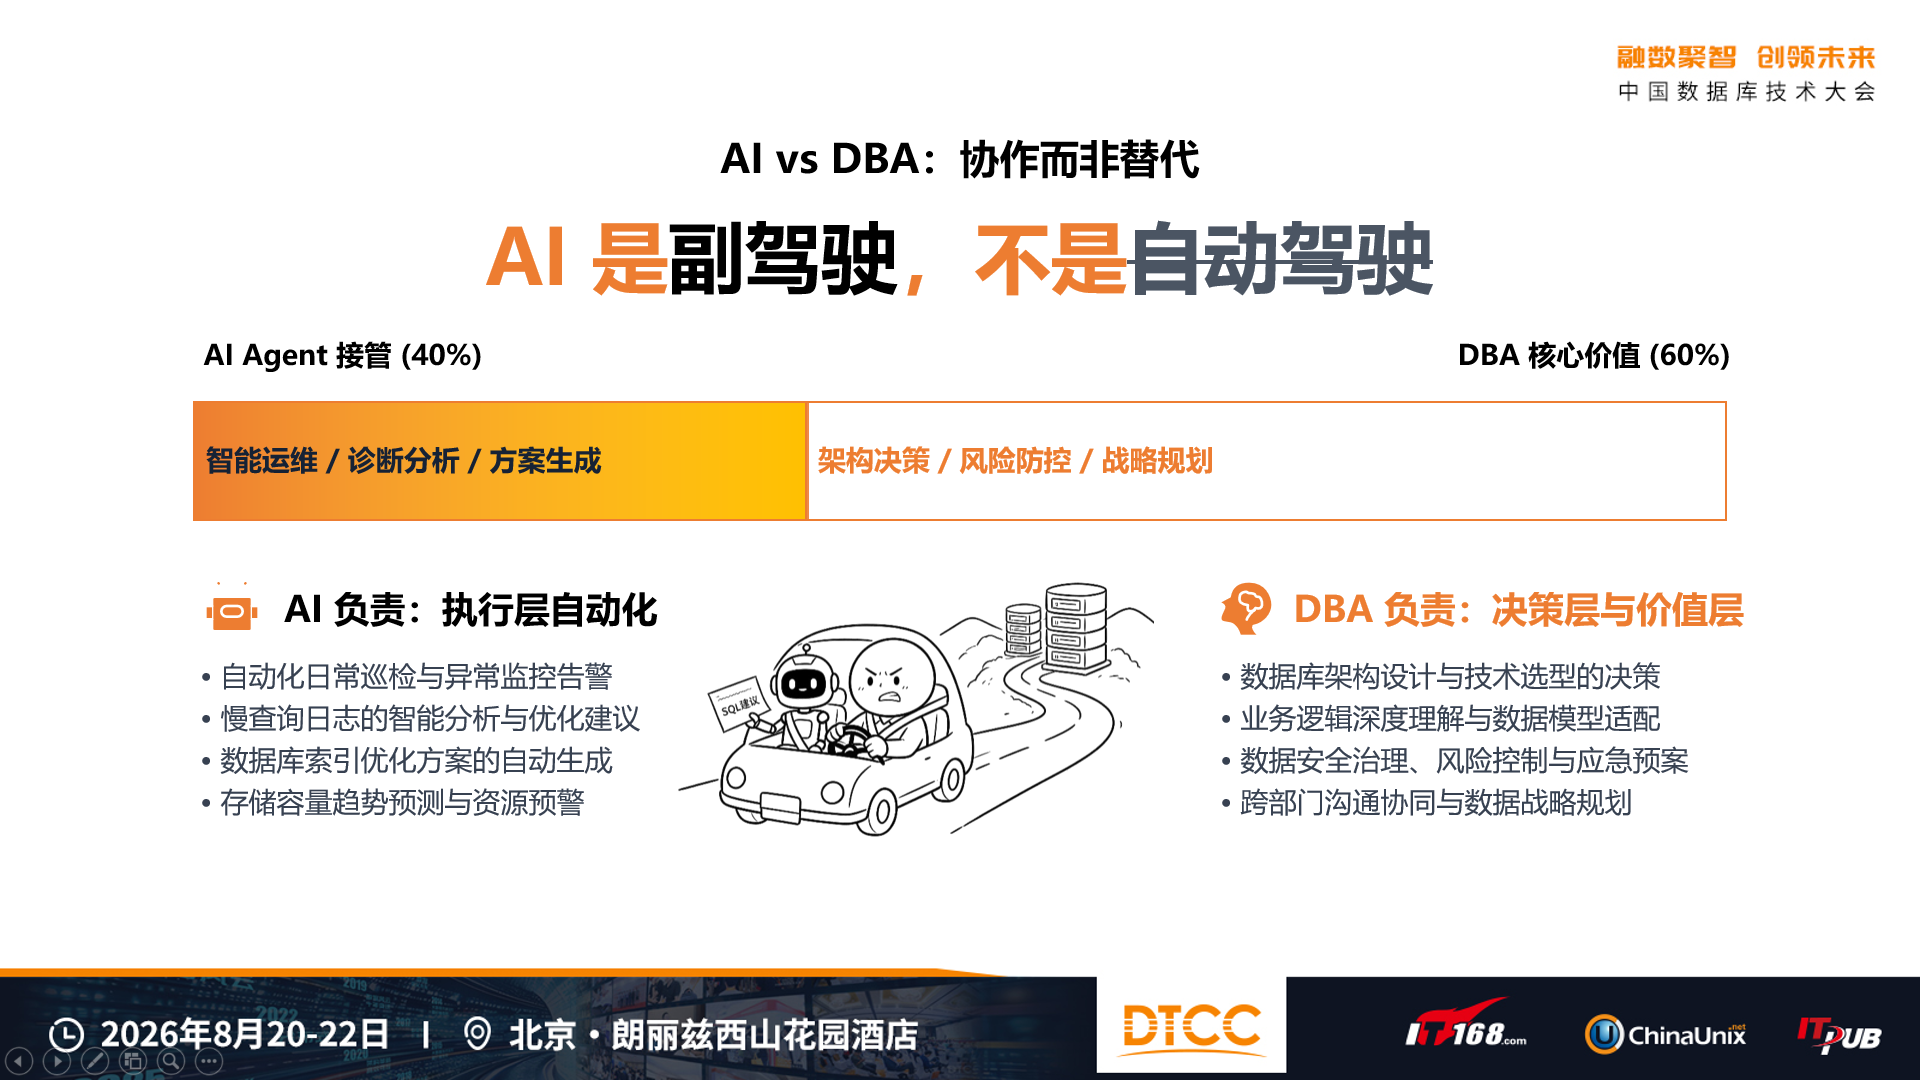
AI负责(40%)——执行层自动化:
- 自动化日常巡检与异常监控告警
- 慢查询日志的智能分析与优化建议
- 数据库索引优化方案的自动生成
- 存储容量趋势预测与资源预警
DBA负责(60%)——决策层与价值层:
- 数据库架构设计与技术选型的决策
- 业务逻辑深度理解与数据模型适配
- 数据安全治理、风险控制与应急预案
- 跨部门沟通协同与数据战略规划
AI是副驾驶,不是自动驾驶。
AI不会替代DBA。 但会用AI的DBA,会替代不会用AI的DBA。
写在最后
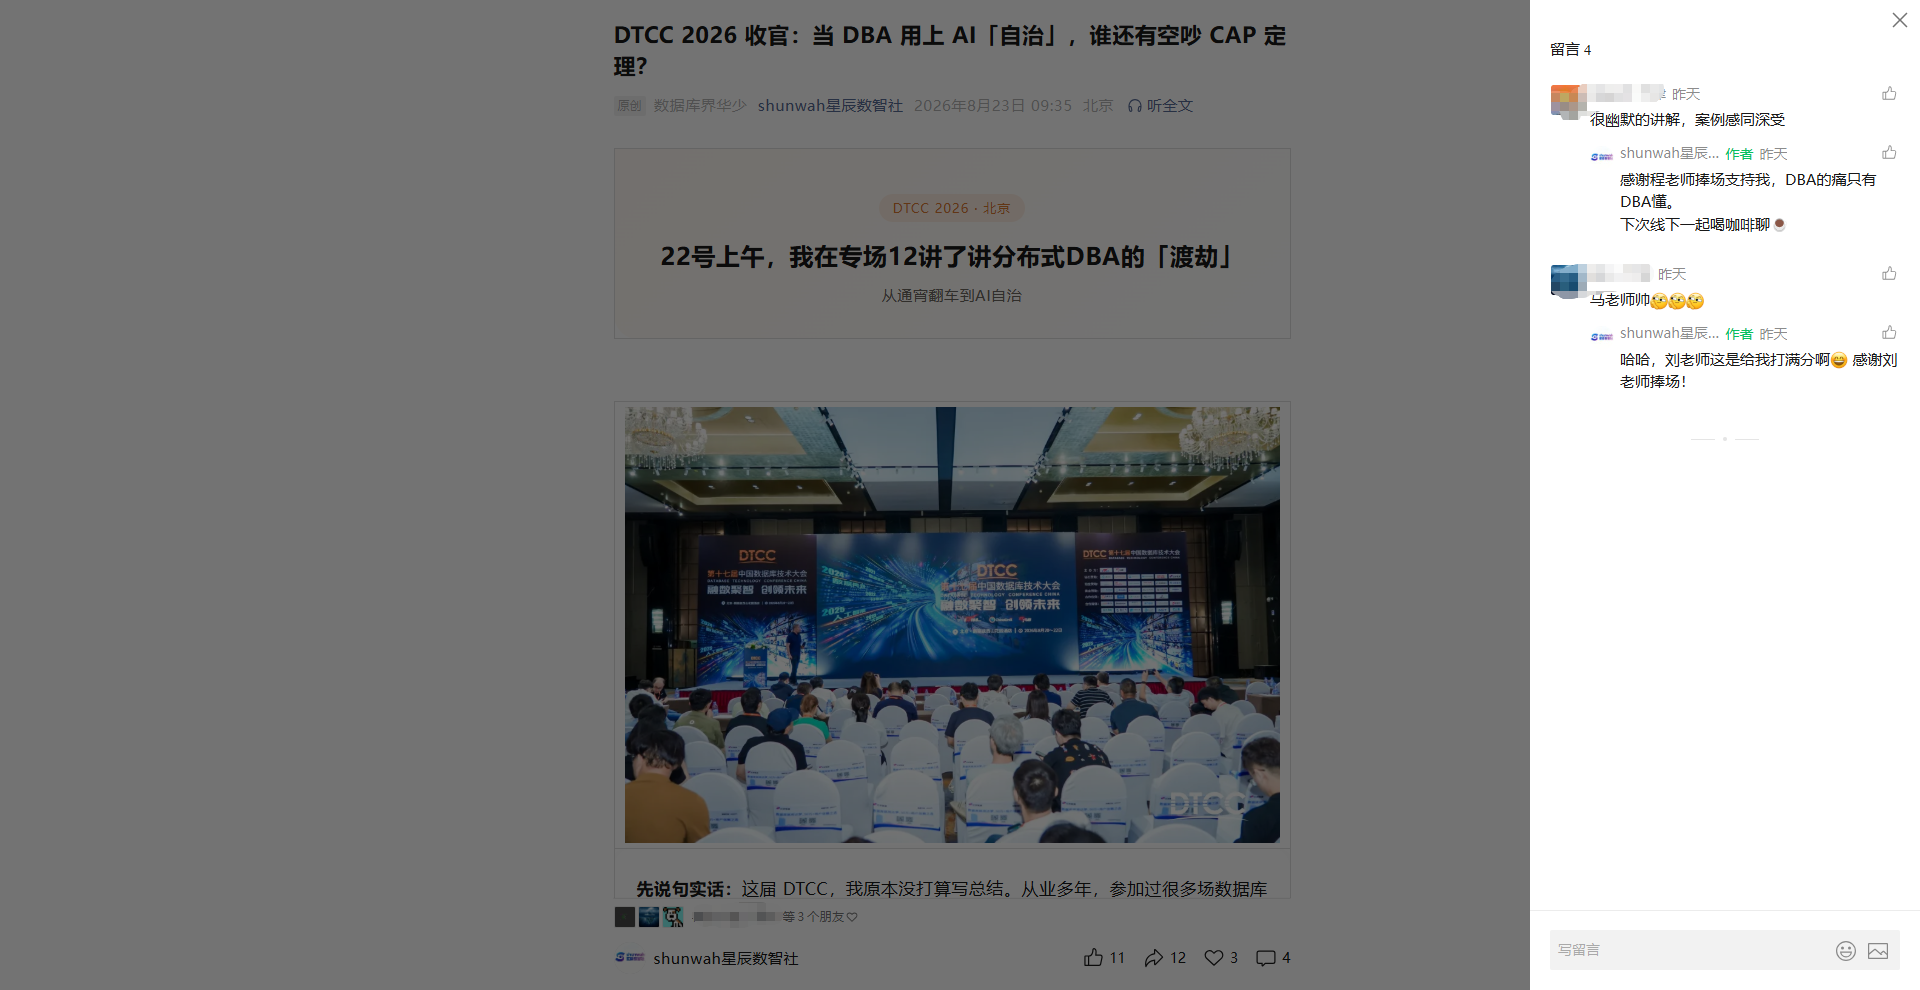
散场后,有听众过来交流:
“马老师的演讲特别贴合我的心声。”
还有好友说:
“马老师证书考了那么多,头发白了也值了哈。”
还有网友留言
“很幽默的讲解,案例感同身受。”
还有一位不愿透漏姓名的DBA跟我说:“华少,你今天讲的那个凌晨两点电话的事,跟我之前经历的一模一样。”
我知道,不是我讲得多好,是 分布式DBA的痛,大家太熟了。
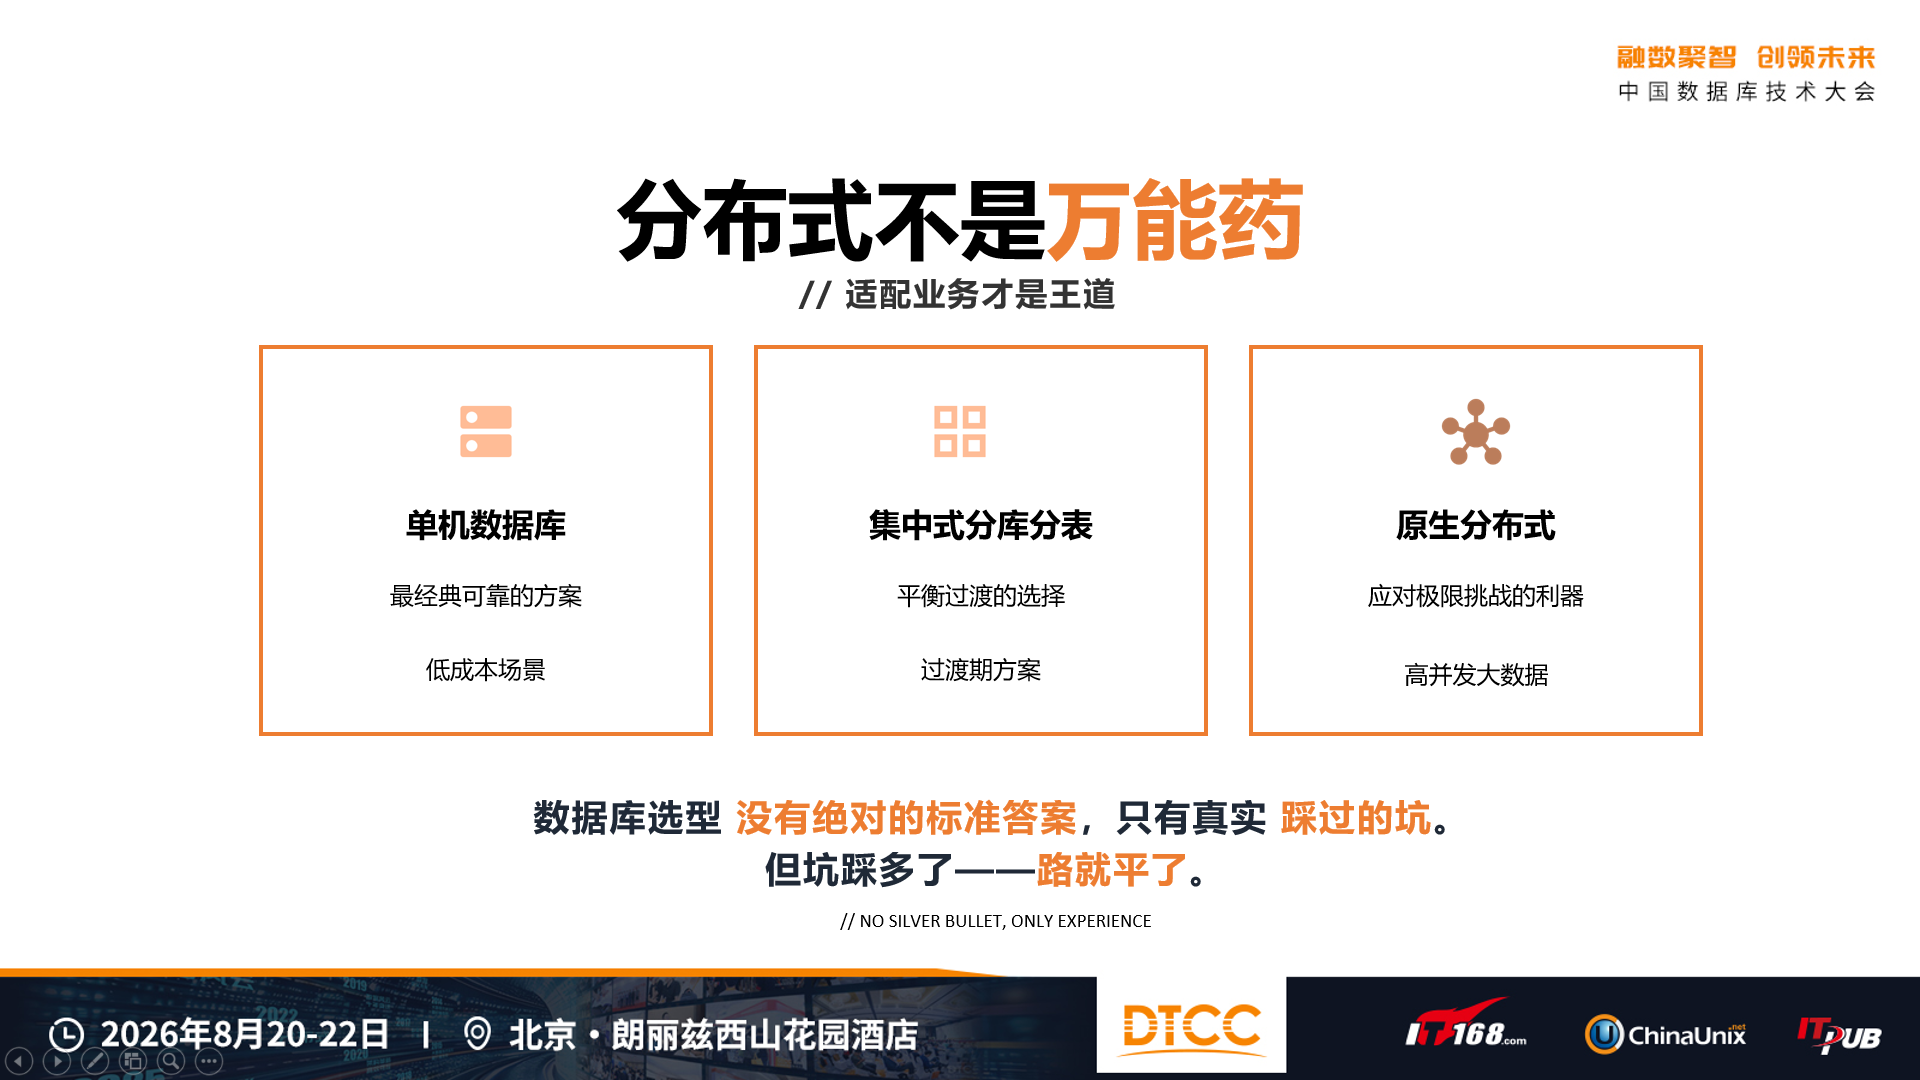
深耕专业是底气,懂得表达是能力。今天聊的这些坑,只是我踩过的冰山一角。 但坑踩多了,路就平了。
最后送大家一句话:
数据库可以分布式,但DBA的注意力可不能分布式。
单机数据库是低成本场景最经典可靠的方案,集中式分库分表是过渡期的平衡选择,原生分布式是应对极限挑战的利器—— 没有银弹,只有适配业务才是王道。
如果大家感兴趣,可以关注我的公众号 「shunwah星辰数智社」——持续更新分布式、国产化数据库实战干货。
欢迎来交流。但别凌晨3点给我发消息——那时候我的Agent在值班,而我在睡觉。
七、台下的声音
散场后,好几位听众过来交流:
“马老师的演讲特别贴合我的心声。”
“很幽默的讲解,案例感同身受。”
“你那些证书考了那么多,头发白了也值了。”
还有一位DBA跟我说: “华少,你今天讲的那个凌晨两点电话的事,跟我之前经历的一模一样。”
我知道,不是我讲得多好,是 分布式DBA的痛,大家太熟了。
咱们评论区接着聊。 👋
感谢DTCC2026组委会所有工作老师的辛勤筹备,祝贺大会圆满成功!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70042915/viewspace-3181121/ ,如需转载,请注明出处,否则将追究法律责任。

