ITPub博客

首页 > 数据库 > 数据库开发技术 > 风控建模整体流程

风控建模整体流程

原创 数据库开发技术 作者:阿黎逸阳的代码 时间:2020-02-21 21:07:40 0 删除 编辑

1. 确定建模目的
在信贷领域中建立风控模型是为了找出可能会逾期的客户,根据逾期的可能性和资金的松紧程度选择是否放贷。

在支付领域建立风控模型是为了找出可能存在非法经营的商户,保证商户没有违法经营。

2. 确定好坏样本逻辑

在信贷领域中逾期大于x期(不同公司取值不同)的客户定义为坏客户(1),从未逾期的客户定义为好客户(0)
在支付风控领域中,有赌博、欺诈、套现、伪卡等行为的商户定义为坏商户(1)(具体根据模型要防控的风险决定),未有上述风险的商户定义为好商户(0)

3. 特征工程

在风控领域一直都有这样一句话 “数据决定了机器学习的上限,而算法只是尽可能逼近这个上限”,这里的数据指的就是经过特征工程得到的数据。通俗的讲就是衍生变量去捕获风险客户。特征工程一般分为三个部分:

    1. 特征构建    

    2. 特征提取

    3. 特征选择(IV、GBDT、随机森林、逐步回归、相关系数等)
4. 数据准备
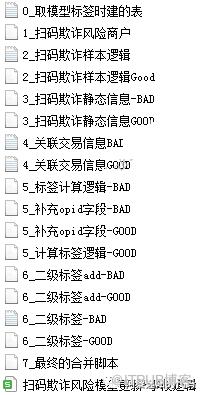
做完特征工程后就确定了需要建模的字段,如果公司的数据较多可以按以下步骤在hive中跑取需要的数据,如果数据量不大也可以在Python中或者R中准备数据。

5. 数据清洗
把合并的数据验证无逻辑错误后导入到Python中进行接下来的处理。可以看下数的分布情况,去除一些异常值。
6. 建立模型
建模可供选择的算法较多,信贷领域中逻辑回归算法比较成熟,应用比较广泛,模型的稳定性较好,很多的银行和公司都会用逻辑回归算法建立模型。 其它的一些算法比如决策树、随机森林、GBDT、孤立森林、DBSCAN、神经网络等等根据公司的业务需要也有应用。
7. 模型效果评价

建完模型后,要评价模型的效果,能否投入生产使用,需要看以下指标的情况。如果模型效果不好,要考虑是否有重要的变量没有衍生出来、或者是较好的变量没有选择到模型中去、或者是用的算法不适合这种场景。

7.1  KS
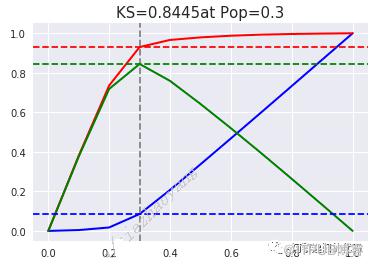
这是我在建模过程中生成的KS图,本文只放图片,具体计算公式和绘图代码在后续文章中会给出

7.2 混淆矩阵
这是我在建模过程中生成的混淆矩阵,本文只放图片,具体计算公式和绘图代码在后续文章中会给出

7.3 count_table
这个表格是把总体样本均分成x份(一般是100份),看top1的样本中坏样本率,从而判断模型在高分商户中的风险情况。本文只阐述原理,具体计算公式和代码在后续文章中会给出
8. 模型上线
 在支付风控领域如果模型验证没有问题,一般会上到线上,自动生成案例。在信贷中会模型搭配规则,判断申请贷款的人是通过放贷、拒绝放贷、还是转人工处理。这种也是线上处理,有些公司是准实时批贷,有些是实时批贷,对后台的要求较高。

9. 模型稳定性验证

模型上线后,要定期观测模型的各项指标(PSI、模型变量均值、最大值、最小值、空值等),看算模型的数据是否正常,模型的变量是否发生很大的偏斜,模型的准确率怎么样。如果模型发生了重大偏斜或准确率下降得特别厉害,要及时找出原因,不管模型上线时间有没有达到半年,都要快速迭代模型,保证业务的正常开展。

10. 模型更迭

一般半年左右,模型需要更迭,具体看数据的偏斜程度。
本文所讲的都是大致流程,没有深入展开分析,在之后的各期中会逐步展开这里所讲的每一小点,给所有需要从事风控模型的同学一点建议。


以上都是我在建模过程中的一点经验总结,有不正之处恳请指正!


参考文献:

https://www.cnblogs.com/wxquare/p/5484636.html


-end-


最后附上我的联系方式:手机号、微信号(13162366985)

也可以添加qq群:阿黎逸阳交流群

有问题欢迎咨询\(^o^)/~


喜欢这篇文章

就请点个 “ 在看 ” 吧


原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

下一篇: python中的推导式
请登录后发表评论 登录
全部评论

注册时间:2020-02-15

  • 博文量
    282
  • 访问量
    130994