在信贷中,都希望借钱给有意愿且有能力还钱的客户,这样借出去的钱才会有收益(利息),并且不会形成坏账(欠钱不还给公司造成损失)。如何找到这样的客户,把这些客户和会逾期的客户区分开来?
在很多银行和公司,基础的模型都是逻辑回归,通过逻辑回归建模把正常客户(好客户)和逾期客户(坏客户)区分开来。而可以用逻辑回归区分好坏客户的前提假设是“历史样本和未来样本服从同一总体分布”,逻辑回归模型通过从过去的数据中学习样本的分布特征,从而可以对未来的数据进行处理,判别出未来客户逾期的可能性,从而决定公司是放款还是拒绝。
那哪些变量可以进入逻辑回归模型,帮助模型更好的区分正常客户和逾期客户?让公司放款金额更多地进入能还钱的人手里,按期还本付息。尽可能少地给到会逾期不还钱的人手里,产生坏账?本文所讲的IV就可以帮助我们挑选变量,决定哪些变量可以进入到模型,哪些变量最好不要进入模型。其它挑选变量的方法如:GBDT、随机森林、相关系数、逐步回归等会在后续文章中详细说明。对于IV的预测能力,一般的会有以下建议:
IV范围 |
预测效果 |
建议 |
小于0.02 |
几乎没有 |
不放入模型 |
0.02~0.1 |
弱 |
联合考虑是否放入模型 |
0.1~0.3 |
中等 |
联合考虑是否放入模型 |
0.3~0.5 |
强 |
建议放入模型 |
>0.5 |
难以置信,需确认 |
考虑做成前端条件,构造子模型 |
IV值可不可能小于0?为什么IV值过大时要考虑把该变量做成前端条件分成两部分去做数据处理或建立模型?这些在后文中将会解答。
注1:对于不同的单位,申请借款客户的处理结果可能不一样。比如有些银行拒绝的客户(银行认为相对通过贷款申请的客户,该客户的逾期率要高),而该客户在信贷公司申请贷款,可能结果又会通过放贷。有些在银行和信贷公司都拒绝的客户,在p2p平台有可能会通过放贷。其实最终放贷结果跟公司的客户群体、数据信息是否全面、资金面松紧、领导人决策有很大的关系。下文所讲的好样本(好客户)和坏样本(坏客户)并不是讲这个客户是个好人或坏人。只是在不同的公司,根据自己已有信息判断决定的放款客户和拒绝客户。
注2:在信贷中,模型分类标签y的定义可以有多种,一种是历史逾期20天以上的定义为1(坏样本),逾期20天以内的定义为0(好样本)。一种是历史逾期超过15天以上的定义为1(坏样本), 逾期7天以内的定义为0(好样本)。在信贷中,一般逾期不超过X天(一般不同公司按照自己的实际情况取值)的客户不会定义为坏样本, 因为有些客户是忘记还款了, 只要提醒就会及时还款,或者暂时因为某种原因没能还款,过几天就会还款,不是恶意欠款。本文模型分类标签采用第一种。
第一种:

WOEi = ln(第i个分箱的坏样本数/总坏样本数)-ln(第i个分箱的好样本数/总好样本数)
此时可以理解为:对于第i个分箱,该分箱里的坏人在总坏人中的占比和的该分箱中的好人在总好人中占比的差异性,或者说坏样本分布和好样本分布之间的差异性。我们来看一种极端的情况,看看WOE的值会是多少。
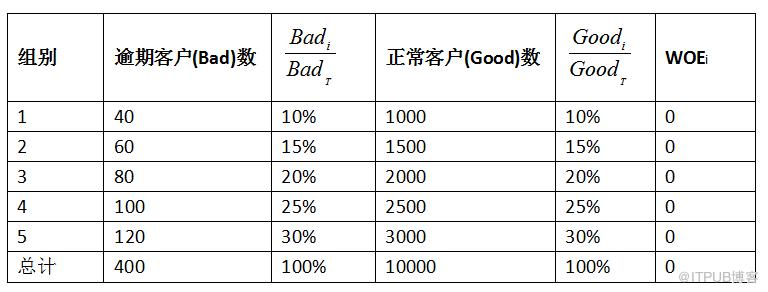
表 1 - 极端例子1(用第一种方法算WOE)
从表1可知,如果该分箱中坏人在总坏人中的占比和的该分箱中的好人在总好人中占比相同,WOEi为0。或者说坏样本分布和好样本分布之间完全相同,那么所有的WOEi都为0.想一想这有什么启发?
第二种:
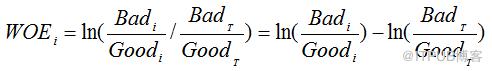
WOEi = ln(第i个分箱的坏样本数/第i个分箱的好样本数)-ln(总坏样本数/总好样本数)
此时可以理解为:每个分箱的坏好比和总体坏好比之间的差异。
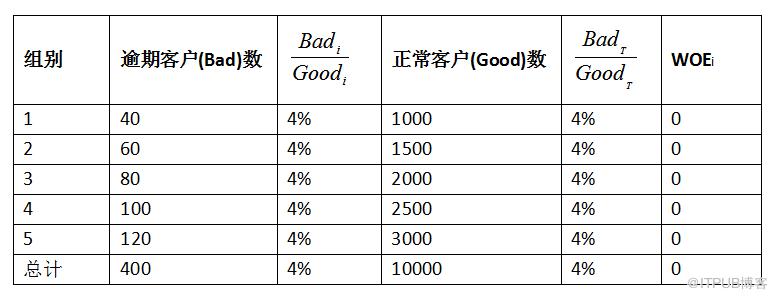
表 2 - 极端例子1(用第二种方法算WOE)
从表2可知,如果每个分箱中的坏好比和总体坏好比相同(无差异),则WOEi为0,且两种形式的公式计算结果相同。
2.2 IV
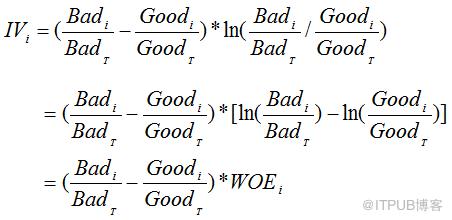
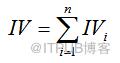
从IV的计算公式可以看出,IV可以看成WOE的加权和。之前提到一个问题:IV值可不可能小于0?接下来我们证明一下IVi的值为什么恒大于等于0,而IV是IVi求和,从而IV值恒大于等于0.
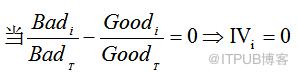
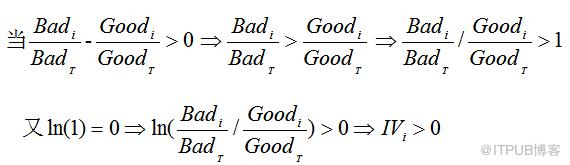

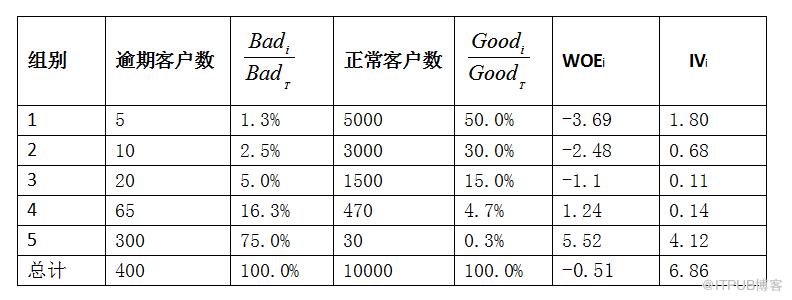
表 3 - 极端例子2(算IV)
接下来用一个实例说明如何在python中计算变量的WOE和IV
由于篇幅原因,不在文中放具体数据,如需要,请到公众号中回复“用python计算iv”
import pandas as pdimport numpy as npdf = pd.read_csv("data.csv")
#等频切割变量def bin_frequency(x,y,n=10): # x为待分箱的变量,y为target变量.n为分箱数量total = y.count() #1 计算总样本数bad = y.sum() #2 计算坏样本数good = total-bad #3 计算好样本数if x.value_counts().shape[0]==2: #4 如果该变量值是0和1则只分两组d1 = pd.DataFrame({'x':x,'y':y,'bucket':pd.cut(x,2)})else:d1 = pd.DataFrame({'x':x,'y':y,'bucket':pd.qcut(x,n,duplicates='drop')}) #5 用pd.cut实现等频分箱d2 = d1.groupby('bucket',as_index=True) #6 按照分箱结果进行分组聚合d3 = pd.DataFrame(d2.x.min(),columns=['min_bin'])d3['min_bin'] = d2.x.min() #7 箱体的左边界d3['max_bin'] = d2.x.max() #8 箱体的右边界d3['bad'] = d2.y.sum() #9 每个箱体中坏样本的数量d3['total'] = d2.y.count() #10 每个箱体的总样本数d3['bad_rate'] = d3['bad']/d3['total'] #11 每个箱体中坏样本所占总样本数的比例d3['badattr'] = d3['bad']/bad #12 每个箱体中坏样本所占坏样本总数的比例d3['goodattr'] = (d3['total'] - d3['bad'])/good #13 每个箱体中好样本所占好样本总数的比例d3['WOEi'] = np.log(d3['badattr']/d3['goodattr']) #14 计算每个箱体的woe值IV = ((d3['badattr']-d3['goodattr'])*d3['WOEi']).sum() #15 计算变量的iv值d3['IVi'] = (d3['badattr']-d3['goodattr'])*d3['WOEi'] #16 计算IVd4 = (d3.sort_values(by='min_bin')).reset_index(drop=True) #17 对箱体从大到小进行排序cut = []cut.append(float('-inf'))for i in d4.min_bin:cut.append(i)cut.append(float('inf'))WOEi = list(d4['WOEi'].round(3))return IV,cut,WOEi,d4
IV,cut,WOEi,d4 = bin_frequency(df['1个月内申请人在多个平台申请借款'], df['y'])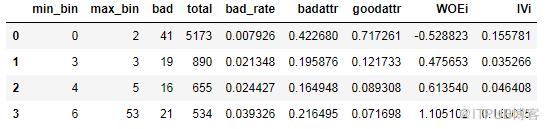
columns_iv = ['7天内申请人在多个平台申请借款','1个月内申请人在多个平台申请借款','3个月内申请人在多个平台申请借款','7天内关联P2P网贷平台数','1个月内关联P2P网贷平台数','3个月内关联P2P网贷平台数','X3个月内申请人手机号作为第二联系人手机号出现的次数','X3个月内申请人手机号作为前三联系人手机号出现的次数']ivs=[]for i in columns_iv:print(i)IV,cut,WOEi,d4 = bin_frequency(df[i], df['flag'])print('IV=', IV)ivs.append(IV)print(d4)
#自定义切割变量def bin_cut(x,y,cut): # x为待分箱的变量,y为target变量.cut为分箱的切割点total = y.count() # 计算总样本数bad = y.sum() # 计算坏样本数good = total-bad # 计算好样本数bucket = cutif x.value_counts().shape[0]==2:d1 = pd.DataFrame({'x':x,'y':y,'bucket':pd.cut(x,2)})else:d1 = pd.DataFrame({'x':x,'y':y,'bucket':pd.cut(x,cut)}) # 用pd.cut实现分箱d2 = d1.groupby('bucket',as_index=True) # 按照分箱结果进行分组聚合d3 = pd.DataFrame(d2.x.min(),columns=['min_bin'])d3['min_bin'] = d2.x.min() # 箱体的左边界d3['max_bin'] = d2.x.max() # 箱体的右边界d3['bad'] = d2.y.sum() # 每个箱体中坏样本的数量d3['total'] = d2.y.count() # 每个箱体的总样本数d3['bad_rate'] = d3['bad']/d3['total'] # 每个箱体中坏样本所占总样本数的比例d3['badattr'] = d3['bad']/bad # 每个箱体中坏样本所占坏样本总数的比例d3['goodattr'] = (d3['total'] - d3['bad'])/good # 每个箱体中好样本所占好样本总数的比例d3['WOEi'] = np.log(d3['badattr']/d3['goodattr']) # 计算每个箱体的woe值IV = ((d3['badattr']-d3['goodattr'])*d3['WOEi']).sum() # 计算变量的iv值d3['IVi'] = (d3['badattr']-d3['goodattr'])*d3['WOEi']d4 = (d3.sort_values(by='min_bin')).reset_index(drop=True) # 对箱体从大到小进行排序cut = []cut.append(float('-inf'))for i in d4.min_bin:cut.append(i)cut.append(float('inf'))WOEi = list(d4['WOEi'].round(3))return IV,cut,WOEi,d4
IV,cut,WOEi,d4 = bin_cut(df['3个月内关联P2P网贷平台数'], df['y'],[-1,0,1,4,40])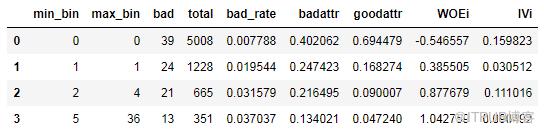
定义的函数如下:
def turn_woe(df):for i in range(d4.shape[0]):if df >= d4['min_bin'][i] and df <= d4['max_bin'][i]:return d4['WOEi'][i]
调用的语句如下:
df['3个月内关联P2P网贷平台数_woe'] = df['3个月内关联P2P网贷平台数'].apply(turn_woe)可以用如下语句进行验证:
df['3个月内关联P2P网贷平台数_woe'].value_counts()喜欢这篇文章
就请点个 “ 在看 ” 吧
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

