drop_duplicates函数介绍
加载数据
按照某一列去重实例
3.1 按照某一列去重(参数为默认值)
3.2 按照某一列去重(改变keep值)
3.3 按照某一列去重(inplace=True)
按照多列去重实例

DataFrame.drop_duplicates(subset=None,keep='first',inplace=False)二、加载数据

# coding: utf-8import os #导入设置路径的库import pandas as pd #导入数据处理的库import numpy as np #导入数据处理的库os.chdir('F:/微信公众号/Python/26.基于多列组合删除数据框中的重复值') #把路径改为数据存放的路径name = pd.read_csv('name.csv',sep=',',encoding='gb18030')name
得到结果:

三、按照某一列去重

1 按照某一列去重(参数为默认值)
按照name1对数据框去重。
new_name_1 = name.drop_duplicates(subset='name1')new_name_1
得到结果:
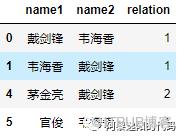
从结果知,参数为默认值时,是在原数据的copy上删除数据,保留重复数据第一条并返回新数据框。
感兴趣的可以打印name数据框,删重操作不影响name的值。
按照name1对数据框去重,并设置keep='last'。
new_name_1 = name.drop_duplicates(subset='name1',keep='last')new_name_1
得到结果:

从结果知,参数keep='last',是在原数据的copy上删除数据,保留重复数据最后一条并返回新数据框,不影响原始数据框name。
new_name_2 = name.drop_duplicates(subset='name1',keep=False)new_name_2

从结果知,参数keep=False,是把原数据copy一份,在copy数据框中删除全部重复数据,并返回新数据框,不影响原始数据框name。
3 按照某一列去重(inplace=True)
new_name_3 = name.drop_duplicates(subset='name1',inplace=True)new_name_3
结果中new_name_3的值为空,即设置inplace=True时没有返回结果,是在原始数据框name上直接进行操作。打印name可得结果:
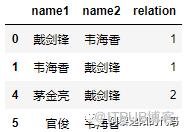
如果想保留原始数据框直接用默认值即可,如果想直接在原始数据框删重可设置参数inplace=True。
四、按照多列去重

new_name = name.drop_duplicates(subset=['name1','relation'])new_name

原始数据中只有第二行和最后一行存在重复,默认保留第一条,故删除最后一条得到新数据框。
想要根据更多列数去重,可以在subset中添加列。如果不写subset参数,默认值为None,即DataFrame中一行元素全部相同时才去除。
如需处理这种类型的数据去重问题,参见本公众号中的文章【Python】基于多列组合删除数据框中的重复值。
-end-
往期回顾:
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

