但是对于两列中元素顺序相反的数据框去重,drop_duplicates函数无能为力。
Python中有多种方法可以处理这类问题。一种是写循环依次判断是否重复删重,另一种是用本公众号文章:Python中的集合提到的frozenset函数,一句语句解决该问题。
循环太过繁琐,而且速度较慢。本文介绍一句语句解决多列组合删除数据框中重复值的问题。
举一个小例子
基于两列删除数据框中的重复值
2.1 加载数据
2.2 具体实现代码及解析
2.3 拆分代码并展示结果
2.4 做一个小实验
把代码推广到多列
一、举一个小例子


希望得到结果:
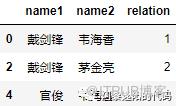
二、基于两列删除数据框中的重复值

# coding: utf-8import os #导入设置路径的库import pandas as pd #导入数据处理的库import numpy as np #导入数据处理的库os.chdir('F:/微信公众号/Python/26.基于多列组合删除数据框中的重复值') #把路径改为数据存放的路径df = pd.read_csv('relation.csv',sep=',',encoding='gb18030')df.head()
注:由于数据涉及安全问题,本文数据已经过处理。如需数据实现本文代码,请到公众号中回复:“基于多列删重”,可免费获取。
得到结果:
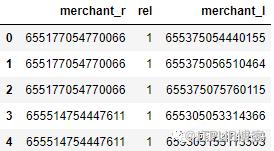
由于原始数据是从hive sql中跑出来,表示商户号之间关系的数据,merchant_r和merchant_l中存在组合重复的现象。现希望根据这两列组合消除重复项。
print(df.shape)得到结果:
(130, 3)由于每两行中有一行是重复的,希望数据处理后得到一个65行3列的去重数据框。
df_final = df[~df[['merchant_r', 'merchant_l']].apply(frozenset, axis=1).duplicated()]print(df_final.shape)
得到结果:
(65, 3)df[['merchant_r', 'merchant_l']]:从df中取出待组合删重的两列。
apply(frozenset, axis=1):把取出两列中的行当做变量依次传到frozenset函数中去。
frozenset:冻结集合,不可变,存在哈希值。经过这个函数就可以解决两行中值的顺序不一致问题。因为集合是无序的,只要值相同不用考虑顺序。
duplicated():判断变成冻结集合的列是否存在重复值,若存在标记为True。
拆分代码1:
df[['merchant_r', 'merchant_l']].apply(frozenset, axis=1)
df[['merchant_r', 'merchant_l']].apply(frozenset, axis=1).duplicated()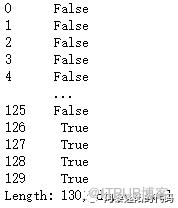
如果仅仅变成无序集合,set函数也可以做到。我们来看下用set替换frozenset是否可行。
df_cs = df[~df[['merchant_r', 'merchant_l']].apply(set, axis=1).duplicated()]得到结果:
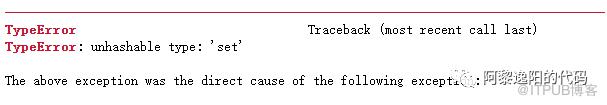
从上图可以看出用set替换frozense会报不可哈希的错误。
三、把代码推广到多列

解决多列组合删除数据框中重复值的问题,只要把代码中取两列的代码变成多列即可。下面分享一个实例:
1 加载数据
# coding: utf-8import os #导入设置路径的库import pandas as pd #导入数据处理的库import numpy as np #导入数据处理的库os.chdir('F:/微信公众号/Python/26.基于多列组合删除数据框中的重复值') #把路径改为数据存放的路径name = pd.read_csv('name.csv',sep=',',encoding='gb18030')name
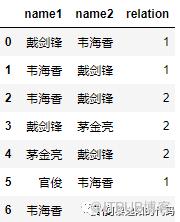
name_final = name[~name.apply(frozenset, axis=1).duplicated()]name_final
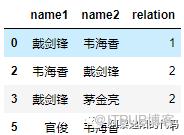
本文是我在工作中碰到的问题,发现用循环解决特别麻烦。而用frozenset函数配合其它函数代码特别简洁,故分享给更多有需要的朋友。本文有偏颇的地方欢迎指正。
-end-
往期回顾:
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

