最近刚好有项目要用决策树实现,所以把整理的Python调用sklearn实现决策树代码分享给大家。
决策树在很多公司都实际运用于风险控制,之前阐述了决策树-ID3算法和C4.5算法、CART决策树原理(分类树与回归树)和Python中应用决策树算法预测客户等级。
出于职业道德本文只阐述sklearn实现原理,不涉及项目详情。
决策树中专有名词理解
sklearn中决策树参数详解
安装决策树可视化工具graphviz
用Python实现决策树并可视化
4.1 导入数据
4.2 区分自变量和因变量
4.3 区分训练集和测试集
4.4 对比不同参数得到的决策树

1.根节点:包含数据集中所有数据集合的节点,即初始分裂节点。
2.叶节点/终端节点:最终的决策结果(该节点不再进行划分),被包含在该叶节点的数据属于该类别。
3.内部节点:非根节点和叶节点的节点,该节点包含数据集中从根节点到该节点所有条件的数据集合。根据内部节点的判断条件结果,其对应的数据集合被分到两个或多个子节点中。
4.父节点:划分出子节点的节点。
5.子节点:由父节点根据某一规则分裂而来的节点。
6.节点的深度:节点与决策树根节点的距离,如根节点的子节点的深度为1.
7.决策树的深度:所有叶子节点的最大深度。
借用CART决策树原理(分类树与回归树)中的简单决策树说明以上名词,用图形展示如下:


这一小节主要阐述sklearn中分类决策树(tree.DecisionTreeClassifier)的参数,回归决策树类似,不再赘述。
DecisionTreeClassifier(*, criterion='gini', splitter='best',max_depth=None, min_samples_split=2, min_samples_leaf=1,min_weight_fraction_leaf=0.0, max_features=None, random_state=None,max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None,class_weight=None, presort='deprecated', ccp_alpha=0.0)

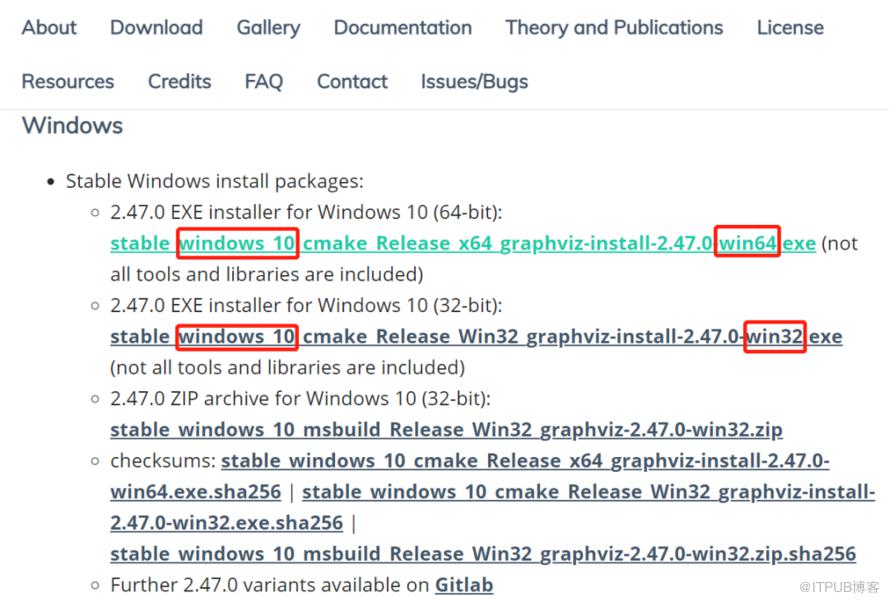
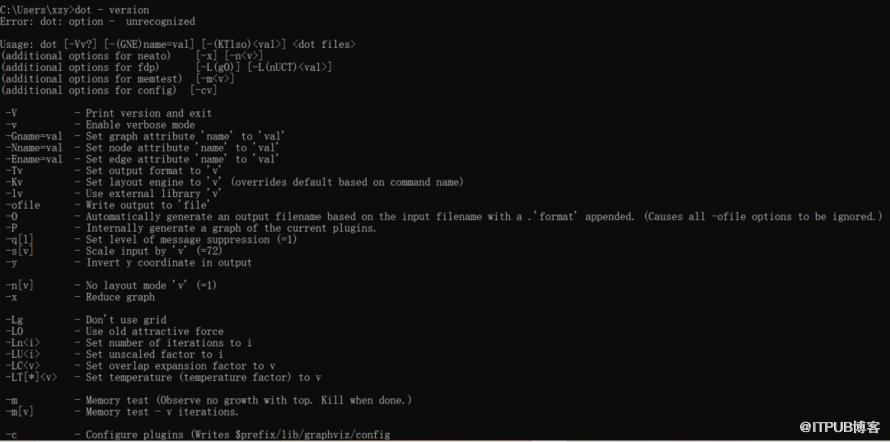
为了把训练好的决策树结构更清晰地展示出来,可以用graphviz绘图,这是一个独立的软件,和python中其它的包安装有些区别,具体安装步骤如下:
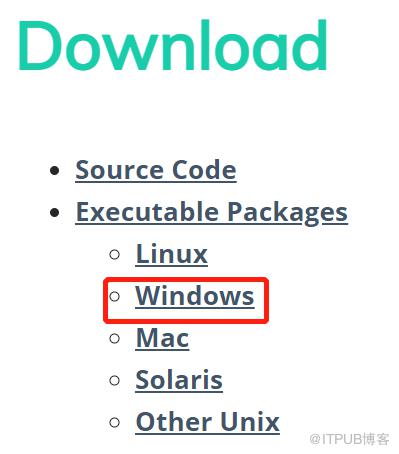
如果你的电脑是64位的,点击第一个链接,下载红框win64对应版本的exe。如果是32位的则点击第二个链接即可下载。
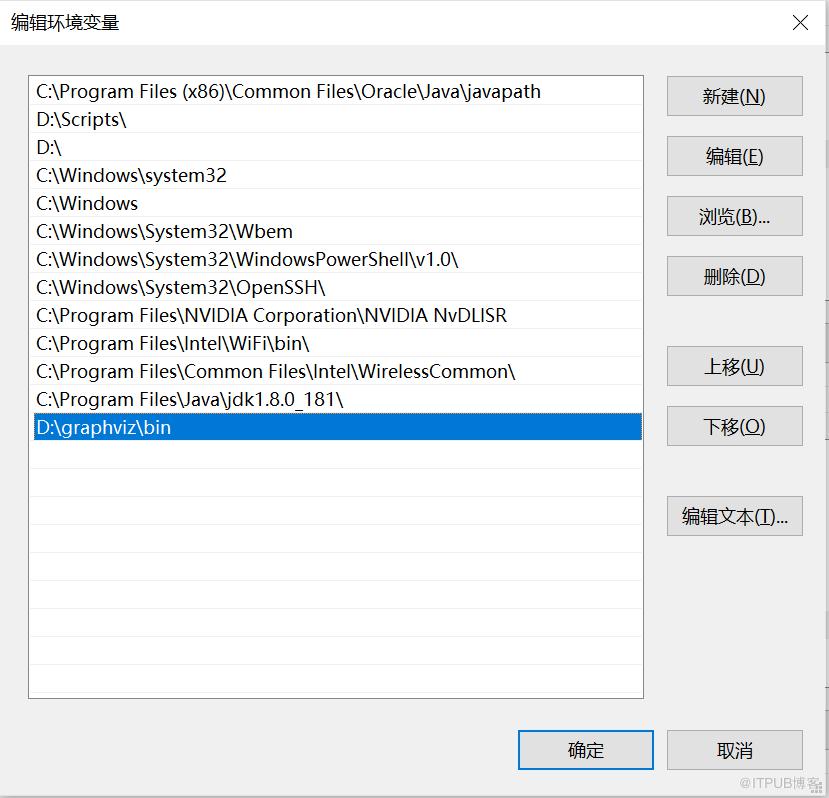
step3:配置环境变量:我的电脑--属性--高级系统设置--环境变量--系统变量--path--编辑--新建--D:\graphviz\bin(需替换成你安装graphviz的bin文件路径)--确定。

1 导入数据
# coding: utf-8import os #导入设置路径的库import pandas as pd #导入数据处理的库import numpy as np #导入数据处理的库os.chdir(r'F:\公众号\7.评分卡') #把路径改为数据存放的路径data = pd.read_csv('testtdmodel1.csv',sep=',',encoding='gb18030')
注:如需本文中的数据,可到“阿黎逸阳的代码“公众号中回复”sklearn决策树“,即可免费获取。
2 区分自变量和因变量
columns_model = ['1个月内借款人身份证申请借款平台数','7天内关联P2P网贷平台数','3个月内关联P2P网贷平台数','3个月手机号关联身份证数','3个月内申请人关联融资租赁平台数','二度风险名单个数','是否命中身份证风险关注名单','原始分','一度风险名单个数']X_model = data[columns_model] #生成入模自变量y = data['y'] #生成入模因变量
3 区分训练集和测试集
from sklearn.model_selection import train_test_split #导入区分训练集和测试集的模块Xtrain, Xtest, Ytrain, Ytest = train_test_split(X_model, y, test_size=0.3)
4 对比不同参数得到的决策树
为了生成展示中文的决策树pdf文件,可以在Source函数中进行设置,之前为了解决这个问题花了很长时间。
接下来看两个对比分析的具体实例,其它参数的对比分析可以自行测试。
step1:其它参数都一样,对比criterion中参数值。
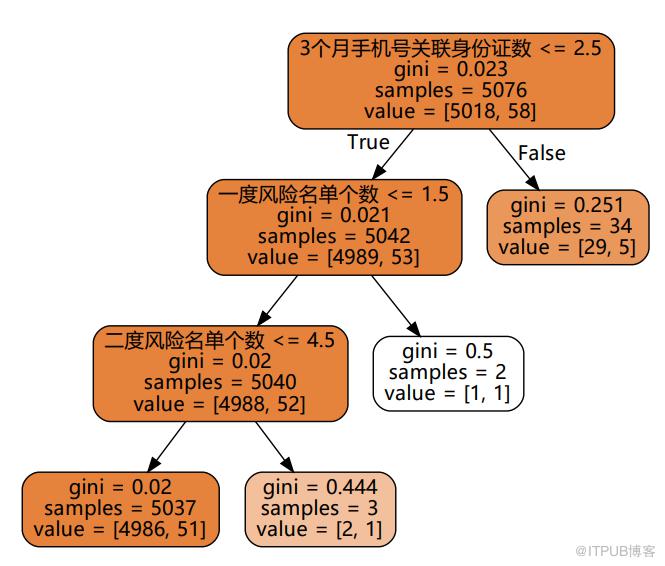
criterion设置成默认值”gini“,具体语句:
from sklearn import tree #导入sklearn中的树模块clf = tree.DecisionTreeClassifier(criterion='gini', max_depth=3, min_samples_split=100)clf = clf.fit(Xtrain, Ytrain)score = clf.score(Xtest, Ytest)import graphvizdot_data = tree.export_graphviz(clf,out_file =None,feature_names = columns_model,filled = True,rounded = True)print("criterion=",'entropy',"score=",score)graph = graphviz.Source(dot_data.replace('helvetica','"Microsoft YaHei"'), encoding='utf-8')graph.render(filename='MyPicture',view=True) #结果保存在MyPicture.pdf中
得到结果:
criterion设置成”entropy“,具体语句:
from sklearn import tree #导入sklearn中的树模块clf = tree.DecisionTreeClassifier(criterion='entropy', max_depth=3, min_samples_split=100)clf = clf.fit(Xtrain, Ytrain)score = clf.score(Xtest, Ytest)import graphvizdot_data = tree.export_graphviz(clf,out_file =None,feature_names = columns_model,filled = True,rounded = True)print("criterion=",'entropy',"score=",score)graph = graphviz.Source(dot_data.replace('helvetica','"Microsoft YaHei"'), encoding='utf-8')graph.render(filename='MyPicture',view=True) #结果保存在MyPicture.pdf中
得到结果:
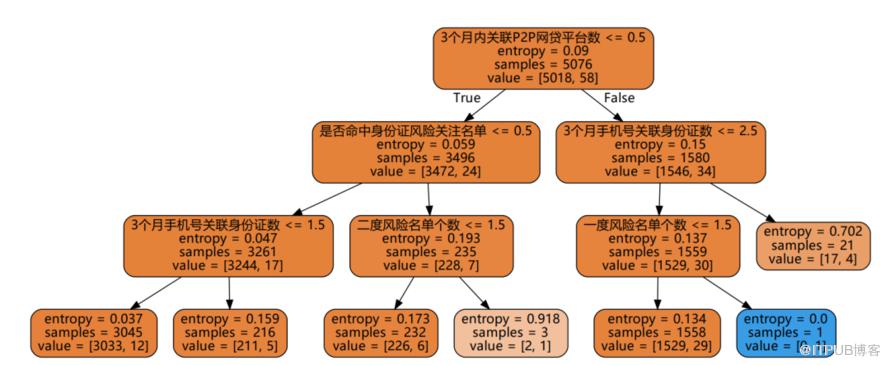
从上面两个图可以发现:采用gini和entropy两种方法结果差距很大,gini更倾向于把1找出来,entropy方法会更均匀一点。
如果是实际做策略时,可以优先考虑gini,有时也可以两种方法结合起来考虑,找到最优划分点。
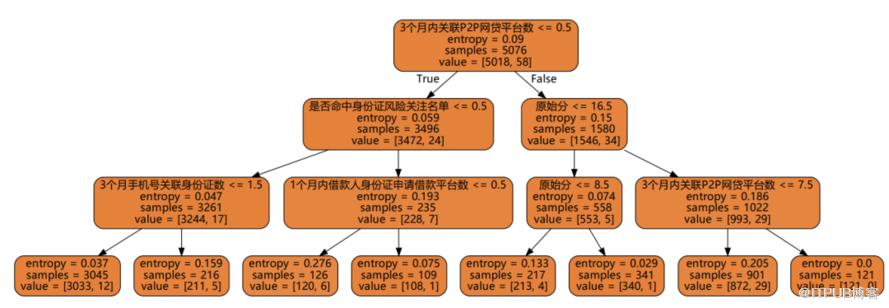
step2:其它参数都一样,min_samples_leaf参数调整。
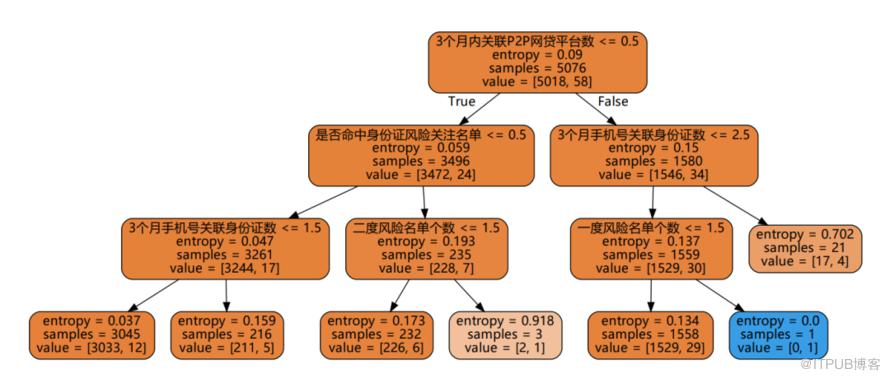
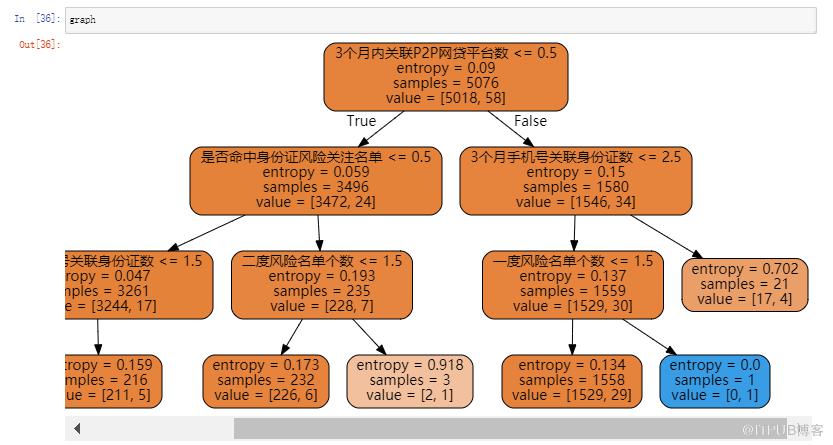
不添加min_samples_leaf参数,并把值设为100,具体语句:
from sklearn import tree #导入sklearn中的树模块clf = tree.DecisionTreeClassifier(criterion='entropy', max_depth=3, min_samples_split=100)clf = clf.fit(Xtrain, Ytrain)score = clf.score(Xtest, Ytest)import graphvizdot_data = tree.export_graphviz(clf,out_file =None,feature_names = columns_model,filled = True,rounded = True)print("criterion=",'entropy',"score=",score)graph = graphviz.Source(dot_data.replace('helvetica','"Microsoft YaHei"'), encoding='utf-8')graph.render(filename='MyPicture',view=True) #结果保存在MyPicture.pdf中
from sklearn import tree #导入sklearn中的树模块clf = tree.DecisionTreeClassifier(criterion='entropy', max_depth=3, min_samples_split=100, min_samples_leaf=100)clf = clf.fit(Xtrain, Ytrain)score = clf.score(Xtest, Ytest)import graphvizdot_data = tree.export_graphviz(clf,out_file =None,feature_names = columns_model,filled = True,rounded = True)print("criterion=",'entropy',"score=",score)graph = graphviz.Source(dot_data.replace('helvetica','"Microsoft YaHei"'), encoding='utf-8')graph.render(filename='MyPicture',view=True) #结果保存在MyPicture.pdf中
 。
https://blog.csdn.net/bylfsj/article/details/104453310/https://blog.csdn.net/qq_40884357/article/details/104613563https://blog.csdn.net/master_hunter/article/details/109022300https://blog.csdn.net/weixin_43979090/article/details/9724522https://blog.csdn.net/weixin_30253941/article/details/11358129https://blog.csdn.net/weixin_39964660/article/details/11358129


扫一扫关注我
13162366985
投稿微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

