如果你要评估一个企业的规模有多大,经营状况如何,值不值得你进入这家企业,或者值不值得你投资,你会怎么办?
可能第一想法是上企查查搜一下企业的成立时间、实缴资本、人员规模、所属地区、所属行业等基本工商信息。
对企业做一个基本的评估。
然后更进一步对企业的司法、税务、涉诉、经营情况、股东变更等信息做一个更深入的挖掘。
但如果要你评估的是100万家企业,你也一个一个去搜,再把企查查上的基本信息复制下来吗?
这看起来是一个很漫长且枯燥的事情……
本文和你一起来探索用Python爬企查查,批量获取企业的工商信息,并自动下载为Excel文件。
实现结果
导入库
定义获取企业基本信息的函数
调用函数获取企业基本信息
把获取到的信息输出到csv文件中

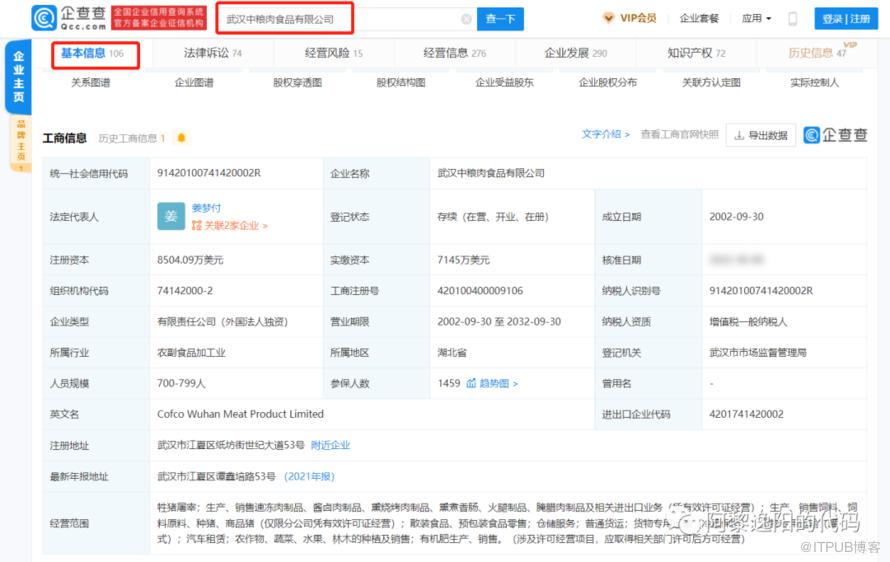
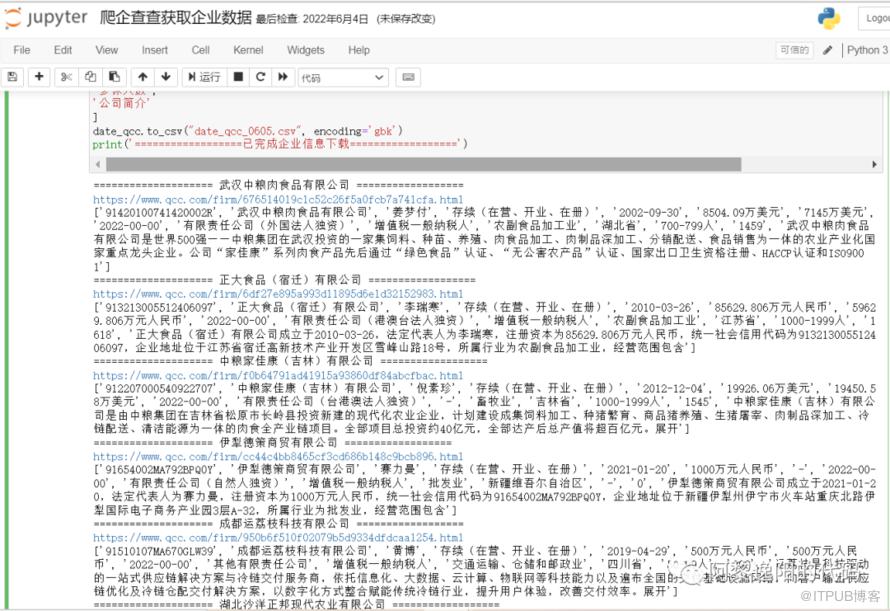
通过爬虫后得到的打印信息如下(可和网页上的原始信息进行一致性对比):
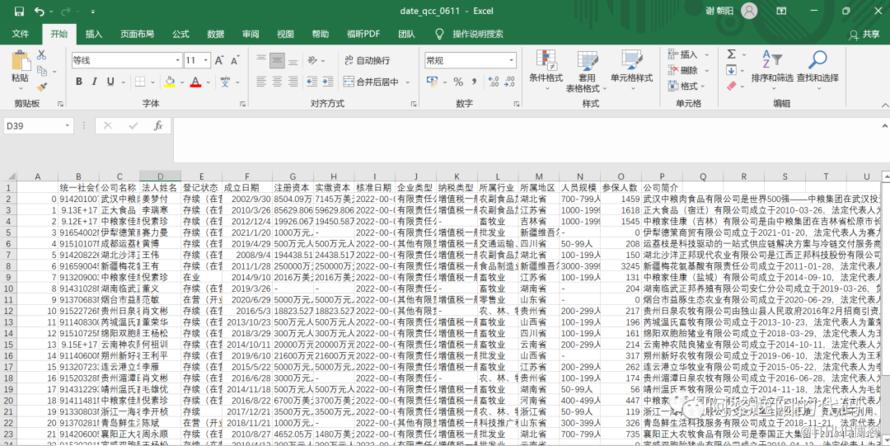
通过爬虫后得到的Excel信息如下:

import timeimport xlrdimport randomimport numpy as npfrom xlutils.copy import copyfrom selenium import webdriverimport selenium.webdriver.support.ui as uifrom selenium.webdriver.common.keys import Keysfrom selenium.webdriver.common.action_chains import ActionChains
如果你有些库还没有安装,导致运行代码时报错,可以在Anaconda Prompt中用pip方法安装。

接着定义获取基本信息的函数,为了分割的准确性,先获取工商信息表格中的行,再分离获取每个变量。
具体代码如下:
def basic_nes(herf1):driver.get(herf1) #进入新的网址time.sleep(20) #暂停20s###############################基本信息##############################################xy_com_name = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[1]').text#获取统一信用代码和公司名称xydm = xy_com_name.split('\n')[0]com_name = xy_com_name.split('\n')[1]unif_social_crd_code_f = xydm.split(' ')[1]#统一社会信用代码com_name_f = com_name.split(' ')[1]#公司名称fr_zt_date = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[2]').text#获取法人姓名、登记状态、成立日期artf_person = fr_zt_date.split('>')[0]artf_person_f = artf_person.split(' ')[1].split('\n')[0]#法人姓名reg_form_date = fr_zt_date.split('>')[1]reg_form_f = reg_form_date.replace('\n', '').split(' ')[1]#登记状态open_date_f = reg_form_date.replace('\n', '').split(' ')[3]#成立日期reg_sj_hz_date = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[3]').text#注册资本、实缴资本、核准日期reg_cap_f = reg_sj_hz_date.split(' ')[1]#注册资本cap_pad_f = reg_sj_hz_date.split(' ')[3]#实缴资本chek_date_f = reg_sj_hz_date.split(' ')[5]#核准日期com_type_ns = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[5]').text#企业类型、纳税类型com_type_f = com_type_ns.split(' ')[1]#企业类型pay_tax_f = com_type_ns.split(' ')[7]#纳税类型indust_region = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[6]').text#所属行业、所属地区indust_f = indust_region.split(' ')[1]#所属行业region_f = indust_region.split(' ')[3]#所属地区peop_insur_num = driver.find_element_by_xpath('//*[@id="cominfo"]/div[2]/table/tr[7]').text#人员规模和参保人数peop_num_f = peop_insur_num.split(' ')[1]#人员规模insur_num_f = peop_insur_num.split(' ')[3]#参保人数brif_indc = driver.find_element_by_xpath('/html/body/div[1]/div[2]/div[2]/div/div[1]/div[2]/div[2]/div[3]/div[4]/span').textbrif_indc_f = brif_indc.split(':')[1]brif_indc_f = brif_indc_f.replace(' ', '')#公司简介###############################基本信息###############################################统一社会信用代码、公司名称、法人姓名、登记状态、成立日期、注册资本、实缴资本、核准日期、企业类型、纳税类型、所属行业、所属地区、人员规模、参保人数date = list([unif_social_crd_code_f])#统一社会信用代码date.append(com_name_f)#公司名称date.append(artf_person_f)#法人姓名date.append(reg_form_f)#登记状态date.append(open_date_f)#成立日期date.append(reg_cap_f)#注册资本date.append(cap_pad_f)#实缴资本date.append(chek_date_f)#核准日期date.append(com_type_f)#企业类型date.append(pay_tax_f)#纳税类型date.append(indust_f)#所属行业date.append(region_f)#所属地区date.append(peop_num_f)#人员规模date.append(insur_num_f)#参保人数date.append(brif_indc_f)#公司简介print(date)return date
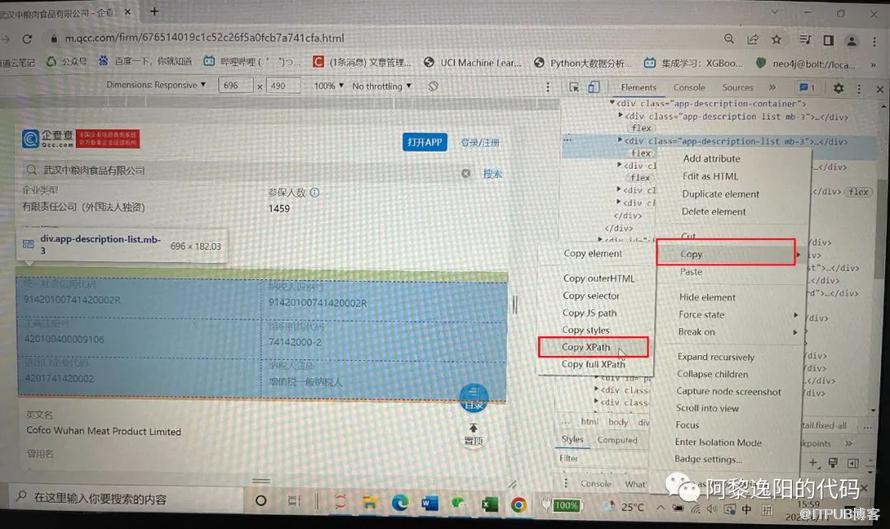
回想一下,我们在电脑中找文件的时候,你是不是通过文件夹的路径依次点击找到该文件?
网页中也有类似路径。
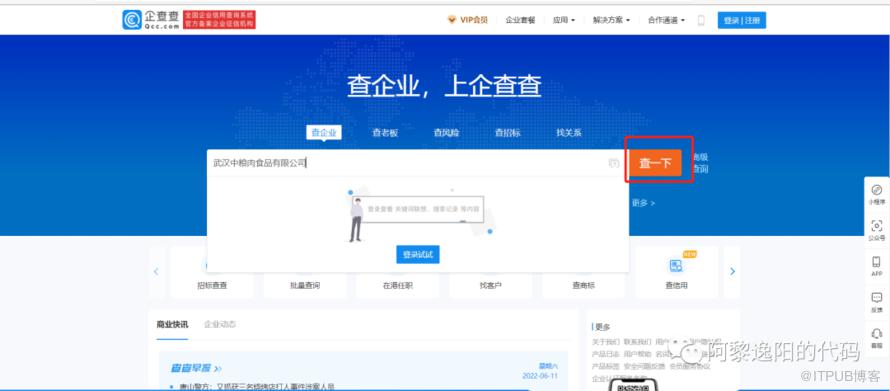
可以先进入如下企查查的官方首页(建议使用google浏览器进入,方便查找路径):
https://www.qcc.com/?utm_source=baidu1&utm_medium=cpc&utm_term=pzsy进入如下页面,点击查一下。
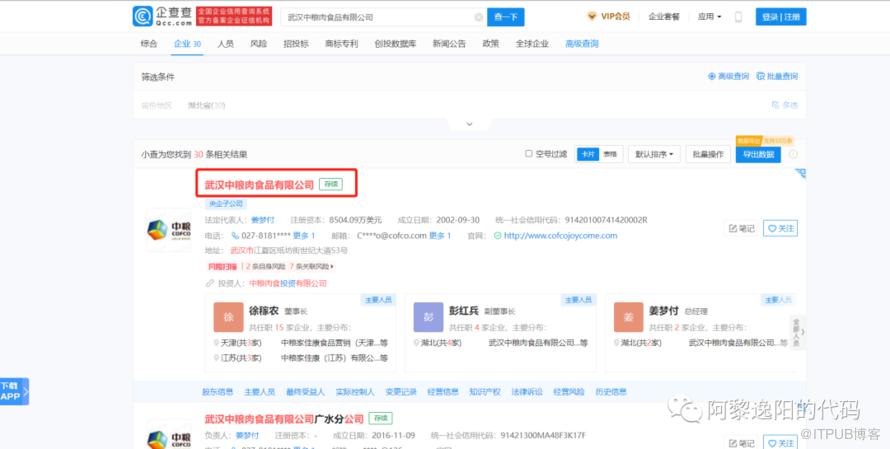

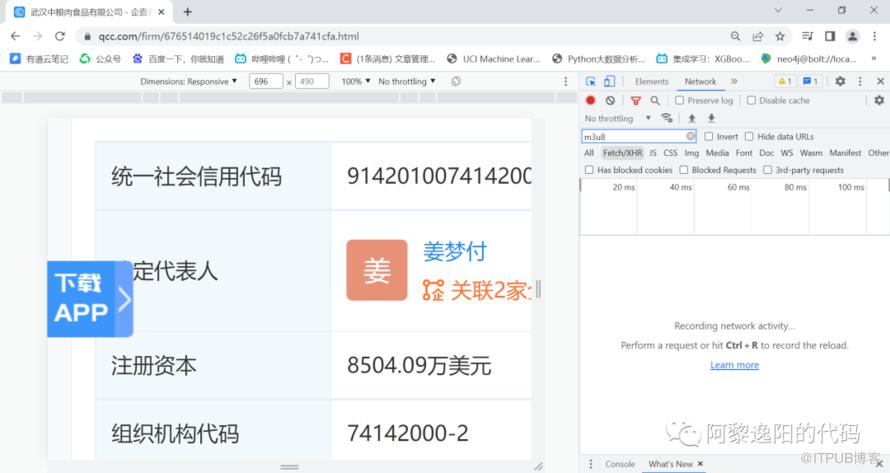
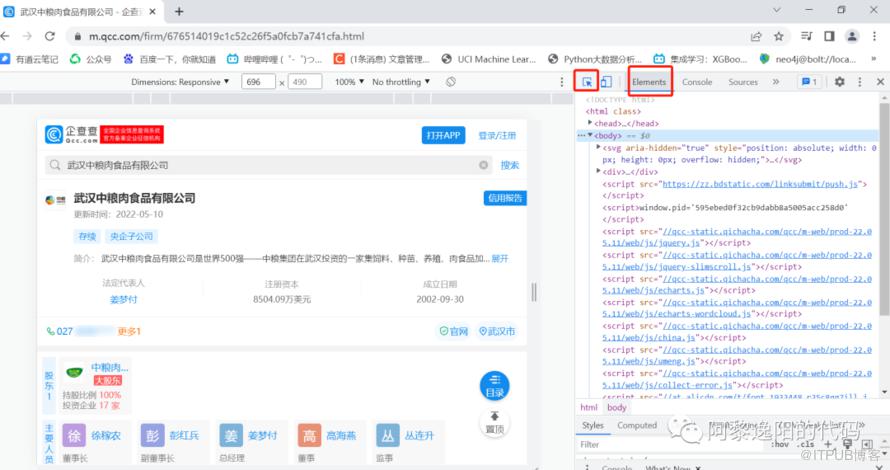
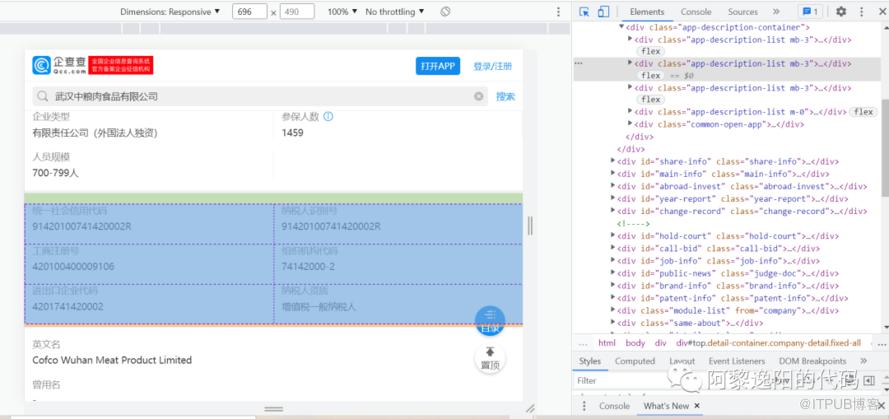

#待输入搜索公司corps = ['武汉中粮肉食品有限公司','正大食品(宿迁)有限公司','中粮家佳康(吉林)有限公司','伊犁德策商贸有限公司','成都运荔枝科技有限公司','湖北沙洋正邦现代农业有限公司','新疆梅花氨基酸有限责任公司','中粮家佳康(盐城)有限公司','湖南临武正邦养殖有限公司安仁分公司','烟台市益豚生态农业有限公司','贵州日泉农牧有限公司','芮城温氏畜牧有限公司','绵阳双胞胎猪业有限公司','云南神农陆良猪业有限公司','朔州新好农牧有限公司','连云港立华牧业有限公司','贵州湄潭日泉农牧有限公司','靖州温氏畜牧有限公司','中粮家佳康(河南)有限公司','浙江一海农业发展有限公司','青岛鲜生活科技服务有限公司','襄阳正大农牧食品有限公司','宣威双胞胎猪业有限公司','新民金泰扬翔农牧有限责任公司','萍乡双胞胎猪业有限公司','泰安汉世伟食品有限公司','甘肃新希望六和农牧有限公司','黑山新六农牧科技有限公司','全南现代牧业有限公司','潜江正邦汇联饲料有限公司','中粮家佳康(江苏)有限公司东台分公司','灌南温氏食品有限公司','甘肃天康农牧科技有限公司永昌分公司','江苏全稳康源农业发展有限公司','湖北正大畜禽有限公司','中粮家佳康(赤峰)有限公司','沈阳恒丰源扬翔种猪繁育有限公司','甘肃天康农牧科技有限公司华家沟分公司','宜宾广联养殖有限公司长宁分公司']#待输入搜索公司#corps = ['广州海洋勘探开发总公司', '广东车海洋环保科技有限公司', '广东粤新海洋工程装备股份有限公司', '广东省海洋工程职业技术学校(广东省海洋工程技工学校)',]date_f = list()for i in range(len(corps)):#模拟使用Chrome浏览器登陆options = webdriver.ChromeOptions()options.add_argument("--disable-blink-features=AutomationControlled")driver = webdriver.Chrome(options=options)driver.implicitly_wait(10)#打开搜索页driver.get('https://www.qcc.com/?utm_source=baidu1&utm_medium=cpc&utm_term=pzsy')time.sleep(20) # 暂停20s#待输入搜索公司corp = corps[i]driver.find_element_by_id('searchKey').clear() #清空搜索框driver.find_element_by_id('searchKey').send_keys(corp) #在搜索框中输入查询企业名单#wait = ui.WebDriverWait(driver,5)#wait.until(lambda drivers: driver.find_element_by_xpath("/html/body/div/div[2]/section[1]/div/div/div/div[1]/div/div/span/button"))next_btn = driver.find_element_by_xpath('/html/body/div/div[2]/section[1]/div/div/div/div[1]/div/div/span/button')driver.execute_script("arguments[0].click();", next_btn)time.sleep(10)time.sleep(np.random.randint(1, 10))cname = driver.find_element_by_xpath('//a[@class="title copy-value"]').texthref1 = Nonewhile 1:try:href1 = driver.find_element_by_xpath('//a[@class="title copy-value"]').get_attribute("href")print('====================', corp, '==================')print(href1)if href1 is not None:breakexcept:time.sleep(np.random.randint(1, 2))cnt = 0while 1:cnt += 1if cnt<5:try:date_f.append(basic_nes(href1))breakexcept:passelse:print('请单独对',corp, '的信息进行获取')breakdriver.close()


最后把获取到的信息输出到Excel文件中,代码如下:
#把数据输出成excelimport osimport pandas as pdos.chdir(r'F:\公众号\55.爬企查查')date_qcc = pd.DataFrame(date_f)date_qcc.columns = ['统一社会信用代码','公司名称','法人姓名','登记状态','成立日期','注册资本','实缴资本','核准日期','企业类型','纳税类型','所属行业','所属地区','人员规模','参保人数','公司简介']date_qcc.to_csv("date_qcc_0605.csv", encoding='gbk')print('==================已完成企业信息下载==================')
得到结果:
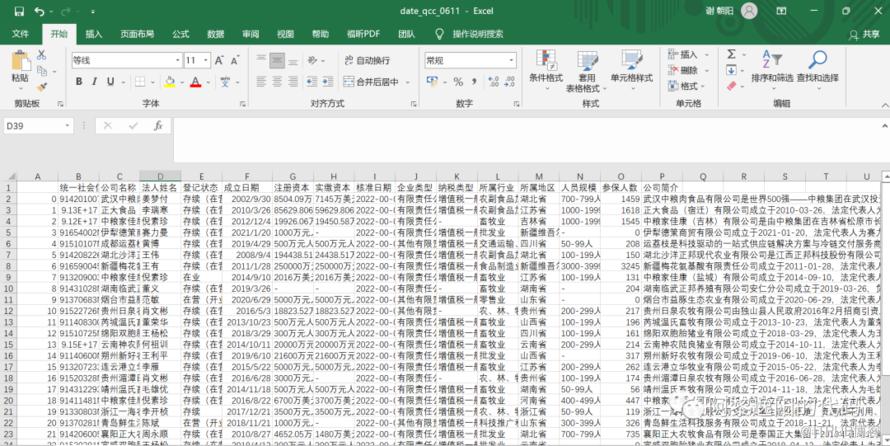
这段代码的作用是把获取到的信息转成DataFrame,并输出到相应文件夹中。
至此,在Python中批量获取企业在企查查中的工商信息已讲解完毕,把文章分享给身边更多有需要的朋友吧 。

扫一扫关注我
13162366985
投稿微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

