二、Python正则模块 re
re模块的常用函数主要如下:
2.1 findall()函数
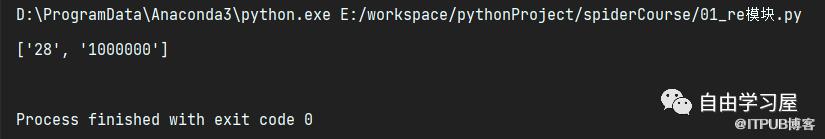
findall(parm1, parm2)函数的第一个参数为正则表达式,第二个参数为待匹配字符串。该函数会从字符串中匹配出符合给定正则表达式的结果,并以列表形式返回。例如:
result = re.findall("U", "我看到一个UFO从天边划过")print(result)

# 'r'表示忽略反斜杠的转义含义result = re.findall(r"\d+", "我今年28岁,存款1000000块")print(result)
2.2 finditer()函数
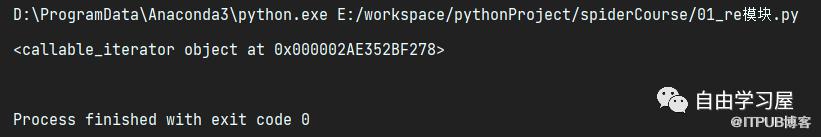
finditer(parm1, parm2)函数以迭代器对象的形式返回满足正则表达式的结果,要从迭代器对象中拿到数据,需用循环。示例如下:
result = re.finditer(r"\d+", "我今年28岁,存款1000000块")print(result)
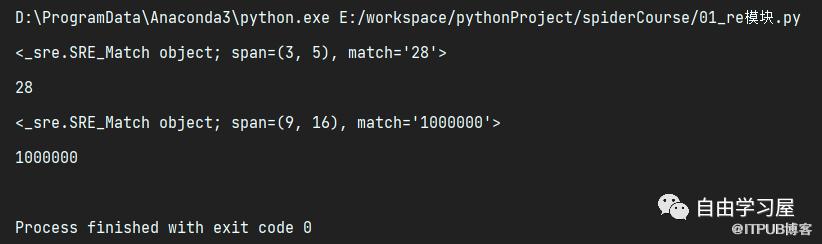
从返回对象中取数据:
result = re.finditer(r"\d+", "我今年28岁,存款1000000块")for item in result:print(item)print(item.group()) # group()方法取出实际匹配结果
2.3 search()函数
search(parm1, parm2)函数匹配到第一个满足正则表达式的结果就返回,后续即使还有符合要求的内容也不再匹配。
result = re.search(r"\d+", "我是斯特凡,今年150岁了,18岁时读高二班")print(result.group())
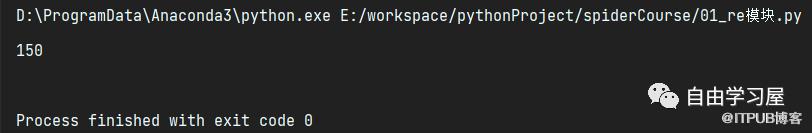
可以看到后面的“18”也满足表达式,但已经匹配到“150”,所以不再继续匹配,直接返回结果。
2.4 match()函数
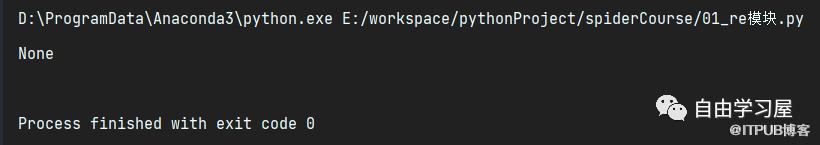
match(parm1, parm2)函数与search()类似,也是匹配到第一个符合正则表达式的结果就返回。但与search的区别在于,match函数是从字符串的开头进行匹配,类似在正则表达式前加上了^。
result = re.match(r"\d+", "我是斯特凡,今年150岁了,18岁时读高二班")print(result)
2.5 预编译compile()函数
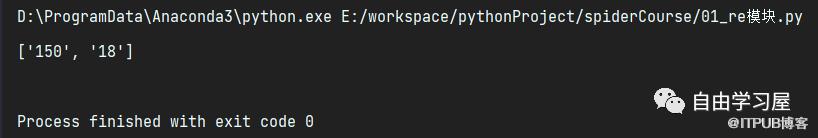
很多时候,在做数据抓取时,需要循环抓取。如果每次循环都加载一次正则表达式的话,可能会消耗更多的资源(时间、空间),这个时候就可以采用预编译的方法,即在循环前先将正则表达式编译好,这样每次循环时直接将编译好的表达式拿来用即可。
obj = re.compile(r"\d+")result = obj.findall("我是斯特凡,今年150岁了,18岁时读高二班")print(result)
2.6 示例:提取分组数据
s = """<div class='西游记'><span id='10086'>中国移动</span></div><div class='西游记'><span id='10010'>中国联通</span></div>"""obj = re.compile(r"<span id='(?P<id>\d+)'>(?P<name>.*?)</span>")result = obj.finditer(s)for item in result:id = item.group("id")name = item.group("name")print(id)print(name)

正则表达式前面的
?P<var_name>语法表示将其后表达式匹配到的内容存放到该变量中,方便后续数据提取。注意:
var_name跟其后的正则表达式之间不能有空格,否则匹配不到想要的数据;
var_name必须跟后面的group("var_name")保持一致,否则取不到对应数据。
爬虫前进之路,任!我!行!
原文作者:数据派探险家;如有侵权,请联系管理员删除。

最新文章
- 5个被过度高估的Python库(你绝对想不到)!
- 不掌握这10个Python概念,请不要自称高级开发人员(二)~~
- 不掌握这10个Python概念,请不要自称高级开发人员(一)~~
- 数据分析面试:你认为数据分析的价值如何体现?
- Python必知必会:使用 dedent() 方法优雅地展示多行字符串!
- Python必知必会:39个Python关键字详解,你的编程查阅小手册,收藏!
- Python必知必会:每个程序员都必须知道的22个Python单行代码!
- Python必知必会:15个令人相见恨晚的Python字符串格式化技巧!
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(二)
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(一)
