抓取地址:http://220.180.84.203:8010/persalereg.php
网页数据样例:
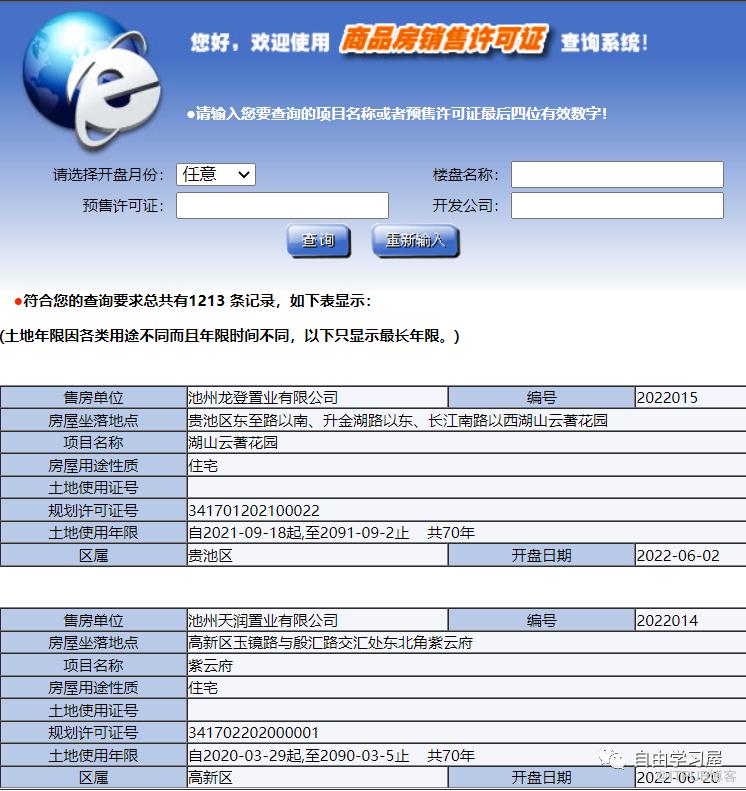
抓取思路:
获取页面源代码;
编写正则表达式;
提取页面数据;
保存数据。
一、获取页面源代码
url = "http://220.180.84.203:8010/persalereg.php"headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/103.0.0.0 Safari/537.36"}resp = requests.get(url=url, headers=headers)resp.encoding = 'GBK'html = resp.textprint(html)
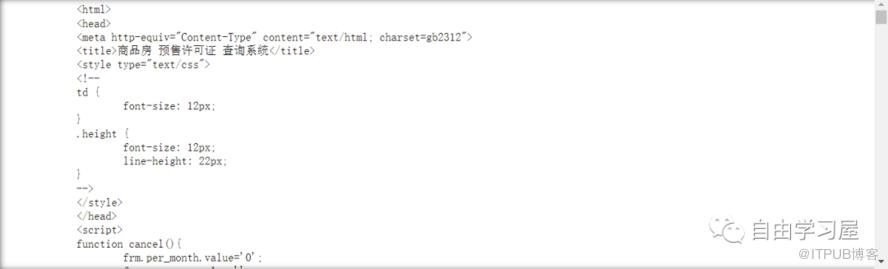
二、编写正则表达式
页面源代码:
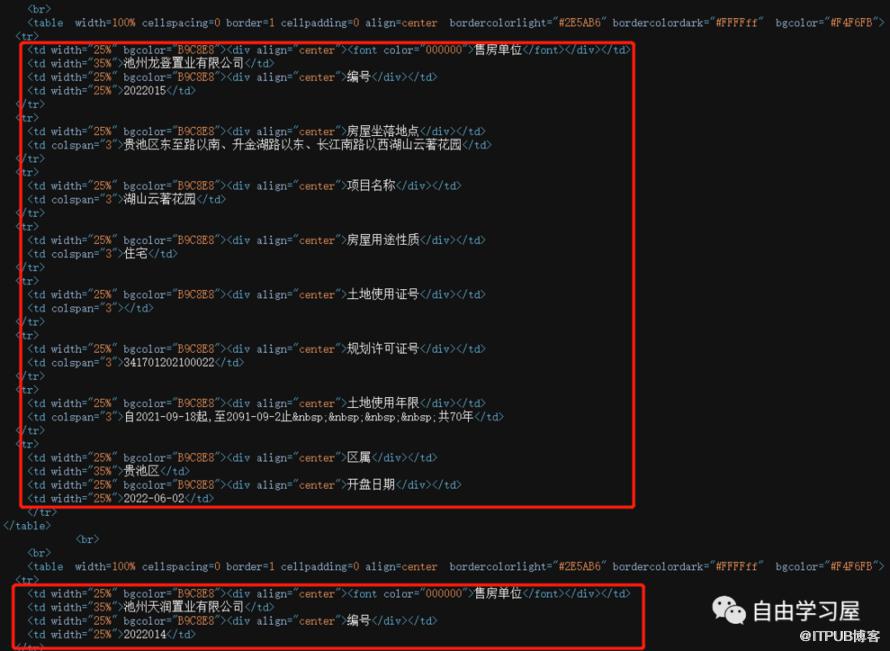
我们需要抓取的元素主要包括:售房单位、预售证编号、房屋坐落地点、项目名称、房屋用途性质、区属、开盘日期。根据页面源代码所呈现的规律,编写如下正则表达式:
regex = re.compile(r'<td width="25%" bgcolor="B9C8E8"><div align="center"><font color="000000">售房单位.*?'\'<td width="35%">(?P<developer>.*?)</td>.*?'\'编号</div></td>.*?<td width="25%">(?P<sPermitNo>.*?)</td>.*?'\'房屋坐落地点</div></td>.*?<td colspan="3">(?P<address>.*?)</td>.*?'\'项目名称</div></td>.*?<td colspan="3">(?P<projectName>.*?)</td>.*?'\'房屋用途性质</div></td>.*?<td colspan="3">(?P<houseUsage>.*?)</td>.*?'\'区属</div></td>.*?<td width="35%">(?P<areaName>.*?)</td>.*?'\'开盘日期</div></td>.*?<td width="25%">(?P<openDate>.*?)</td>', re.S)
关键要素说明:
re.S:表示正则表达式可以匹配换行符。?P<var_name>.*?:表示将.*?匹配到的内容赋给前面的变量var_name,方便后面取数。
三、提取页面数据
由于需要提取的预售证有多个,所以此处我们使用正则模块(re)的 finditer() 函数:
result = regex.finditer(html)for item in result:developer = item.group("developer")sPermitNo = item.group("sPermitNo")address = item.group("address")projectName = item.group("projectName")houseUsage = item.group("houseUsage")areaName = item.group("areaName")openDate = item.group("openDate")print(developer, sPermitNo, address, projectName, houseUsage, areaName, openDate)break
注意:
group()函数中的名称必须与正则表达式中定义的变量名称一致,否则取不到对应的数据;break关键字表示我们只输出第一个预售证的信息,用作实验。
输出结果:

四、保存数据
我们保存数据的方法:首先将提取到的数据存到DataFrame中,最后再写入Excel:
columnNames = ['售房单位', '预售证编号', '房屋坐落', '项目名称', '房屋用途', '区县', '开盘日期']datas = []for item in result:developer = item.group("developer")sPermitNo = item.group("sPermitNo")address = item.group("address")projectName = item.group("projectName")houseUsage = item.group("houseUsage")areaName = item.group("areaName")openDate = item.group("openDate")datas.append([developer, sPermitNo, address, projectName, houseUsage, areaName, openDate])print("抓取完毕!")dataDF = pd.DataFrame(data=datas, columns=columnNames)dataDF.to_excel('池州预售证抓取.xlsx', index=False)print("保存完毕!")
关键要素说明:
columnNames定义DataFrame的列名。to_excel()中的index=False表示保存到Excel中时不带索引号。
五、完整实现代码
最后,完整的抓取代码如下:
import reimport requestsimport pandas as pdurl = "http://220.180.84.203:8010/persalereg.php"headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/103.0.0.0 Safari/537.36"}columnNames = ['售房单位', '预售证编号', '房屋坐落', '项目名称', '房屋用途', '区县', '开盘日期']datas = []resp = requests.get(url=url, headers=headers)resp.encoding = 'GBK'html = resp.textregex = re.compile(r'<td width="25%" bgcolor="B9C8E8"><div align="center"><font color="000000">售房单位.*?'\'<td width="35%">(?P<developer>.*?)</td>.*?'\'编号</div></td>.*?<td width="25%">(?P<sPermitNo>.*?)</td>.*?'\'房屋坐落地点</div></td>.*?<td colspan="3">(?P<address>.*?)</td>.*?'\'项目名称</div></td>.*?<td colspan="3">(?P<projectName>.*?)</td>.*?'\'房屋用途性质</div></td>.*?<td colspan="3">(?P<houseUsage>.*?)</td>.*?'\'区属</div></td>.*?<td width="35%">(?P<areaName>.*?)</td>.*?'\'开盘日期</div></td>.*?<td width="25%">(?P<openDate>.*?)</td>', re.S)result = regex.finditer(html)for item in result:developer = item.group("developer")sPermitNo = item.group("sPermitNo")address = item.group("address")projectName = item.group("projectName")houseUsage = item.group("houseUsage")areaName = item.group("areaName")openDate = item.group("openDate")datas.append([developer, sPermitNo, address, projectName, houseUsage, areaName, openDate])print("抓取完毕!")dataDF = pd.DataFrame(data=datas, columns=columnNames)dataDF.to_excel('池州预售证抓取.xlsx', index=False)print("保存完毕!")
抓取结果:
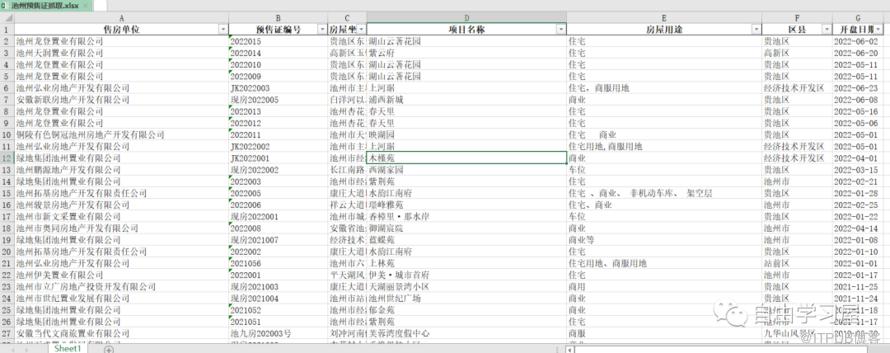
爬虫前进之路,任!我!行!
原文作者:数据派探险家;如有侵权,请联系管理员删除。
下一篇:
爬虫学习笔记(一)正则表达式

请登录后发表评论
登录
全部评论
最新文章
- 5个被过度高估的Python库(你绝对想不到)!
- 不掌握这10个Python概念,请不要自称高级开发人员(二)~~
- 不掌握这10个Python概念,请不要自称高级开发人员(一)~~
- 数据分析面试:你认为数据分析的价值如何体现?
- Python必知必会:使用 dedent() 方法优雅地展示多行字符串!
- Python必知必会:39个Python关键字详解,你的编程查阅小手册,收藏!
- Python必知必会:每个程序员都必须知道的22个Python单行代码!
- Python必知必会:15个令人相见恨晚的Python字符串格式化技巧!
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(二)
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(一)
