抓取入口:http://www.wxhouse.com/newslist?con.clsIcon=7bfc38d217981305aab84c70f11b152c

抓取思路:
在入口页面抓取周报标题和详情页面的URL地址;
拼接周报详情页面URL地址;
提取详情页面数据。
一、抓取周报标题及详情页面拼接地址
url = r'http://www.wxhouse.com/newslist?con.clsIcon=7bfc38d217981305aab84c70f11b152c'headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/102.0.0.0 Safari/537.36"}resp = requests.get(url=url, headers=headers)resp.encoding = 'utf-8'html = resp.text # 周报标题页面的html源代码# 提取周报标题及详情URL的正则表达式(每次只抓取最新一周的数据)regex = re.compile(r'<div class="blogs-list">.*?<a href="(?P<subURL>.*?)" target="_blank">'r'(?P<title>.*?)</a>', re.S)entryPage = regex.search(html) # 周报标题及URL信息subURL = entryPage.group("subURL")title = entryPage.group("title").strip()
二、拼接周报详情页面地址
baseURL = r'http://www.wxhouse.com/'detailURL = baseURL + subURLresp = requests.get(url=detailURL, headers=headers)resp.encoding = 'utf-8'
三、提取详情页面数据
regex2 = re.compile(r'本周商品房备案成交量和套数分析.*?全市商品房备案成交面积为(?P<houseDealArea>.*?)万平.*?'r'备案成交(?P<houseDealNum>\d+)套.*?本周商品住宅备案成交量和套数分析.*?'r'商品住宅备案成交面积为(?P<residenceDealArea>.*?)平.*?'r'备案成交套数为(?P<residenceDealNum>\d+)套.*?本周商业物业备案成交量和套数分析.*?'r'商业物业备案成交面积为(?P<businessDealArea>.*?)万平.*?'r'备案成交套数为(?P<businessDealNum>\d+)套.*?本周办公物业备案成交量和套数分析.*?'r'办公物业备案成交面积为(?P<officeDealArea>.*?)万平.*?'r'备案成交套数为(?P<officeDealNum>\d+)套.*?', re.S)dealInfo = regex2.search(resp.text)houseDealArea = dealInfo.group("houseDealArea") # 商品房备案成交面积(万平方米)houseDealNum = dealInfo.group("houseDealNum") # 商品房备案成交套数residenceDealArea = dealInfo.group("residenceDealArea") # 商品住宅备案成交面积(万平方米)residenceDealNum = dealInfo.group("residenceDealNum") # 商品住宅备案成交套数businessDealArea = dealInfo.group("businessDealArea") # 商业备案成交面积(万平方米)businessDealNum = dealInfo.group("businessDealNum") # 商业备案成交套数officeDealArea = dealInfo.group("officeDealArea") # 办公备案成交面积(万平方米)officeDealNum = dealInfo.group("officeDealNum") # 办公备案成交套数print(title + '。各物业类型备案成交情况如下:')print('商品房备案成交面积:'+ houseDealArea + ' 万平方米')print('商品房备案成交套数:'+ houseDealNum + ' 套')print('商品住宅备案成交面积:'+ residenceDealArea + ' 万平方米')print('商品住宅备案成交套数:'+ residenceDealNum + ' 套')print('商业物业备案成交面积:'+ businessDealArea + ' 万平方米')print('商业物业备案成交套数:'+ businessDealNum + ' 套')print('办公物业备案成交面积:'+ officeDealArea + ' 万平方米')print('办公物业备案成交套数:'+ officeDealNum + ' 套')
四、完整实现代码
import requestsimport re# 头URL,用于后续周报详情页面URL的拼接baseURL = r'http://www.wxhouse.com/'# 周报标题页面URLurl = r'http://www.wxhouse.com/newslist?con.clsIcon=7bfc38d217981305aab84c70f11b152c'headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/102.0.0.0 Safari/537.36"}resp = requests.get(url=url, headers=headers)resp.encoding = 'utf-8'html = resp.text # 周报标题页面的html源代码# 提取周报标题及详情URL的正则表达式(每次只抓取最新一周的数据)regex = re.compile(r'<div class="blogs-list">.*?<a href="(?P<subURL>.*?)" target="_blank">'r'(?P<title>.*?)</a>', re.S)entryPage = regex.search(html) # 周报标题及URL信息subURL = entryPage.group("subURL")title = entryPage.group("title").strip()# 提取成交套面的正则表达式regex2 = re.compile(r'本周商品房备案成交量和套数分析.*?全市商品房备案成交面积为(?P<houseDealArea>.*?)万平.*?'r'备案成交(?P<houseDealNum>\d+)套.*?本周商品住宅备案成交量和套数分析.*?'r'商品住宅备案成交面积为(?P<residenceDealArea>.*?)平.*?'r'备案成交套数为(?P<residenceDealNum>\d+)套.*?本周商业物业备案成交量和套数分析.*?'r'商业物业备案成交面积为(?P<businessDealArea>.*?)万平.*?'r'备案成交套数为(?P<businessDealNum>\d+)套.*?本周办公物业备案成交量和套数分析.*?'r'办公物业备案成交面积为(?P<officeDealArea>.*?)万平.*?'r'备案成交套数为(?P<officeDealNum>\d+)套.*?', re.S)# 拼接新闻详情页地址并提取数据detailURL = baseURL + subURLresp = requests.get(url=detailURL, headers=headers)resp.encoding = 'utf-8'dealInfo = regex2.search(resp.text)houseDealArea = dealInfo.group("houseDealArea") # 商品房备案成交面积(万平方米)houseDealNum = dealInfo.group("houseDealNum") # 商品房备案成交套数residenceDealArea = dealInfo.group("residenceDealArea") # 商品住宅备案成交面积(万平方米)residenceDealNum = dealInfo.group("residenceDealNum") # 商品住宅备案成交套数businessDealArea = dealInfo.group("businessDealArea") # 商业备案成交面积(万平方米)businessDealNum = dealInfo.group("businessDealNum") # 商业备案成交套数officeDealArea = dealInfo.group("officeDealArea") # 办公备案成交面积(万平方米)officeDealNum = dealInfo.group("officeDealNum") # 办公备案成交套数print(title + '。各物业类型备案成交情况如下:')print('商品房备案成交面积:'+ houseDealArea + ' 万平方米')print('商品房备案成交套数:'+ houseDealNum + ' 套')print('商品住宅备案成交面积:'+ residenceDealArea + ' 万平方米')print('商品住宅备案成交套数:'+ residenceDealNum + ' 套')print('商业物业备案成交面积:'+ businessDealArea + ' 万平方米')print('商业物业备案成交套数:'+ businessDealNum + ' 套')print('办公物业备案成交面积:'+ officeDealArea + ' 万平方米')print('办公物业备案成交套数:'+ officeDealNum + ' 套')
输出抓取结果:
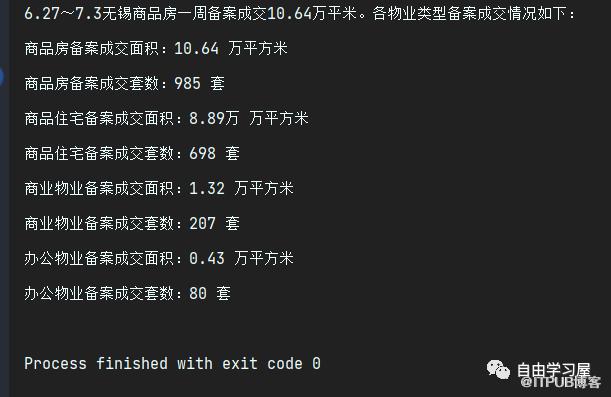
当然,我们可以将抓取到的数据保存到数据库(如MySQL或SQLserver)或者输出到文件中(如Excel或CSV等)。实现方法也很简单,有兴趣的小伙伴可以自己尝试。
爬虫前进之路,任!我!行!
原文作者:数据派探险家;如有侵权,请联系管理员删除。
上一篇:
数据工程师面试中最常问的复杂SQL查询
下一篇:
正则表达式案例:池州商品房预售证信息抓取

请登录后发表评论
登录
全部评论
最新文章
- 5个被过度高估的Python库(你绝对想不到)!
- 不掌握这10个Python概念,请不要自称高级开发人员(二)~~
- 不掌握这10个Python概念,请不要自称高级开发人员(一)~~
- 数据分析面试:你认为数据分析的价值如何体现?
- Python必知必会:使用 dedent() 方法优雅地展示多行字符串!
- Python必知必会:39个Python关键字详解,你的编程查阅小手册,收藏!
- Python必知必会:每个程序员都必须知道的22个Python单行代码!
- Python必知必会:15个令人相见恨晚的Python字符串格式化技巧!
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(二)
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(一)
