「引言」
"成为SQL大师的秘诀在这里!🏆
把SQL(Structured Query Language,结构化查询语言)想象成数据世界的瑞士军刀。在这个由数据构建的宇宙里,没有什么是一点SQL魔法解决不了的。
随着数据量的增长,像侦探一样寻找线索的数据专家越来越受欢迎。仅仅了解高级SQL概念可不够哦,你得像魔法师一样在工作中娴熟地施展它们。面试时,这可是赢得数据科学职位的法宝!
因此,我在这里列出了5个高级SQL概念,每个概念都配有解释和查询示例,助你在2022年成为数据界的魔法大师。
我特意将这篇文章保持简短,让你能快速阅读完毕,掌握这些必知的、让面试官眼前一亮的SQL技巧。🏆
目录
公共表表达式(Common Table Expressions, CTEs) 排序函数:ROW_NUMBER() vs RANK() vs DENSE_RANK() CASE WHEN 语句 根据日期-时间列提取数据 自连接(SELF JOIN)
📍示例数据:使用Faker创建的虚拟销售数据,文末获取。
. . .
公共表表达式(Common Table Expressions, CTEs)
在处理现实世界数据时,有时你需要查询另一个查询的结果。一种简单的实现方法是使用子查询。
然而,随着复杂性的增加,计算子查询变得难以阅读和调试。
这时,公共表表达式(CTEs)就派上用场,让你的工作变得更加轻松。CTEs 使复杂查询的编写和维护变得更简单。✅
例如,考虑使用以下子查询进行数据提取:
SELECT sales_manager, product_category, unit_price
FROM dummy_sales_data
WHERE sales_manager IN (SELECT DISTINCT sales_manager
                        FROM dummy_sales_data
                        WHERE shipping_address = 'Germany'
                          AND unit_price > 150)
  AND product_category IN (SELECT DISTINCT product_category
                           FROM dummy_sales_data
                           WHERE product_category = 'Healthcare'
                             AND unit_price > 150)
ORDER BY unit_price DESC;
在这里,我仅使用了两个易于理解的子查询。
即使如此,要跟踪这些查询仍然很困难,更不用说当你在子查询中增加更多计算,或者甚至添加更多子查询时 —— 复杂性增加,使得代码的可读性和维护难度随之增加。
现在,让我们看看使用公共表表达式将上述子查询简化后的版本,如下所示:
WITH SM AS
         (SELECT DISTINCT sales_manager
          FROM dummy_sales_data
          WHERE shipping_address = 'Germany'
            AND unit_price > 150),
     PC AS
         (SELECT DISTINCT product_category
          FROM dummy_sales_data
          WHERE product_category = 'Healthcare'
            AND unit_price > 150)
SELECT sales_manager, product_category, unit_price
FROM dummy_sales_data
WHERE sales_manager IN (SELECT sales_manager FROM SM)
  AND product_category IN (SELECT product_category FROM PC)
ORDER BY unit_price DESC ;
复杂的子查询被分解为更简单的代码块。
通过这种方式,复杂的子查询被重写为两个更容易理解和修改的公共表表达式(CTE)SM和PC。🎯
以上两个查询执行时间相同,结果如下所示:
公共表表达式(CTE)本质上允许您根据查询结果创建一个临时表。这提高了代码的可读性和维护性。✅
现实世界的数据集可能有数百万或数十亿行,占用数千GB的存储空间。直接使用这些表中的数据进行计算,尤其是将它们与其他表连接起来,将是非常昂贵的。
对于此类任务的最佳解决方案是使用CTE。💯
接下来,让我们看看如何使用窗口函数为数据集中的每一行分配一个整数排名。
. . .
排序函数:ROW_NUMBER() vs RANK() vs DENSE_RANK()
在处理真实数据集时,另一个常用的概念是记录排名。公司会在不同场景中用到排名,例如:
按销售单位数排名最畅销品牌 按订单数或产生的收入排名最佳产品类别 获取每个类型中观看次数最多的电影名称
ROW_NUMBER、RANK()和DENSE_RANK()基本上用于为结果集中指定分区的每条记录分配连续的整数。
它们之间的区别在于当某些记录出现并列时就变得明显。
当结果表中存在重复行时,为每条记录分配整数的行为和方式会有所不同。✅
接下来,我们将通过一个虚构的销售数据集示例,按运费降序列出所有产品类别和送货地址。
SELECT product_category,
       shipping_address,
       shipping_cost,
       ROW_NUMBER() OVER
           (PARTITION BY product_category,
               shipping_address
           ORDER BY shipping_cost DESC) AS rowNumber,
       RANK() OVER
           (PARTITION BY product_category,
               shipping_address
           ORDER BY shipping_cost DESC)    rankValues,
       DENSE_RANK() OVER
           (PARTITION BY product_category,
               shipping_address
           ORDER BY shipping_cost DESC)    denseRankValues
FROM dummy_sales_data
WHERE product_category IS NOT NULL
  AND shipping_address NOT IN ('Germany', 'India')
  AND status IN ('Delivered');
如你所见,这三个函数的语法都相同,但其输出却有所不同,如下所示:
RANK() 函数根据 ORDER BY 子句的条件检索排名行。可以看到,前五行之间存在并列,即前五行在 Shipping_Cost 列(在 ORDER BY 子句中提到的列)中的值相同。
RANK 为这五行分配了相同的整数。然而,它将重复行的数量加到重复的排名上,以获得下一行的排名。这就是为什么第六行(标记为红色)的 RANK 分配了排名 6(5个重复行 + 1个重复排名)。
DENSE_RANK 与 RANK 类似,但即使行之间存在并列,它也不会跳过任何数字。这可以在上图的绿色框中看到。
与上面两个不同的是,ROW_NUMBER 简单地为分区中的每条记录按顺序分配数字,从1开始。如果它在同一分区中检测到两个相同的值,它会为这两个值分配不同的排名数字。
对于产品类别 — 运送地址的下一个分区 → Entertainment — Italy,三个函数的排名都会重新从1开始,如下所示:
如果在 ORDER BY 子句中使用的列中没有重复值,那么这三个函数将返回相同的输出。💯
接下来,下一个概念将更多地介绍如何使用条件语句和数据透视。
. . .
CASE WHEN 语句
CASE语句允许你在SQL中实现if-else逻辑,因此你可以使用它来执行条件查询。
CASE语句本质上测试WHEN子句中提到的条件,并返回THEN子句中提到的值。当没有条件满足时,它将返回ELSE子句中提到的值。✅
在处理真实数据项目时,CASE语句经常用于根据其他列中的值对数据进行分类。它也可以与聚合函数一起使用。
例如,让我们再次使用虚构的销售数据,根据数量将销售订单分类为高、中、低量级。
SELECT order_id,
       order_date,
       sales_manager,
       quantity,
       CASE
           WHEN quantity > 51 THEN 'High'
           WHEN quantity < 51 THEN 'Low'
           ELSE 'Medium' END AS orderVolume
FROM dummy_sales_data;
简单地说,它创建了一个新列 OrderVolume,并根据 Quantity 列中的值添加了‘High’(高)、‘Low’(低)、‘Medium’(中)等值。
📌 你可以包含多个 WHEN..THEN 子句,并且可以省略 ELSE 子句,因为它是可选的。
📌 如果你没有提到 ELSE 子句并且没有条件满足,查询将会为那个特定记录返回 NULL。
CASE 语句的另一个经常使用但较少为人知的用途是 — 数据透视。
数据透视是一种重新排列结果集中的列和行的过程,以便你可以从不同的角度查看数据。
有时你处理的数据是长格式的(行数 > 列数),而你需要将其转换为宽格式(列数 > 行数)。
在这种情况下,CASE语句非常有用。💯
例如,让我们找出每个销售经理在新加坡、英国、肯尼亚和印度处理的订单量:
SELECT sales_manager,
       COUNT(CASE
                 WHEN shipping_address = 'Singapore' THEN order_id
           END) AS Singapore_orders,
       COUNT(CASE
                 WHEN shipping_address = 'UK' THEN order_id
           END) AS UK_orders,
       COUNT(CASE
                 WHEN shipping_address = 'Kenya' THEN order_id
           END) AS Kenya_orders,
       COUNT(CASE
                 WHEN shipping_address = 'India' THEN order_id
           END) AS India_orders
FROM dummy_sales_data
GROUP BY sales_manager;
使用 CASE..WHEN..THEN,我们为每个运送地址创建了单独的列,以获得以下期望的输出:
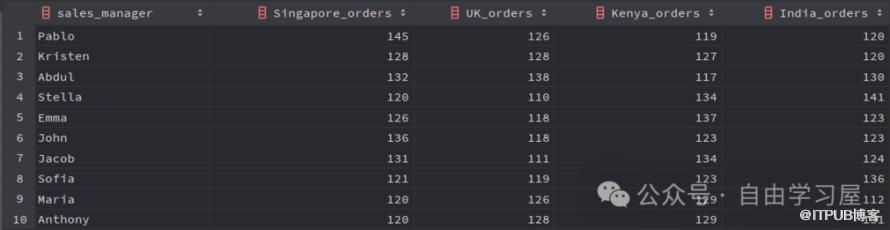 根据你的使用情况,你也可以与
CASE 语句一起使用不同的聚合函数,如 SUM(总和)、AVG(平均值)、MAX(最大值)、MIN(最小值)。
接下来,在处理真实世界数据时,经常包含日期时间值。因此,了解如何提取日期时间值的不同部分,如月份、周数、年份,是很重要的。
. . .
根据日期-时间列提取数据
在许多面试中,面试官可能会要求你按月聚合数据或计算特定月份的某个指标。
当数据集中没有单独的月份列时,你需要从数据中的日期时间变量中提取所需的日期部分。
不同的SQL环境有不同的函数来提取日期的部分。通常,在MySQL中,你应该了解以下函数:
EXTRACT(part_of_date FROM date_time_column_name)
YEAR(date_time_column_name)
MONTH(date_time_column_name)
MONTHNAME(date_time_column_name)
DATE_FORMAT(date_time_column_name)
比如,使用前面虚拟销售数据集,我们可以计算每个月的总订单量:
SELECT MONTH(order_date) AS month,
       SUM(quantity) AS total_quantity
FROM dummy_sales_data
GROUP BY MONTH(order_date);
如果你用的是SQLite DB Browser,你需要使用strftime()函数来提取日期部分,如下所示。你需要在strftime()中使用%m来提取月份。
SELECT strftime('%m', order_date) as month,
       SUM(quantity) as total_quantity
from dummy_sales_data
GROUP BY strftime('%m', order_date)
如果使用EXTRACT()函数,则用以下代码:
SELECT EXTRACT(MONTH FROM order_date) AS month,
       SUM(quantity) AS total_quantity
FROM dummy_sales_data
GROUP BY EXTRACT(MONTH FROM order_date);
下图展示了最常提取的日期部分,以及你在使用EXTRACT函数时应该使用的关键字:
最后但不可或缺的是:
你经常会在现实世界中看到,数据是存储在一个大表中,而不是多个小表中。这时,自连接(SELF JOIN)就派上用场了,它在处理这些数据集时解决了一些有趣的问题。
. . .
自连接(SELF JOIN)
与SQL中的其他连接一样,唯一的区别就是——在自连接中你是将表和自身进行连接。
记住,没有SELF JOIN关键字,所以当连接中的两个表是同一个表时,你只需使用JOIN。由于两个表名相同,在使用自连接时使用表别名是必要的。✅
编写一个SQL查询,找出那些赚得比他们经理多的员工 — 这是关于自连接在面试中最常被问到的问题之一。
例如,创建一个像下面的虚拟员工数据集(Dummy_Employees):
尝试使用下面这个查询找出哪些员工处理的订单数量超过他们的经理:
SELECT t1.EmployeeName, t1.TotalOrders
FROM Dummy_Employees AS t1
JOIN Dummy_Employees AS t2
ON t1.ManagerID = t2.EmployeeID
WHERE t1.TotalOrders > t2.TotalOrders;
正如预期,它返回了处理的订单数量超过他们经理的员工——Abdul和Maria。
几乎80%的面试中都遇到了这个问题。因此,这是自连接(SELF JOIN)的经典案例。
. . .
结论(Conclusion)
以上就是我想给给大家分享的5个高级SQL概念及其实际应用。
希望你能快速读完这篇文章,并且发现它对提升你的SQL技能有所帮助。
示例数据获取:关注我,回复关键字“虚拟销售数据”即可获取文章的示例数据。动手永远是学习效率最高的方式,赶快行动起来吧!
. . .
如果你觉得这篇文章对你有用,请“点赞➕在看➕分享➕关注”支持我,你的点赞和关注就是我持续创作分享的动力,让更多的朋友发现并加入我们,共同学习和进步!
Thank you for reading!
- END -
推荐阅读👇👇👇
2024年SQL从新手到高手学习路线:附学习资源(赶紧收藏~~)
原文作者:数据派探险家;如有侵权,请联系管理员删除。

最新文章
- 5个被过度高估的Python库(你绝对想不到)!
- 不掌握这10个Python概念,请不要自称高级开发人员(二)~~
- 不掌握这10个Python概念,请不要自称高级开发人员(一)~~
- 数据分析面试:你认为数据分析的价值如何体现?
- Python必知必会:使用 dedent() 方法优雅地展示多行字符串!
- Python必知必会:39个Python关键字详解,你的编程查阅小手册,收藏!
- Python必知必会:每个程序员都必须知道的22个Python单行代码!
- Python必知必会:15个令人相见恨晚的Python字符串格式化技巧!
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(二)
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(一)
