哈喽,各位在学习的伙伴大家好啊,今天笔者将与大家分享如何评估顺序分类数据的相关性。
假设你有一个顺序分类特征。你想评估它与其他连续特征的相关性。
顺序特征:在类别中具有自然顺序的分类数据
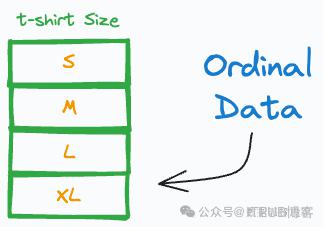
在进行相关性分析之前,你需要对该特征进行编码,这是一项常规操作。
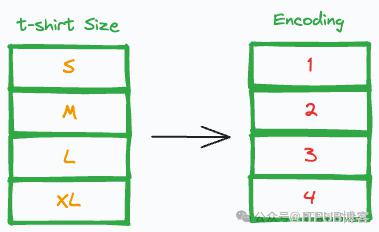 |
顺序数据编码
然而,许多人不知道,编码的选择会对相关性结果有极大的影响。
例如,考虑以下数据集:
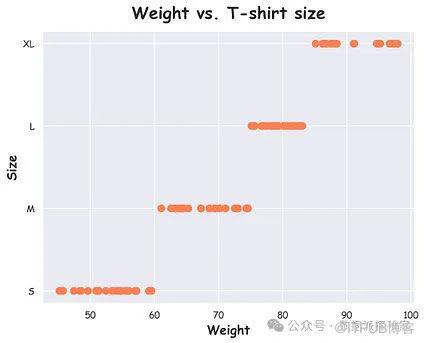 |
体重 vs. T 恤尺码数据
这里,我们有:
顺序分类特征:T 恤尺码 (S, M, L, XL)。
-
一个连续的特征:重量。
如果我们从图形上看,这两个特征之间确实存在单调关系。
然而,如下所示,改变分类编码会影响皮尔逊相关性(Pearson correlation)。
|
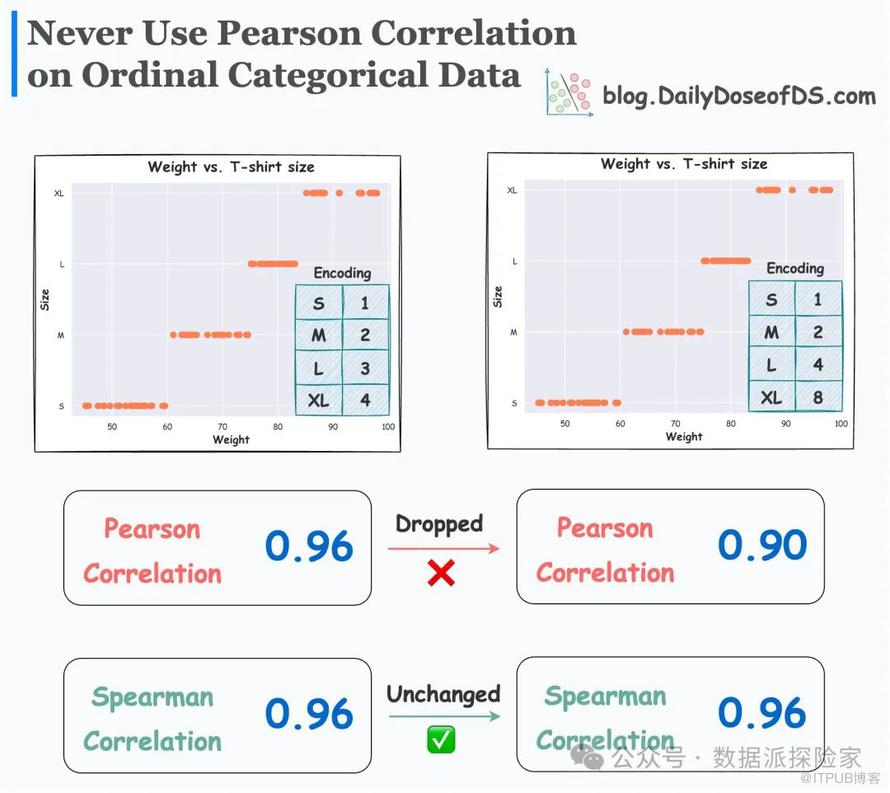
在左图中,我们有以下编码→S(1)、M(2)、L(3) 和 XL(4)。 -
在右图中,我们有以下编码→S(1)、M(2)、L(4) 和 XL(8)。
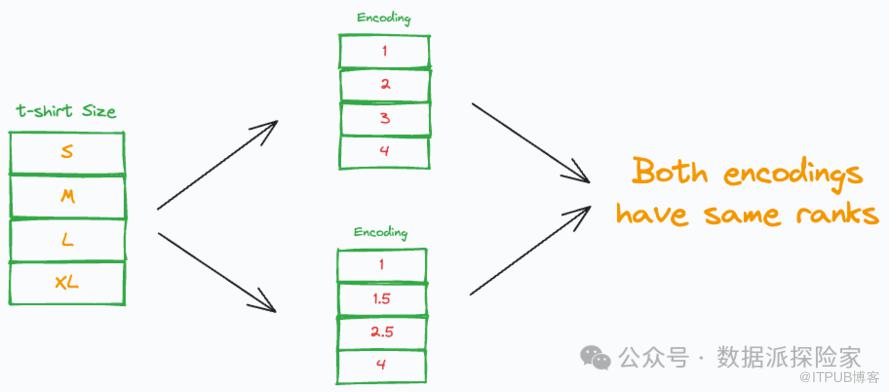
无论选择哪种分类编码,它始终保持不变。这是因为 Spearman 相关性是基于等级的。
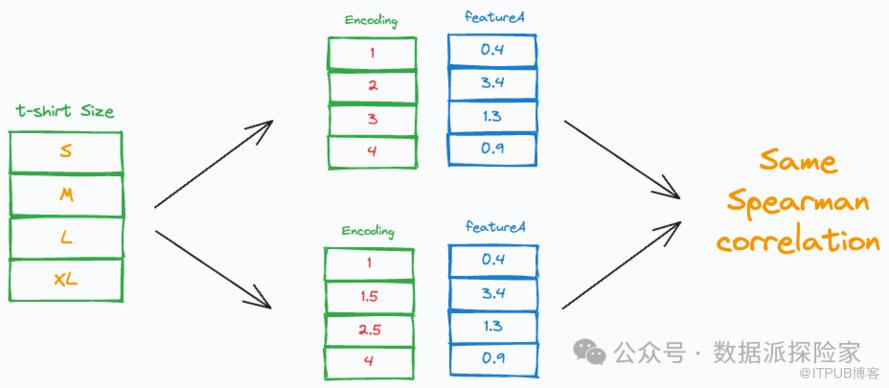 |
不同的顺序编码得到相同的 Spearman 相关性
它对数据的等级进行操作,这使得它更适合这种相关性分析的情况。
 |
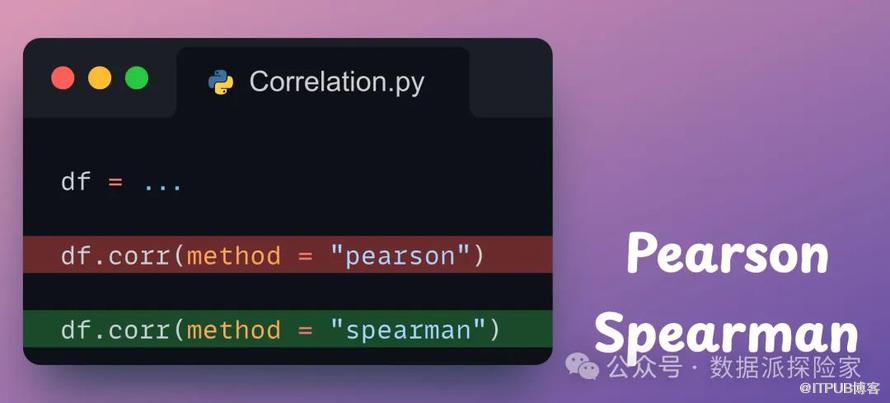
使用 Spearman 相关性也非常简单。例如,如果您使用 Pandas,只需按如下方式指定所需的相关性度量即可:
 |
皮尔逊相关性和Spearman相关性实现案例
假设我们有如下关于体重和T恤尺码关系的数据集:
| 体重(kg) |
T恤尺码 |
| 55 |
S |
| 60 |
M |
| 65 |
M |
| 70 |
L |
| 75 |
L |
| 80 |
XL |
| 85 |
XL |
| 90 |
XXL |
| 95 |
XXL |
| 100 |
XXL |
由于T恤尺码是分类数据,我们需要将其转换为数值数据。假设我们将T恤尺码按以下方式转换:
S: 1
M: 2
L: 3
XL: 4
XXL: 5
| 体重(kg) |
T恤尺码 |
| 55 |
1 |
| 60 |
2 |
| 65 |
2 |
| 70 |
3 |
| 75 |
3 |
| 80 |
4 |
| 85 |
4 |
| 90 |
5 |
| 95 |
5 |
| 100 |
5 |
使用 Python 来计算皮尔逊相关性和 Spearman 相关性:
import pandas as pdfrom scipy.stats import pearsonr, spearmanr# 数据集data = {"体重(kg)": [55, 60, 65, 70, 75, 80, 85, 90, 95, 100],"T恤尺码(数值)": [1, 2, 2, 3, 3, 4, 4, 5, 5, 5]}df = pd.DataFrame(data)# 计算皮尔逊相关系数pearson_corr, pearson_p_value = pearsonr(df['体重(kg)'], df['T恤尺码(数值)'])# 计算Spearman相关系数spearman_corr, spearman_p_value = spearmanr(df['体重(kg)'], df['T恤尺码(数值)'])pearson_corr, spearman_corr
Result(0.9753213044447562, 0.9785579990862868)
根据计算结果,体重和T恤尺码的皮尔逊相关系数为
具体来说:
皮尔逊相关系数(Pearson correlation coefficient)度量的是变量之间线性关系的强度和方向。在本例中,皮尔逊相关系数为0.975,表明体重和T恤尺码之间存在很强的正线性关系。 Spearman相关系数(Spearman correlation coefficient)度量的是变量之间的单调关系的强度和方向(不要求线性关系)。在本例中,Spearman相关系数为0.979,表明体重和T恤尺码之间存在很强的正单调关系。
假设我们将T恤尺码转换为以下数值:
S: 1
M: 10
L: 20
XL: 30
XXL: 40
# 修改后的数据集data_modified = {"体重(kg)": [55, 60, 65, 70, 75, 80, 85, 90, 95, 100],"T恤尺码(数值)": [1, 10, 10, 20, 20, 30, 30, 40, 40, 40]}df_modified = pd.DataFrame(data_modified)# 计算皮尔逊相关系数(修改后)pearson_corr_modified, pearson_p_value_modified = pearsonr(df_modified['体重(kg)'], df_modified['T恤尺码(数值)'])# 计算Spearman相关系数(修改后)spearman_corr_modified, spearman_p_value_modified = spearmanr(df_modified['体重(kg)'], df_modified['T恤尺码(数值)'])pearson_corr_modified, spearman_corr_modified
Result(0.9763486575478035, 0.9785579990862868)
根据计算结果,体重和T恤尺码在修改后的数值转换下,皮尔逊相关系数为
具体来说:
皮尔逊相关系数(Pearson correlation coefficient)在修改前为 0.975 0.976 Spearman相关系数(Spearman correlation coefficient)在修改前后均为 0.979
这验证了皮尔逊相关系数会因转换比例的改变而受影响,而Spearman相关系数不会,因为它只考虑变量的排序关系,而不考虑具体数值。
👉 文末小问题:其他还有哪些特征可以确定分类数据和连续数据之间的相关性?
推荐阅读👇👇👇
10个Python自动化脚本,简化日常工作任务,看看有没有适合你的!
Python自动化:10个令人惊叹的自动化脚本,拿来即用,总有一款适合你!
Python高级编程:Functools模块的8个高级用法,强烈建议添加到你的开发工具箱中!
- END -
🌟 喜欢这篇文章吗?给个赞支持一下吧!🌟
如果你发现今天的内容对你有帮助,不妨点个赞并关注我,第一时间接收更多关于Python、数据分析和机器学习的深入分析和最新趋势。我们一起探索数据的力量,解锁AI的潜能。你的每一次互动都是对我的极大鼓励,也是我们共同成长的动力!

👇👇👇 关注并开启星标提醒,让知识与技能的火花不断在你的职业道路上燃烧吧!
原文作者:数据派探险家;如有侵权,请联系管理员删除。

最新文章
- 5个被过度高估的Python库(你绝对想不到)!
- 不掌握这10个Python概念,请不要自称高级开发人员(二)~~
- 不掌握这10个Python概念,请不要自称高级开发人员(一)~~
- 数据分析面试:你认为数据分析的价值如何体现?
- Python必知必会:使用 dedent() 方法优雅地展示多行字符串!
- Python必知必会:39个Python关键字详解,你的编程查阅小手册,收藏!
- Python必知必会:每个程序员都必须知道的22个Python单行代码!
- Python必知必会:15个令人相见恨晚的Python字符串格式化技巧!
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(二)
- 24个令人眼前一亮的Python技巧—提升你的代码水平和质量(一)
