回复“书籍”即可获赠Python从入门到进阶共10本电子书
大家好,我是Python进阶者。
一、前言
前几天在帮助粉丝解决问题的时候,遇到一个简单的小需求,这里拿出来跟大家一起分享,后面再次遇到的时候,可以从这里得到灵感。
二、需求澄清
粉丝的问题来源于实际的需求,她的Excel文件中现有20行数据,需要使用Python实现这个Excel文件中每3行存一个Excel文件。下图是原始数据:
如果是正常操作的话,肯定是点击进去Excel文件,然后每三行进行复制,然后粘贴到新文件,然后保存,之后重命名。
这样做肯定是可以,但是当有上百个文件夹需要复制呢?上千个文件呢?肯定就需要消耗大量的时间和精力了。估计一天都不一定完成的了。
这里使用Python进行批量实现!
下面这个代码是初始代码,如果只是10行,可以这么写。这要是1000行,你准备怎么写?你代码不得写300+行?
import pandas as pd

df = pd.read_excel('res.xlsx')
df.set_index(["A"]).reset_index()
df.iloc[: 3].to_excel('1.xlsx')
df.iloc[3: 6].to_excel('2.xlsx')
df.iloc[6: 9].to_excel('3.xlsx')
df.iloc[10].to_excel('4.xlsx')
三、实现过程
这里给大家提供一个可行的代码,思路也很简单,for循环加步长,代码如下:
import pandas as pd

df = pd.read_excel('res.xlsx')
# df.set_index(["A"]).reset_index()
for i in range(len(df) // 3 + 1):
    df.iloc[3 * i: 3 * (i + 1)].to_excel(f'{i}.xlsx')
代码运行之后,就可以实现该Excel文件中每3行数据存一个Excel文件了。再也不用挨个去手动复制粘贴了,使用Python事半功倍!
下图是第一个文件: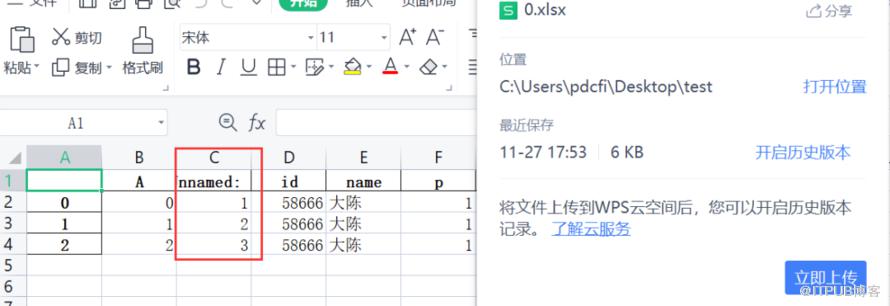
下图是最后一个文件,因为总共是10条数据,每三行存一个文件的话,第10行的话,需要单独放一个文件,所以看到的文件只有一行数据了。
三、总结
大家好,我是皮皮。这篇文章主要盘点一个Python自动化办公的实用案例,这个案例可以适用于实际工作中文件处理,大家也可以稍微改进下,用于自己的实际工作中去,举一反三。
感谢【瑜亮老师】、【猫药师Kelly】大佬给出的思路和建议,学习到了很多,应该还有其他更好的方法,欢迎大家留言区留言。
大家在学习过程中如果有遇到问题,欢迎随时联系我解决(我的微信:pdcfighting),应粉丝要求,我创建了一些高质量的Python付费学习交流群和付费接单群,欢迎大家加入我的Python学习交流群和接单群!
小伙伴们,快快用实践一下吧!如果在学习过程中,有遇到任何问题,欢迎加我好友,我拉你进Python学习交流群共同探讨学习。
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

