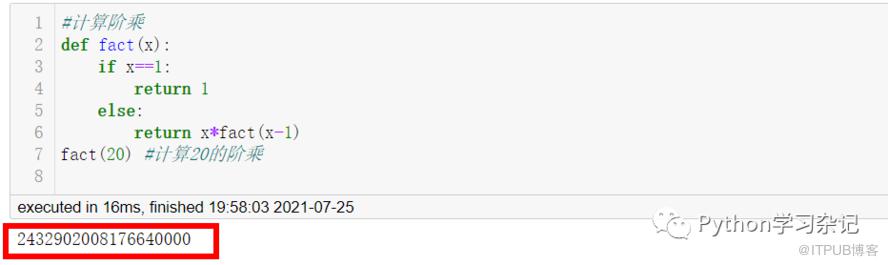
遗传算法是优化求解常用的一种启发式算法,其原理是模拟进化的过程,包括交叉遗传、突变、选择等方式繁衍后代,计算机通过模拟这些算子,优中选优,通过一次次迭代、繁衍,这些过程的目的就是搜索最优解。运输问题里最经典的tsp问题,是个np-难题(多一个节点,其解的可能性按指数级别上升),很难通过枚举法寻找最优解。比如有20个节点,其运输的可能性就是:20!,其结果为19位数。一般的计算机难以短时间运算出其最优解。根据主流学者的研究,遗传算法解决此类问题效果较好。(完整代码已放在本文最后。)
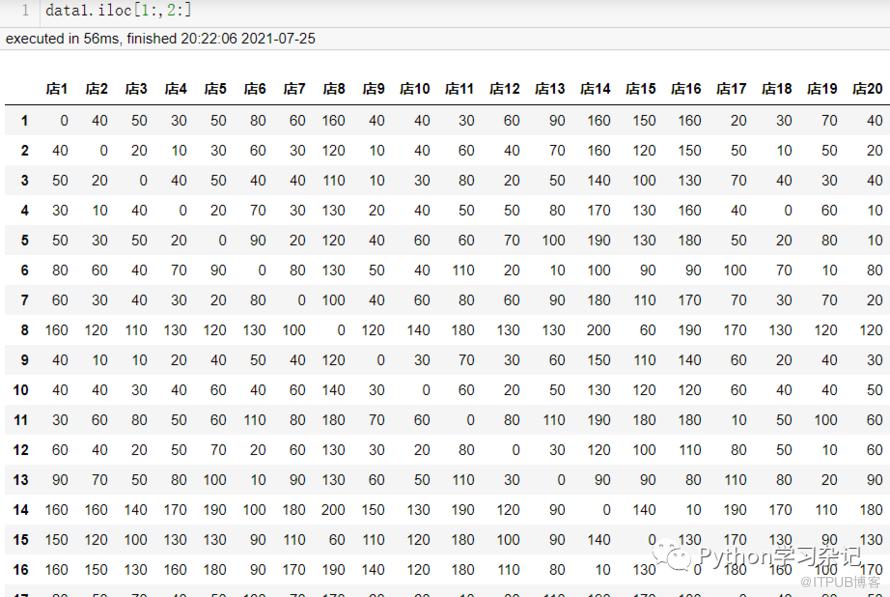
1.导入数据


2.构建一个种群(编码并设置参数)
2.构建适应度函数
3.轮盘筛选(算子1,优秀的父本被选择的概率高)
4.变异(算子2)
5.交叉(算子3)
6.进化至下一代
7.绘图
8.完整代码
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
data1=pd.read_excel('datatsp.xlsx',sheet_name=0)
distance_matrix0=data1.iloc[0:,1].values #出发点到各个点的距离
distance_matrixnew=data1.iloc[1:,2:].values#经过的20个点的距离矩阵
#计算总距离的时候由0到第一个点的距离+城市总距离+最后一个城市到0的距离
best_everygeneration=[]#后面存储每一代的最优路径
lx=[]#后面存储x坐标,即迭代次数
ly=[]#存储每一代的最优值
N_CITIES = 20  # DNA size 起点不放进去,20个城市
CROSS_RATE = 0.2 #交叉系数
MUTATE_RATE = 0.01 #变异系数
POP_SIZE = 2000 #种群数
N_GENERATIONS =2000#迭代次数
class GA(object):
    def __init__(self, DNA_size, cross_rate, mutation_rate, pop_size, ):
        self.DNA_size = DNA_size
        self.cross_rate = cross_rate
        self.mutate_rate = mutation_rate
        self.pop_size = pop_size
        self.pop = np.vstack([np.random.permutation(DNA_size)+1 for _ in range(pop_size)])
    def get_fitness(self, qq):
        total_distance = np.empty((len(qq)), dtype=np.float64)
        for i,t in enumerate(qq):
            m=0
            for p in range(len(t)-1):
                m+=distance_matrixnew[t[p]-1][t[p+1]-1]
            m+=distance_matrix0[t[0]]+distance_matrix0[t[-1]]
            total_distance[i]=m
        fitness = 1/total_distance #距离的倒数做适应度,距离越小适应度越高,适应度适当放大。
        return fitness, total_distance
    def select(self, fitness):    #轮盘筛选选出较优的父母,可重复
        idx = np.random.choice(np.arange(self.pop_size), size=self.pop_size, replace=True, p=fitness / fitness.sum())
        return self.pop[idx]

    def crossover(self, parent, pop):
        if np.random.rand() < self.cross_rate:
            i_ = np.random.randint(0, self.pop_size, size=1) #随机选择一个pop的编号,后面该母体选址一部分基因
            cross_points = np.random.randint(0, 2, self.DNA_size).astype(bool)  #随机选择要发生交叉变化的点
            keep_city = parent[~cross_points]  # find the city number
            swap_city = pop[i_, np.isin(pop[i_].ravel(), keep_city, invert=True)]#筛选出另一个母体剩下的基因(城市)
            parent[:] = np.concatenate((keep_city, swap_city))#合并交叉选择的母体
        return parent    #生成一个单一父本, 比如【0,1,2,3,4】交叉时1,3不变,024,按照母体【1,2,4,0,3】排列,则新的样本为【1,3,2,4,0】

    def mutate(self, child):
        for point in range(self.DNA_size):
            if np.random.rand() < self.mutate_rate:
                swap_point = np.random.randint(0, self.DNA_size) #随机生成变异点
                swapA, swapB = child[point], child[swap_point]  #对应两个点选出来
                child[point], child[swap_point] = swapB, swapA #交换两个点
        return child#与上一步类似,但是本次是变异如【0,1,2,3,4】,两个点位置交换【0,1,2,4,3】

    def evolve(self, fitness):    #进化至下一代
        pop0=self.pop.copy()
        pop = self.select(fitness)
        pop_copy = pop.copy()
        #print(pop0)  #看是否需要打印全部路线
        print('本次迭代最优路线',np.concatenate(([0],pop0[best_idx],[0])))
        best_everygeneration.append(np.concatenate(([0],pop0[best_idx],[0])))
        for parent in pop:  # for every parent对pop里面的每一个dna都按概率进行交叉、变异,最后生成一个新的pop
            child = self.crossover(parent, pop_copy) #交叉生成新的后代
            child = self.mutate(child) #后代中少量发生变异
            parent[:] = child #生成新的一代做为新的父母繁衍后代
        self.pop = pop
ga = GA(DNA_size=N_CITIES, cross_rate=CROSS_RATE, mutation_rate=MUTATE_RATE, pop_size=POP_SIZE)
for generation in range(1,N_GENERATIONS+1):
    fitness, total_distance = ga.get_fitness(ga.pop)
    best_idx = np.argmax(fitness)
    ga.evolve(fitness)#打印出路线
    lx.append(generation)
    ly.append(total_distance[best_idx])
    print('Gen:', generation, '| best fit: %.5f' % fitness[best_idx])
    print(total_distance[best_idx])

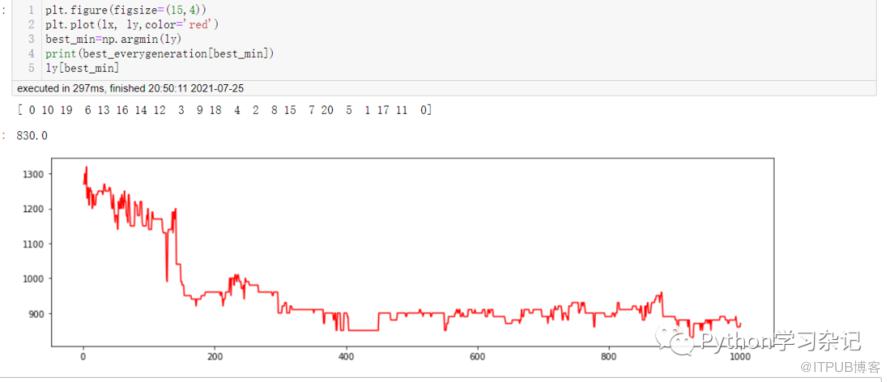
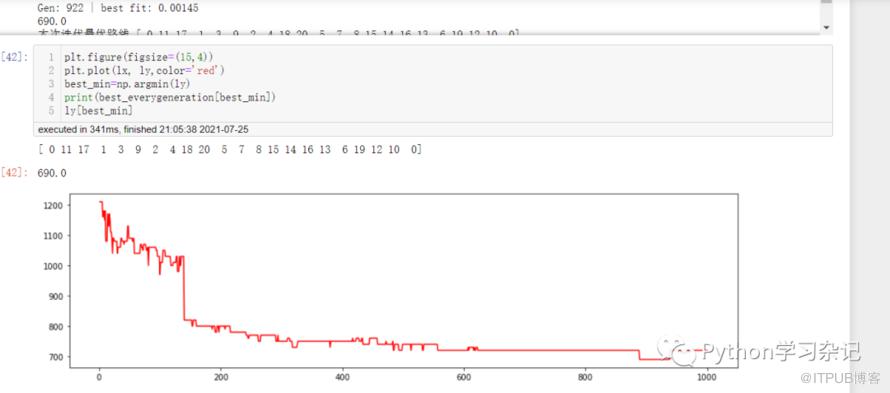
看迭代的效果图,明显还有提高的空间。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
Python粒子群算法实现
下一篇:
Python搭建虚拟环境

请登录后发表评论
登录
全部评论
