粒子群算法把优化问题的初始解看作是空中觅食的鸟群,鸟群会往通过个体的飞行路径及群体交流,往食物多的地方飞行。一个粒子对应的一个优化问题的解。每个优化问题的解都是搜索空间中的一只鸟。我们称之为“粒子”。所有的粒子都有一个由被优化的函数决定的适应值(fitness),每个粒子还有一个速度决定他们飞翔的方向和距离。然后粒子们就追随当前的最优粒子在解空间中搜索。
粒子算法的核心是每个粒子朝着个体粒子历史最优方向及群体粒子最优方向的加权形成新的移动方向,其移动方向与几个因素有关: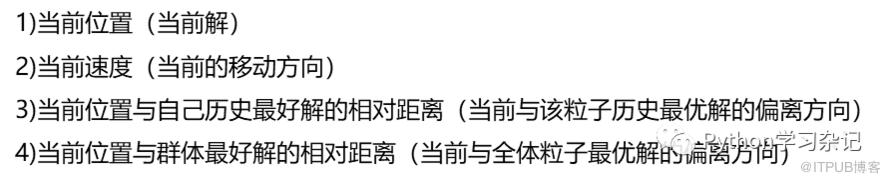 其速度和位移更新公式如下:
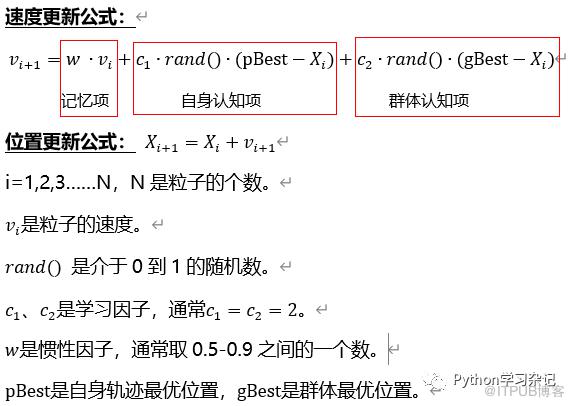
1.初始化参数
2.编写适应度函数
2.编写速度和位移更新公式
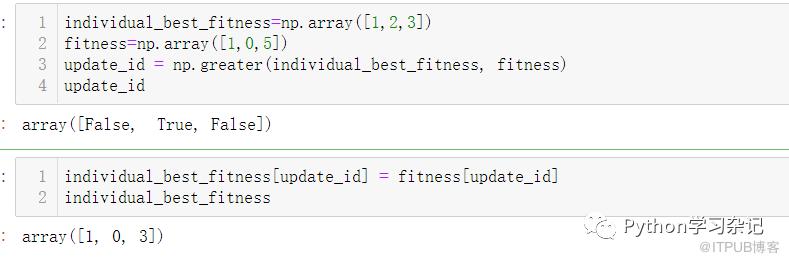
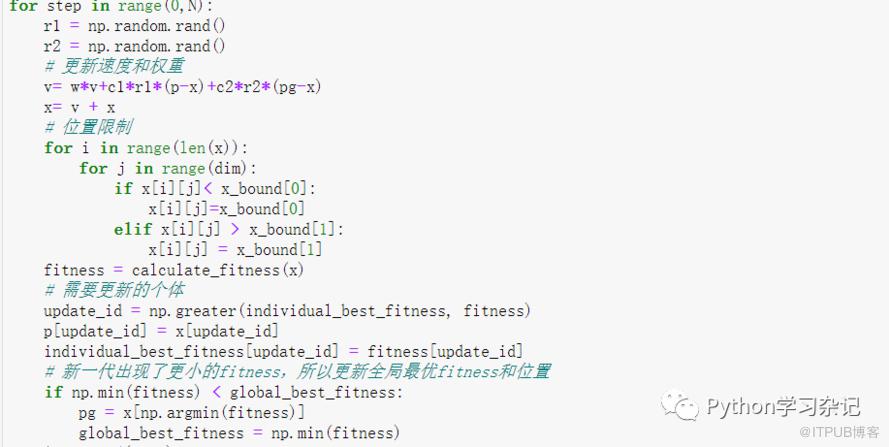 这一步是最关键的,里面的细节很多,简单给大家介绍一下几个常见的处理方式。numpy中的数据比较,按照比较后的结果更新数据。比较新的粒子的适应度函数,如果新的粒子适应度函数效果更好,就代替旧的。以下就是比较方法,用到了numpy的greater函数。
 有一些粒子的位置可能已经冲破了限定的范围,这里需要处理一下,移动到边界点
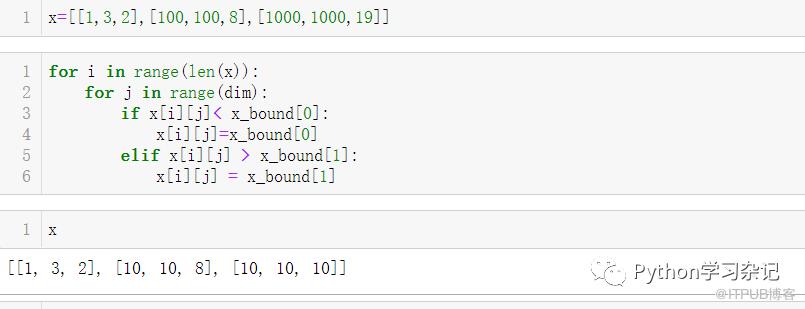 处理后,新的粒子在-10到10取值之间。
3.完整代码及输出结果
import numpy as np
import matplotlib.pyplot as plt
dim = 3  # 搜索空间的维度,x的变量个数
def calculate_fitness(x):
    sum1=[]
    for i in range((len(x))):
        sum1.append(x[i][0]**2+x[i][1]**2-x[i][2]**3)
    return np.array(sum1)
population_size = 10# 粒子群数量
N=50#迭代次数
w = 0.5  # 惯性权重
c1 =2
c2 =2
x_bound = [-10,10]  # 解空间范围
x = np.random.uniform(x_bound[0], x_bound[1],(population_size, dim))  # 初始化粒子群位置
v = np.random.rand(population_size, dim)  # 初始化粒子群速度
p=x#初始个体最佳位置
fitness = calculate_fitness(x)
pg = x[np.argmin(fitness)]  # 初始全局最佳位置
individual_best_fitness = fitness  # 个体的最优适应度
global_best_fitness = np.min(fitness)  # 全局最佳适应度
lx=[]#后面做图用
ly=[]#后面做图用
for step in range(0,N):
    r1 = np.random.rand()
    r2 = np.random.rand()
    # 更新速度和权重
    v= w*v+c1*r1*(p-x)+c2*r2*(pg-x)
    x= v + x
    # 位置限制
    for i in range(len(x)):
        for j in range(dim):
            if x[i][j]< x_bound[0]:
                x[i][j]=x_bound[0]
            elif x[i][j] > x_bound[1]:
                x[i][j] = x_bound[1]
    fitness = calculate_fitness(x)
    # 需要更新的个体
    update_id = np.greater(individual_best_fitness, fitness)
    p[update_id] = x[update_id]
    individual_best_fitness[update_id] = fitness[update_id]
    # 新一代出现了更小的fitness,所以更新全局最优fitness和位置
    if np.min(fitness) < global_best_fitness:
        pg = x[np.argmin(fitness)]
        global_best_fitness = np.min(fitness)
    lx.append(step)
    ly.append(global_best_fitness)
    print('best fitness: %.5f, mean fitness: %.5f' % (global_best_fitness, np.mean(fitness)))
plt.figure(figsize=(15,4))
plt.plot(lx, ly,color='red')
min(ly)
输出结果:
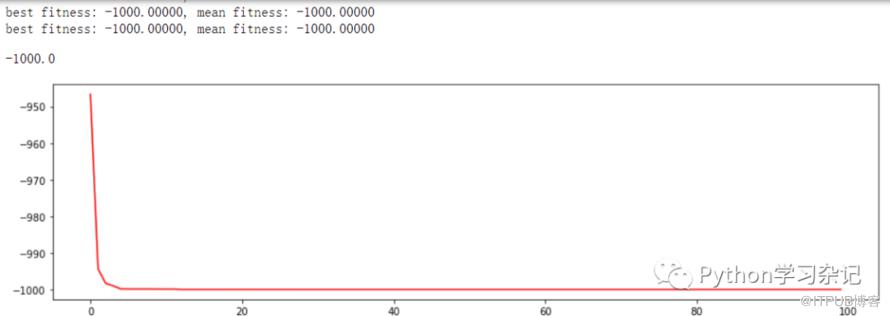 粒子数量、迭代次数,还有其他参数可以自行调整。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
分享一些Python的学习资料
下一篇:
遗传算法解决经典运输问题

请登录后发表评论
登录
全部评论
