工作中,我们经常需要直接获取图片中的文字,我在网上找了一些方法。1.pytesseract
1)通过cmd输入pip install pytesseract进行安装.
2)安装Tesseract-OCR。
下载地址:https://digi.bib.uni-mannheim.de/tesseract/
我的自定义安装路径是 C:\Tesseract-OCR\tesseract.exe
3)编辑pytesseract.py文件
把刚才安装的路径填写好。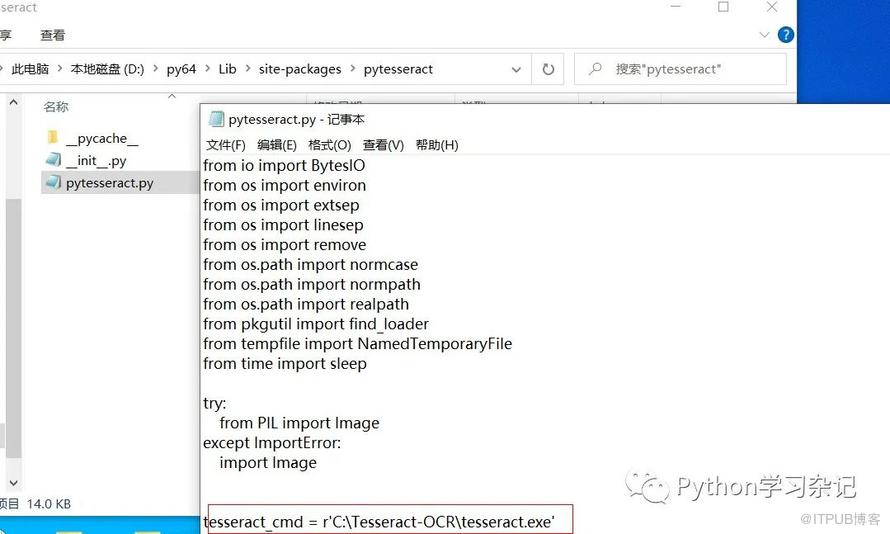 4)新建环境变量
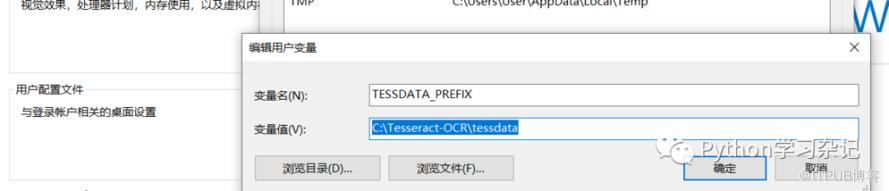 路径还是刚刚安装的Tesseract-OCR路径,但是要将它定位到其中的tessdata,变量名也一定不能改。保存后,请一定要重启,然后在去运行程序就可以使用pytesseract库了。
5)下载中文包。
去github下载中文包,放在Tesseract-OCR/tessdata文件中。
中文包下载地址链接 https://github.com/tesseract-ocr/tessdata
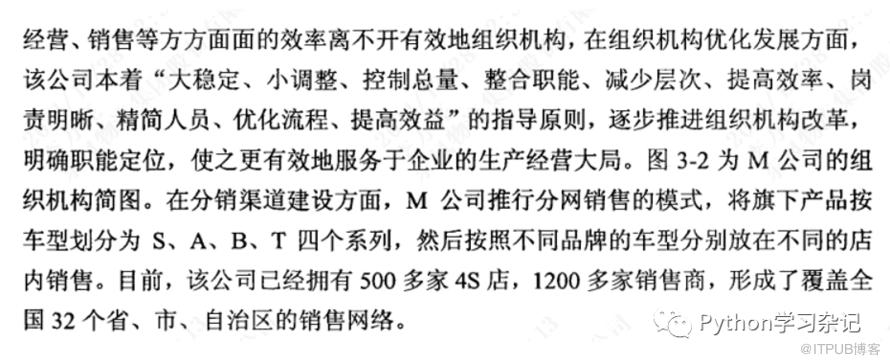
 现在pytesseract已经安装完成了,试用一下其效果。这是测试图片。中文文字较多。
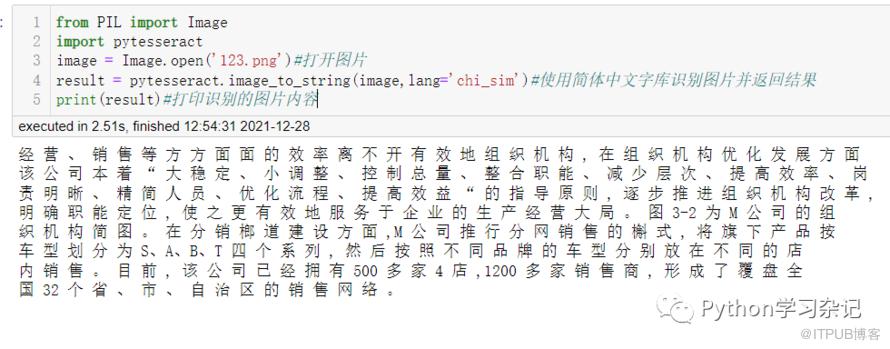
from PIL import Image
import pytesseract
image = Image.open('123.png')#打开图片
result = pytesseract.image_to_string(image,lang='chi_sim')#使用简体中文字库识别图片并返回结果
print(result)#打印识别的图片内容
输出结果如下:
2.EasyOCR
同样测试刚才的图片。
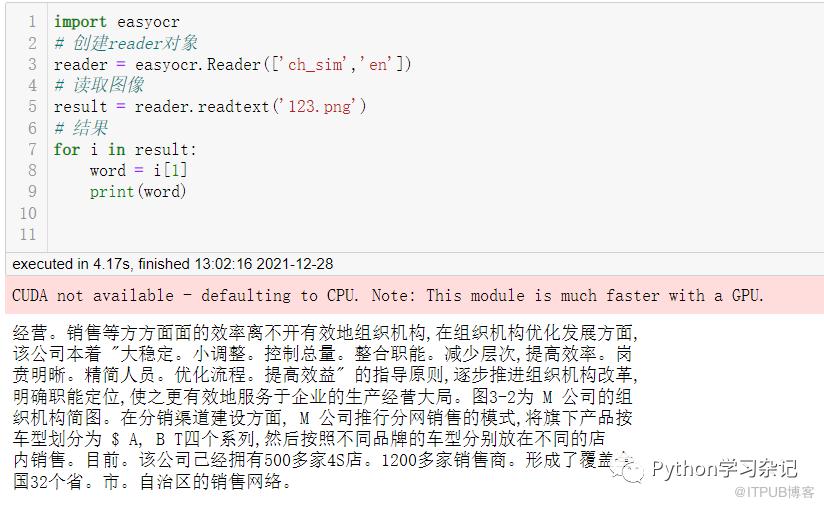
其效果比pytesseract好很多,读取的文字识别率超过90%,且文档完整。
总结:
1)在中文识别方面,EasyOCR比pytesseract效果好,
2)python安装、调用EasyOCR也比pytesseract方便。
但是网上pytesseract介绍的文章较多,EasyOCR介绍相对较少,在中文识别应用方面EasyOCR比较适用。另外百度人工智能系列也提供了图片文字识别的api,也可以尝试一下。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。

