1pandas_profiling简介
pandas_profiling是一个基于pandas库的开源数据分析工具,能快速对DataFrame中的数据进行统计分析,并生成数据报告。它可以极大简化数据分析流程,自动计算各个特征之间的相关性、缺失值分布、数据类型等。pandas_profiling的主要功能包括:
计算各数字类型特征的基本统计量,如平均值、中位数、方差等 绘制各分类类型特征的频数分布直方图 检测并标注出缺失值 利用相关系数矩阵检测变量间的相关性 自动对异常值进行标注 生成各种图表,直观显示各特征的统计分布 pandas_profiling可以快速概览原始数据的情况,对进行数据分析和特征工程非常有帮助。
2安装pandas_profiling
pandas_profiling可以通过pip直接安装:
pip install pandas-profiling
安装完成后,就可以导入并使用这个模块了:
import pandas as pd
import pandas_profiling
3pandas_profiling使用
pandas_profiling的使用非常简单,只需要对pandas的DataFrame运行profile_report方法,就可以生成分析报告。例如有这样一个DataFrame:
data = pd.DataFrame({
    'name':['张三', '李四', '王五','赵六', '陈七', '吴八'],
    'age':[22, 23, 24,32, 33, 36],
    'gender':['男','女', '男','男','女','男'],
    'salary': [5200, 1500,19000,30000, 33000, 31000],
})
直接使用:
pandas_profiling.ProfileReport(data)
就可以生成一份数据分析报告,报告页面如下图所示:
从报告可以清晰地看到数据中的各特征分布,包括:
Overview概览:显示各特征的数据类型、缺失值比例、唯一值数等 Variables变量:显示各数字特征的统计量分布,及分类特征的频数分布 Correlations相关性:显示各特征间的相关性矩阵 Missing values缺失值:显示缺失值的数量及比例 Warnings警告:会标注出一些异常值或可能存在问题的值 这样的报告可以非常快速直观地了解一个陌生数据集的整体情况。
为报告设置标题
可以通过title参数为报告设置自定义的标题:
profile = pandas_profiling.ProfileReport(data, title="用户数据报告")
保存报告到文件
默认情况下,ProfileReport会直接在Jupyter Notebook里展示报告。如果要保存报告html文件,可以使用to_file方法:
profile.to_file(output_file="report.html")
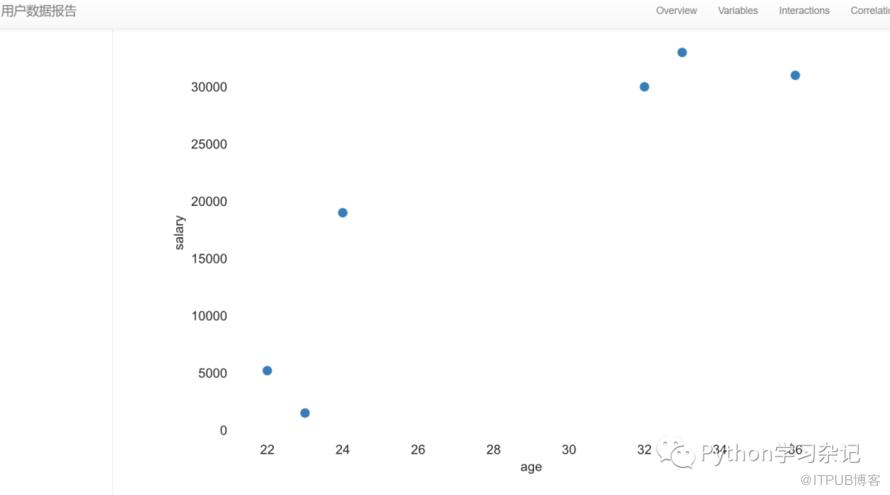
这样就会将报告保存到report.html文件中。
自定义报告内容
可以通过设置minimal参数来自定义报告的内容:
profile = pandas_profiling.ProfileReport(
    data,
    minimal=True
)
设置为True后,报告会只包含概览和变量分析,不包括相关性分析、缺失值等部分。也可以单独控制要展示的内容。
以上只是一个很简单的案例,对于复杂数据也可以使用以上方法,快速探索数据之间的关系。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
使用tkinter创建登录界面

请登录后发表评论
登录
全部评论
