信用算力:0-3000万用户微服务之旅
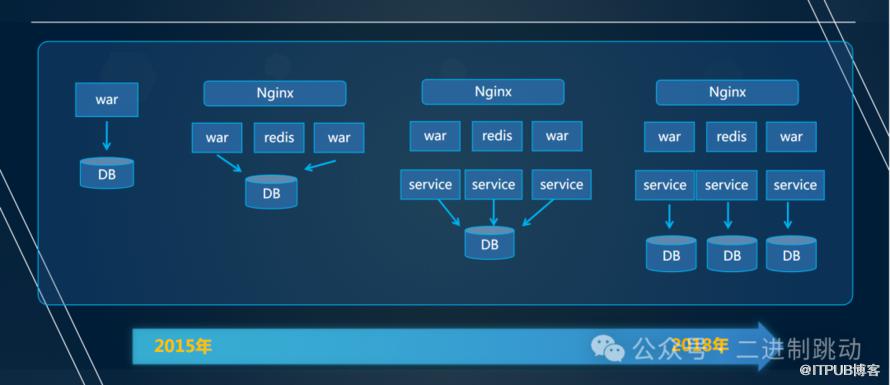
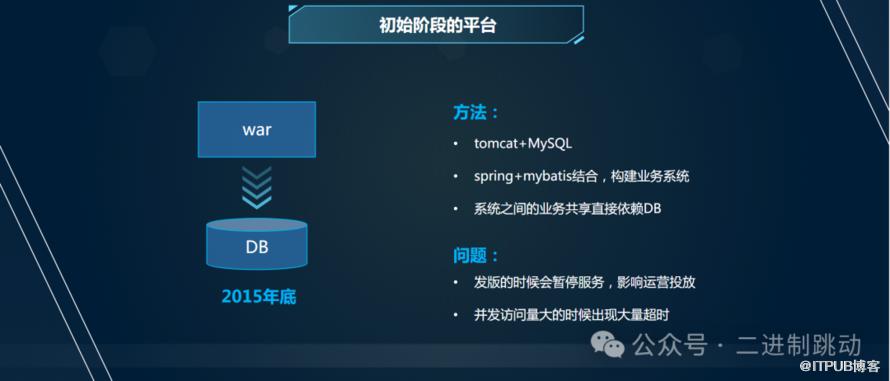
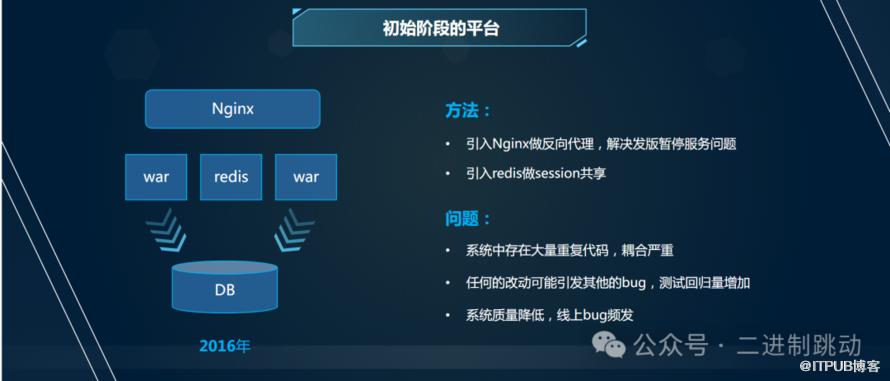
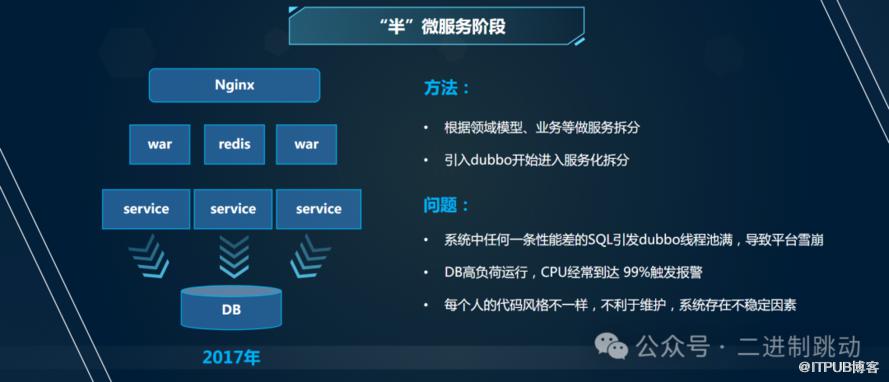
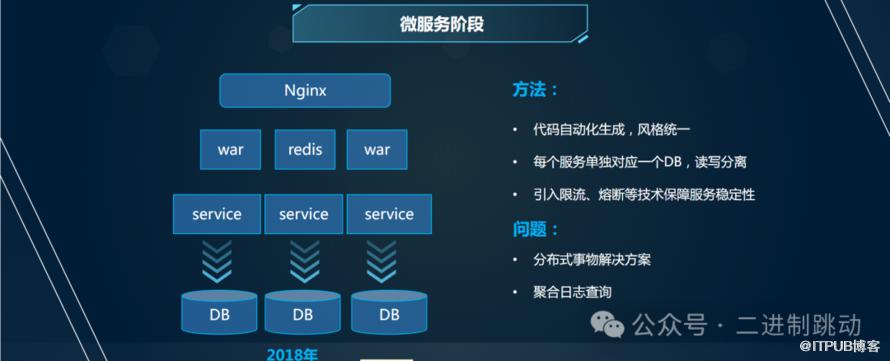
初始阶段的平台从简单触发,技术栈立足于tomcat+MySQL、Spring+batis结合,构建业务系统,系统直接是直接共享DB。

系统访问流程:
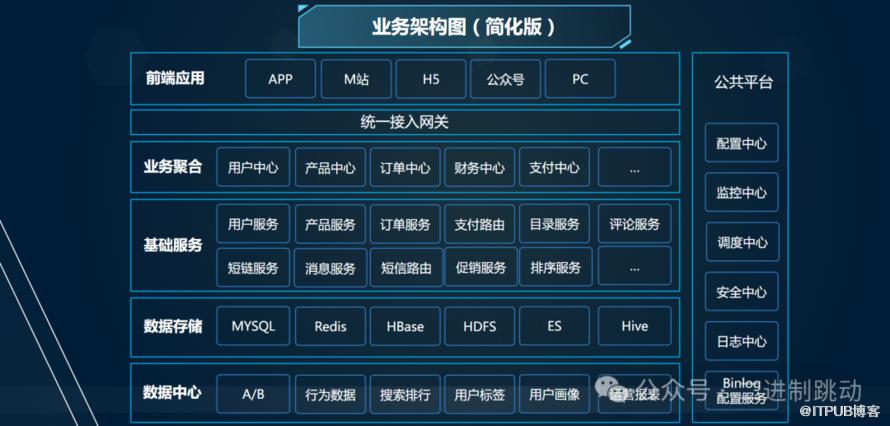
用户通过 App 或 H5 发起请求,这些请求首先经过 Nginx 进行负载均衡和转发。
Nginx 将请求转发到网关集群中的某个 API 网关。
网关进行路由、鉴权等操作后,将请求转发到对应的业务集群中的业务聚合层。
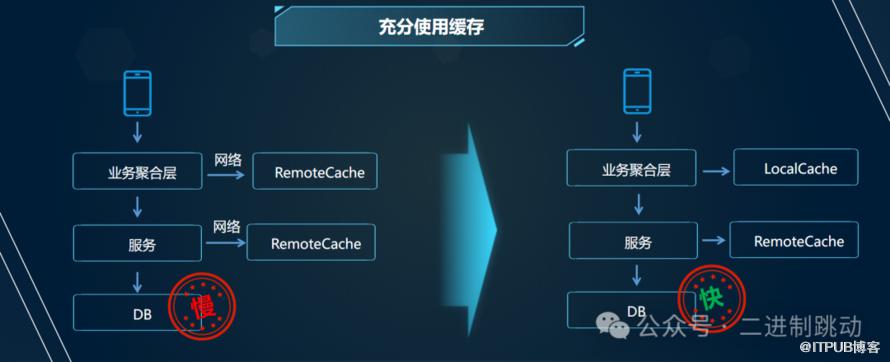
业务聚合层处理请求,首先查询本地缓存(LocalCache)。如果缓存中有数据,直接返回;如果没有,转发请求到服务集群。
服务集群中的具体服务实例处理业务逻辑,如果需要缓存数据,则查询或更新远程缓存集群(RemoteCache)。
如果需要持久化数据,服务层通过数据访问层(DAL)与数据库进行交互。主数据库处理写操作,从数据库处理读操作。
配置中心为各个服务提供配置管理和动态更新支持,确保系统配置的一致性和最新状态。

缓存技巧:
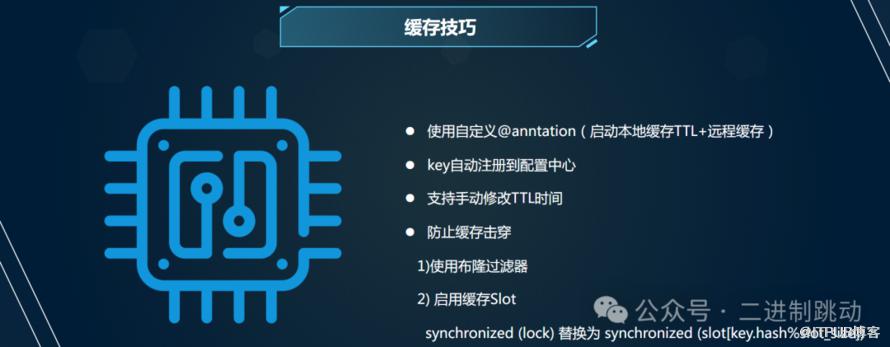
使用自定义 @annotation (启动本地缓存TTL+远程缓存)
自定义注解:通过自定义注解来控制缓存策略,例如本地缓存的TTL(Time To Live)和远程缓存。注解可以方便地在代码中标记哪些方法或类需要使用缓存,从而自动处理缓存逻辑。
key 自动注册到配置中心
自动注册:缓存键值自动注册到配置中心,确保缓存的配置统一管理。这样可以方便地对缓存进行动态配置和管理,提升系统的灵活性和可维护性。
支持手动修改TTL时间
手动修改TTL:允许手动调整缓存的TTL时间,可以根据实际需求动态调整缓存的生存时间,提高缓存的使用效率和数据的实时性。
防止缓存击穿
使用布隆过滤器:布隆过滤器是一种空间效率高的数据结构,用于快速判断一个元素是否在集合中。它可以有效防止缓存穿透,将不存在的数据请求过滤掉,减少对数据库的直接访问。
启用缓存Slot:缓存分片(Slot)技术,通过将缓存键分配到不同的槽中,减少锁竞争,提高并发处理能力。
锁优化
synchronized(lock) 替换为 synchronized(slot[key.hash%slot_size]):通过哈希槽(Slot)进行分段锁定,避免全局锁带来的性能瓶颈。将锁的粒度降低到哈希槽级别,提升并发性能。
微服务进阶阶段


日志检索
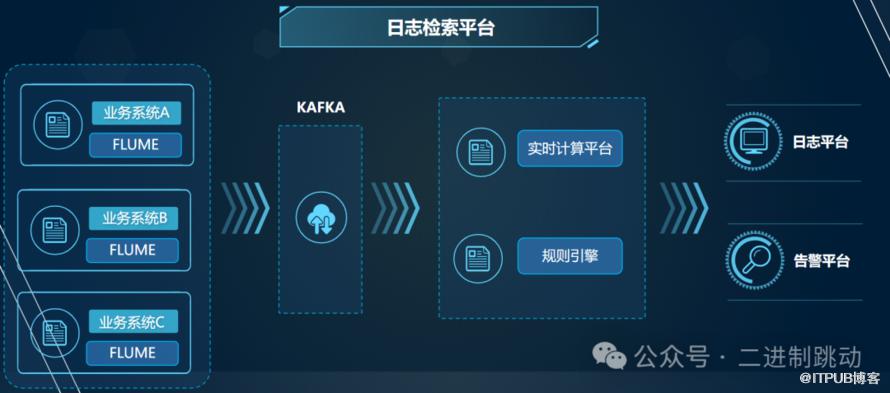
1. 数据收集层
业务系统 A、B、C:这些是系统的多个业务模块,它们生成和处理不同类型的业务数据。
Flume:这是一个分布式、可靠且高效的数据收集系统。Flume 被用来从业务系统中收集数据,并将数据传输到数据处理平台。在图中,每个业务系统都通过 Flume 将数据发送到 Kafka。
2. 数据中转层
Kafka:这是一个高吞吐量的分布式消息队列系统,用于实时数据流处理。Kafka 在该流程中充当数据的中转站,接收来自 Flume 的数据,并将其分发到下游的处理平台。Kafka 提供了可靠的数据传输和存储机制,确保数据不会在传输过程中丢失。
3. 数据处理层
实时计算平台:这一部分负责对从 Kafka 接收到的数据进行实时处理和计算。实时计算平台可能使用如 Apache Flink、Apache Storm 或 Spark Streaming 等技术,来执行复杂的数据分析和处理任务,从而提供即时的业务洞察和决策支持。
规则引擎:这是一个用于执行预定义规则和逻辑的系统,能够根据实时数据触发相应的操作。规则引擎可以用于监控业务流程、检测异常行为或自动化执行特定任务。
4. 数据输出层
日志平台:处理过的数据和日志信息被存储和展示在日志平台上。该平台可以提供丰富的日志查询和分析功能,帮助运维人员和开发者监控系统状态和排查问题。
告警平台:根据规则引擎的输出,告警平台负责生成告警通知,提示相关人员注意和处理潜在问题。告警平台可能支持多种通知方式,如短信、邮件或即时消息等。


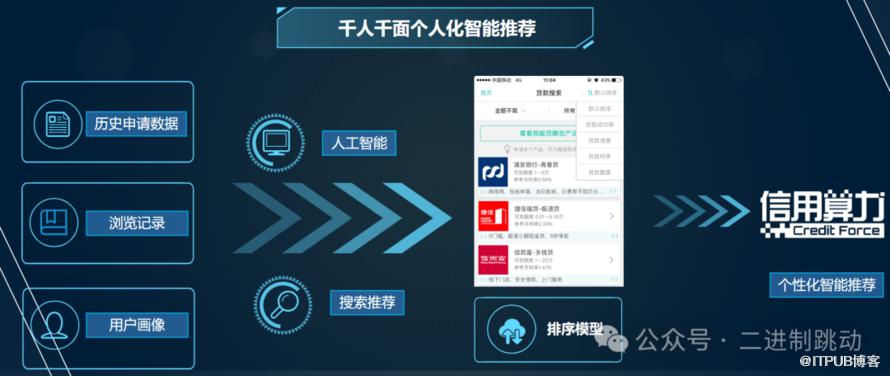
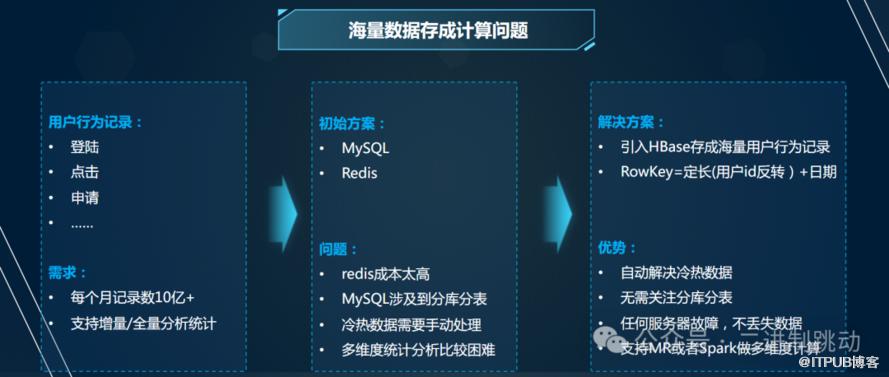
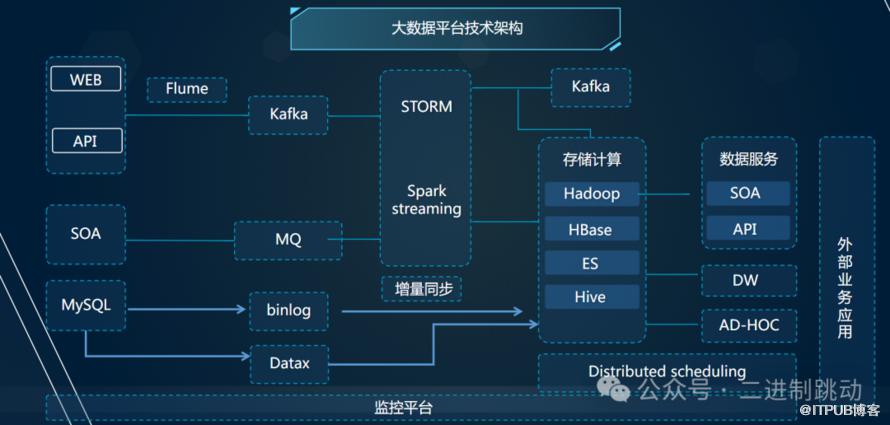
微服务与大数据结合
原文作者:二进制跳动;如有侵权,请联系管理员删除。

