如何做好微服务容量规划?
将单体应用拆分为微服务后所带来的开发、测试和运维复杂度的提升问题,我们可以通过 DevOps 实现 CI/CD 流程的自动化来应对这些挑战。除此之外,单体应用拆分为微服务后还会带来另一个问题,那就是如何规划拆分出来的多个微服务的容量。在单体应用的情况下,只需要根据单体应用的访问量和实际接口性能来决定是否进行扩容。而在拆分为众多微服务之后,需要为每个服务规划容量,这其中的复杂度主要体现在以下几个方面:
服务数量众多,难以靠人工运维管理:例如,微博的 Feed 业务仅仅在 RPC 服务方面就有将近 40 个。
服务的接口表现差异巨大:有的接口属于访问量较大但响应时间较短的轻接口;有的接口属于访问量较小但响应时间较长的重接口。比如,微博 Feed 业务中计数接口的平均耗时只有 2~3 毫秒,而 Feed 接口的平均耗时则超过 200 毫秒。
服务部署的集群规模大小不同:需要扩容的机器数量差异很大。比如,微博的 AB 测试服务集群只有大约 20 台机器,扩容时只需要几台机器即可满足需求;而 Feed 服务则有上千台机器,往往扩容时需要增加上百台机器。
-
服务之间存在依赖关系:在服务扩容时,还需要考虑依赖服务的容量是否足够。比如,微博 Feed 业务的扩容依赖用户关系服务和 Card 服务,扩容时需要考虑这些依赖服务的容量是否充足。
由此可见,将单体应用拆分为微服务后,微服务的容量规划难度显著增加,继续依赖传统的人工运维模式显然已经行不通了。延续上期关于 DevOps 的话题,实际上,微服务的容量规划也是广义 DevOps 需要解决的问题之一。那么,DevOps 是如何解决这一问题的呢?答案是通过容量规划系统。接下来,我将讨论容量规划系统应该如何实现。
容量规划系统的作用是根据各个微服务部署集群的最大容量和线上实际运行的负荷,决定各个微服务是否需要弹性扩缩容,以及需要扩缩容多少台机器。
容量规划系统的关键在于两个方面:一是如何评估集群的最大容量和线上实际运行的负荷,也就是如何进行容量评估;二是如何确定弹性扩缩容的时机以及需要扩缩容的机器数量,也就是如何做好调度决策。接下来,我们将分别讨论这两个关键点,并逐一击破。
容量评估
一般来说,集群的容量评估是通过线上实际压测来确定的。那么,如何进行线上压测呢?需要注意哪些关键点?
-
选择合适的压测指标
选取压测指标时,主要有两类:一类是系统类指标,比如机器的 CPU 使用率、内存占用量、磁盘 I/O 使用率以及网卡带宽等;另一类是服务类指标,比如接口响应的平均耗时、P999 耗时、错误率。然而,这些指标在实际压测时会存在一些问题。系统类指标(如 CPU 使用率)并不能直接反映服务压测时的健康状况。有时,CPU 使用率不高但接口耗时可能出现问题;反之,CPU 使用率较高时,接口耗时表现依然正常。服务类指标(如接口响应的平均耗时)也不能精确反映服务的实际健康状态。例如,压测时如果出现一定比例的慢请求,但平均耗时没有显著变化,这时服务实际上已经不健康了,需要停止压测。
根据我的经验,在压测时,除了观察以上这些指标外,还可以观察接口的慢速比,即接口响应时间高于某个阈值的比例。比如微博在进行 Feed 接口压测时,选择的压测指标是 Feed 接口响应时间大于 1 秒的比例,压测的终止条件是该比例超过 1%。我的主要考虑是,当 99% 以上的接口请求在 1 秒内返回时,用户感知不到 Feed 刷新慢,否则就会感知到慢。对于大部分在线服务来说,接口慢速比不超过 1% 是服务质量保证的底线,因此可以作为一个通用的压测指标。
-
压测获取单机的最大容量
集群的最大容量就是单机最大容量乘以集群内的机器数量。所以,要获得集群的最大容量,就必须先获得单机的最大容量。通常有两种方式来获取单机的最大容量:一种是单机压测,另一种是集群压测。
从我的经验来看,集群压测更合理,因为它完全使用线上真实流量进行压测,获取的单机最大容量更精确。单机压测为了避免产生“脏数据”,通常需要去掉一些上行的修改请求,所以不能完全模拟线上真实情况。不过,集群压测的方式也有一个缺点,就是压测时会对线上用户的实际请求产生影响,如果压测出问题,会直接影响线上服务。所以,一般会选择在业务低峰期进行压测,最大限度减少对线上服务的影响。通常还会选择在工作日进行压测,以便在出现问题时能够快速介入。
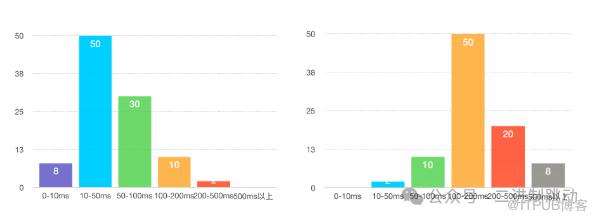
假设我们采用集群压测,不断缩减线上节点数量,并观察服务的慢速比指标,当慢速比达到 1% 时停止压测,这时可以计算单机的最大容量。通常做法是用压测停止时刻的单机平均 QPS 作为单机的最大容量。但实际上,QPS 并不能准确衡量单机的消耗。举个例子,假设有两种请求分布,左图的请求响应时间主要集中在 100ms 以下,没有超过 500ms;右图的请求响应时间主要集中在 50ms 以上,没有低于 10ms。这两种请求分布对单机的消耗差异很大,显然右边的消耗更大。在单机 QPS 都是 100 的情况下,左边的单机还能继续增加 QPS,而右边的单机已经出现超过 500ms 以上的慢请求了。
因此,更合理的计算单机容量的方式是采用区间加权来计算。也就是把请求按照响应时间分成多个区间,每个区间赋予不同的权重,响应时间越长权重越高。比如 0~10ms 区间的权重是 1,10~50ms 区间的权重是 2,50~100ms 区间的权重是 4,100~200ms 区间的权重是 8,200~500ms 区间的权重是 16,500ms 以上的权重是 32。根据这种方式计算,上面两种请求分布的单机容量分别是 8×1+50×2+30×4+10×8+2×16=340 和 2×2+10×4+50×8+20×16+8×32=1020。因此,单机的最大容量应该在压测停止时采用区间加权方式计算得出。
单机压测:单机压测一般有两种方式,一是通过日志回放等手段模拟线上流量对单机进行压测;二是通过 TCP-Copy 的方式,把线上机器的流量拷贝到单机进行压测。
-
集群压测:集群压测是对整个集群进行压测,以获取单机的最大容量。通常做法是通过不断摘除线上集群的节点,以减少机器数来增加线上节点单机的流量,从而达到压测目的。
3. 实时获取集群的运行负荷
通过压测能够获取单机的最大容量,再乘以集群内的机器数量就可以得到集群的最大容量。接下来,通过获取集群实际运行的负荷,就能判断集群是否需要扩容。类似于计算单机容量的方式,集群的运行负荷也需要通过采用区间加权的方式来计算。然而,由于集群的规模可能很大,甚至超过上千台机器,显然通过计算每台单机运行的负荷再加在一起的方式效率不高。
在实际操作中,我采用了一种更高效的方法:统计每台单机在不同耗时区间内的请求数,并将这些数据推送到一个集中处理的地方进行聚合。通过将同一个集群内各单机在不同耗时区间内的请求进行汇总,就可以得到整个集群的请求在不同耗时区间内的分布。然后,利用区间加权的方式计算出整个集群的运行负荷。
这种方法不仅能有效地处理大规模集群的数据,还能准确地反映集群的实际运行状态,从而帮助我们判断是否需要进行扩容。
调度决策
在容量评估阶段,我们可以获取集群的最大容量和集群的实际运行负荷。有了这两个数据后,我们可以制定调度策略。我在实际线上业务中使用的是“水位线”来进行调度决策。就像水库的水位线一样,我们需要实时监测水库的蓄水量。如果因长时间降水导致水库蓄水量超过警戒水位线,就需要开闸泄洪;如果因长时间干旱导致降水量太少,就需要关闸蓄水,以保持水库中的蓄水量始终在一个合理的水位线上。
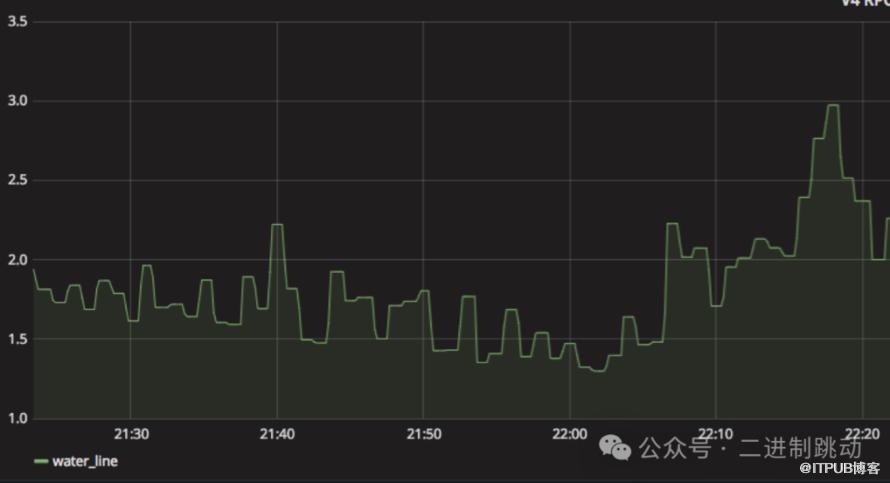
类似地,在我们的系统中,任意时刻的水位线就是集群的最大容量除以集群的实际运行负荷,通过实时监控集群的水位线来做调度决策。
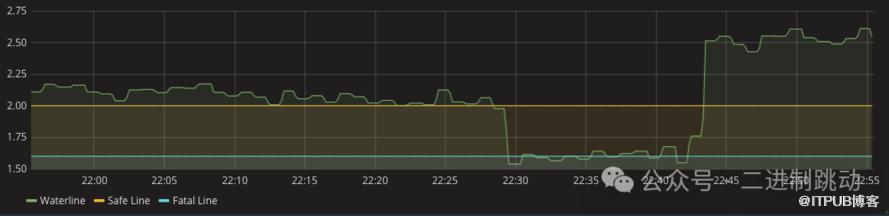
在执行扩缩容时,如何决定需要增加或减少的机器数量是一个关键问题。下面具体说明扩容和缩容的策略。
扩容策略
在决定扩容时,可以采取两种方式:按数量和按比例。由于不同集群内机器数量差异较大,通常采用按比例的方式更为合理。具体做法如下:
按比例扩容:
每次扩容增加机器数量的比例,例如增加 30% 的机器数量。
扩容后再检查水位线是否处于致命线以上。
缩容策略
扩容完成后,当集群的水位线保持在安全线以上一段时间后,就需要缩容以节省成本。缩容策略如下:
保持时间:
根据实际业务特点决定保持时间。例如,微博的突发流量通常维持在 1 小时以内,因此集群水位线在安全线以上超过 1 小时后就可以开始缩容。
逐步缩容:
缩容时采用逐步缩容的方式,而不是一次性缩掉所有扩容的机器。
每隔 5 分钟判断一次集群的水位线是否还在致命线以上,然后按照 10%、30%、50%、100% 的比例逐步缩容。这样可以避免缩容过快导致水位线再次降到致命线以下而需要再次扩容。
防止瞬间抖动
在根据水位线决定是否扩缩容时,还需要防止因网络抖动等原因造成的水位线瞬间波动。瞬间波动可能导致集群运行负荷突然变大,触发不必要的扩容。为此,可以采取以下措施:
采集多个数据点:
每分钟采集一次系统的水位线,一共采集 5 个数据点。
只有当 5 个数据点中有 3 个满足扩容条件时,才真正触发扩容。
示例策略
扩容:
集群当前机器数:100
计划扩容比例:30%
扩容后的机器数:130
检查水位线是否高于致命线
缩容:
集群当前机器数:130
缩容开始条件:水位线在安全线以上超过 1 小时
缩容策略:每5分钟判断一次水位线,逐步缩容(10%、30%、50%、100%)
防止瞬间抖动:
每分钟采集一次水位线,一共采集 5 个点。
只有当 5 个点中有 3 个满足扩容条件时,才触发扩容。
通过这些策略,可以更合理地进行扩缩容,确保集群在高效运行的同时避免不必要的资源浪费和系统过载。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

