1背景
昨天,一朋友向我咨询Sybase ASE中定长字符串类型的行为,说他们的客户反映,同样的char类型的数据,通过jdbc来查,Sybase库不会带空格,而PostgreSQL会带。是不是这样的?他是PostgreSQL的专业大拿,但因为他手头没有现成的Sybase ASE环境,刚好我手上有,便于一试。
2 分析
通常遇到这种情况,我会想,一定有什么地方使用起来有些特殊。不然不太可能会出现截然不同的结果。在我多年的映象中,ASE中的char(N)就是一种定长类型。没有什么特殊处理。
PostgreSQL里头的定长字符串比较行为相当正常, 完全符合预期:
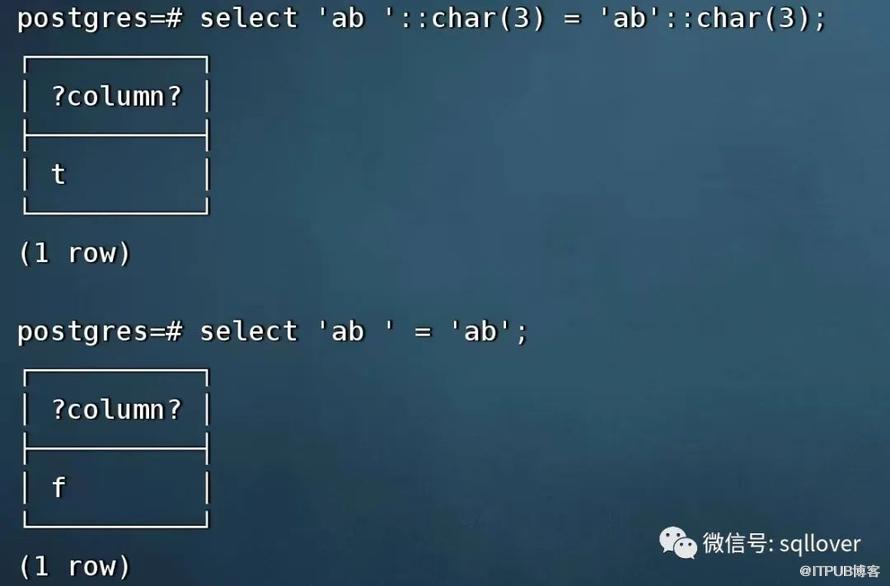
如果用另一个拼接式的SQL,看一下:
postgres=# select '[' || 'Beijing  '::char(12) || ']';
 ?column?
-----------
 [Beijing]
(1 row)
看起来,它是把末尾的所谓的空格给消掉了。
看来边的示例:

create table t(id char(12));
insert into t values(' Beijing ');
这里就是一张简单的表,(注:没有NULL 声明,默认为NULL, 因为数据库选项将此开关"allow nulls by default"置为ON, 此开关如果不开,则默认为NOT NULL,很我初学初用的人易犯错)。插入首尾都带空格的字符串' Beijng ', 我们select一下,看看结果。为了简化问题,也不想写什么code,直接用 DBEaver直连,不带任何附加参数,发现select出来的值,空格都没有被trim.
select * from t;
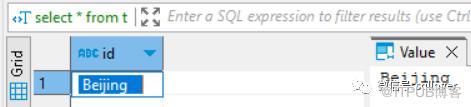
这里还特意做一个二进制的转换,再次确认:
select convert(binary, id) from t;
select convert(binary, 'Beijing') from t;
将结果,以及去掉首尾字母的'Beijing'的binary值出来,对比分别是下边这样子的:
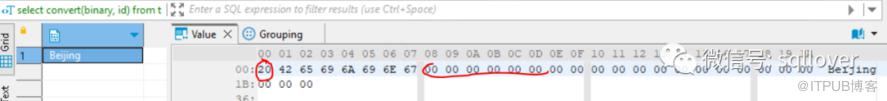
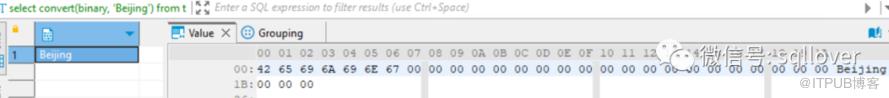
从这一看,前边的20空格字符确实还在。后边一大堆的0x00是什么原因?于是又补了一个查询:
select convert(binary(12), 'Beijing ') from t;其结果是末尾都是'0x20'空格。而且它与下这的两句结果是相同的:
select convert(binary(12), convert(char(9), 'Beijing  ')) from t;
select convert(binary(12), convert(varchar(9), 'Beijing  ')) from t;

看起来,直接SELECT出来的结果并没有截断。而经过binary转换以后,末尾也都变成00了。但是验证是否符合预期也直观:
直接使用:
select * from t where id = ' Beijing'
最终还是能查出符合预期的结果: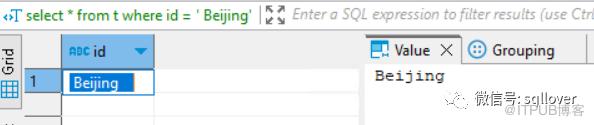
但是我还是不放心。两端用'[', 括一下试试:
select '[' + id + ']' as id, '[' + convert(char(12) null, ' Beijing ') + ']' as v from t;
select '[' + id + ']' as id from t;
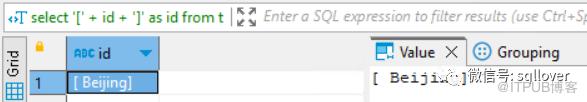
妥妥的被截掉了。那就是说,在与其它字符一起拼接的时候,它是真的被截掉了。
3 进一步比对
重新查了一下文档,发现ASE有一些关于strip的连接属性:
https://infocenter.sybase.com/help/index.jsp?topic=/com.sybase.infocenter.dc39001.1600/doc/html/har1355981355759.html (Sybase ASE 16.0 JConnect相关连接属性)里有一段:
STRIP_BLANKS:
Forces the server to remove the preceding and trailing blanks in a string value before storing it in the table.
Valid values are:
false – string values sent by the client are stored as is.
true – preceding and trailing blanks in a string value are removed before storing it in the table.
Default value is false.
This property is static.
就是在连接串末尾加上:&STRIP_BLANKS=true, 结果发现和上边的一样,没什么不同(这就有点儿不太正常了)
4 换一种方式对比
create table spaces (cnot char(5) not null,
    cnull char(5) null,
    vnot varchar(5) not null,
    vnull varchar(5) null,
    explanation varchar(25) not null) ;
把几种情形都考虑进去,看看有什么不同?
insert spaces values ('a', 'b', 'c', 'd', 'pads char-not-null only') ;
insert spaces values ('1    ', '2    ', '3    ', '4    ', 'truncates trailing blanks');
insert spaces values ('    e', '    f', '    g', '    h', 'leading blanks, no change');
insert spaces values ('   w ', '   x ', '   y ', '    z ', 'truncates trailing blanks');
insert spaces values ('', '', '', '', 'empty string equals space') ;

select '[' + cnot + ']',
       '[' + cnull + ']',
       '[' + vnot + ']',
       '[' + vnull + ']',
    explanation from spaces
结果如下:

解释起来就是:
如果是Nullable的char(N),则会把末尾的空格截掉(当然,这是与其它字符拼接时的行为)
如果是Not Null的char(N),则不会截掉空格,无论是否与其它字符拼接。
如果是varchar(N),则无论是否是Nullable,都会被截掉空格(无论是否拼接)
5. 直接用jdbc的代码进行验证以及结果
表及数据准备:
create table t2(col1 char(12) null, col2 char(12) not null, col3 varchar(12) null, col4 varchar(12) not null);
insert into t2 values('Beijing ', 'Beijing ', 'Nanjing ', 'Nanjing ');
5.1 ASE的查询:
select col1, col2, '[' + col1 + ']' as newcol1, '[' + col2 + ']' as newcol2,
       col3, col4, '[' + col3 + ']' as newcol3, '[' + col4 + ']' as newcol4
from t2;
直接查询的java代码:
        try (Connection conn = DriverManager.getConnection("jdbc:sybase:Tds:host:5000?ServiceName=sean", "username",
                "password")) {
            try (Statement stmt = conn.createStatement();
                    ResultSet rset = stmt.executeQuery(
                            "select col1, col2, '[' + col1 + ']' as newcol1, '[' + col2 + ']' as newcol2, col3, col4, '[' + col3 + ']' as\n"
                                    + " newcol3, '[' + col4 + ']' as newcol4 from t2")) {
                if (rset.next()) {
                    System.out.println("col1: (" + rset.getString(1) + ")");
                    System.out.println("col2: (" + rset.getString(2) + ")");
                    System.out.println("ncol1: (" + rset.getString(3) + ")");
                    System.out.println("ncol2: (" + rset.getString(4) + ")");
                    System.out.println("col3: (" + rset.getString(5) + ")");
                    System.out.println("col4: (" + rset.getString(6) + ")");
                    System.out.println("ncol3: (" + rset.getString(7) + ")");
                    System.out.println("ncol4: (" + rset.getString(8) + ")");
                }
            }
        }
有趣的结果如下:
col1: (Beijing     )
col2: (Beijing     )
ncol1: ([Beijing])
ncol2: ([Beijing     ])
col3: (Nanjing)
col4: (Nanjing)
ncol3: ([Nanjing])
ncol4: ([Nanjing])
char(12) not null永远不截断。char(12) null, 拼接后取值,会截断。取值
以后再拼接,则保留空格(见第1行结果和第3行结果)
5.2 PostgreSQL的查询:select col1, col2, '[' + col1 + ']' as newcol1, '[' + col2 + ']' as newcol2,
col3, col4, '[' + col3 + ']' as newcol3, '[' + col4 + ']' as newcol4
from t2;
它对应的java代码:
        try (Connection conn = DriverManager.getConnection("jdbc:postgresql://127.0.0.1:5555/mydb", "username",
                "password")) {
            try (Statement stmt = conn.createStatement();
                    ResultSet rset = stmt.executeQuery(
                            "select col1, col2, '[' || col1 || ']' as newcol1, '[' || col2 || ']' as newcol2,\n"
                                    + "       col3, col4, '[' || col3 || ']' as newcol3, '[' || col4 || ']' as newcol4 \n"
                                    + "from t2")) {
                if (rset.next()) {
                    System.out.println("col1: (" + rset.getString(1) + ")");
                    System.out.println("col2: (" + rset.getString(2) + ")");
                    System.out.println("ncol1: (" + rset.getString(3) + ")");
                    System.out.println("ncol2: (" + rset.getString(4) + ")");
                    System.out.println("col3: (" + rset.getString(5) + ")");
                    System.out.println("col4: (" + rset.getString(6) + ")");
                    System.out.println("ncol3: (" + rset.getString(7) + ")");
                    System.out.println("ncol4: (" + rset.getString(8) + ")");
                }
            }
        }
结果如下:
col1: (Beijing     )
col2: (Beijing     )
ncol1: ([Beijing])
ncol2: ([Beijing])
col3: (Nanjing )
col4: (Nanjing )
ncol3: ([Nanjing ])
ncol4: ([Nanjing ])
可以看到,char(N) NULL与NOT NULL,行为一致。都是直接取值时有空格,加了拼接时,空格截掉。
而varchar(N) NULL与NOT NULL,行为也一致,无论是直接取值,还是拼接后再取值,都留一个多余的字符(长度够宽的话)。如果你再往下深挖,可以把对应的byte打出来,它的10进制值是32,也就是空格字符。这个,我还真是好奇,PG jdbc是为何要多保留一个空格字符出来? 平时我还真没有注意到啊。呵呵。用下边的小片段做个留念:
postgres=# select '[' || 'Beijing '::char(12) || ']';
 ?column?
-----------
 [Beijing]
(1 row)

postgres=# select '[' || 'Beijing '::varchar(12) || ']';
  ?column?
------------
 [Beijing ]
(1 row)
6. 最终小结论:
在ASE中,如此看来,在char(12) null时,如果是SQL内拼接再取值,则会被截断。它如果是Not Null,则都不会被截断。这个跟PostgreSQL是不太一样的行为。PostgreSQL里,就算是Not Null, 拼接其它字符,再返回,也会被截掉。它的NULL与Not NULL的处理行为是一样的。
这样来看,只要不在SQL语句里头拼接,那么char(N) NULL或NOT NULL,两种数据库的行为应该是一样的。
[---END---]

原文作者:数据库杂记;如有侵权,请联系管理员删除。

最新文章
- PostgreSQL Internals之路 Part-II 第10章 WAL日志
- 从Oracle过渡到PostgreSQL: 理解模式的概念
- PostgreSQL是Oracle的一个可行的替代方案——原因如下
- PostgreSQL Internals之路Part II: Buffer Cache和WAL第9章 Buffer Cache
- 天纵奇才 - "林诗栋"
- 没有PostgreSQL样例数据库,不用担心, 帮你搞定!
- 推荐几本数据库技术图书
- 由浅入深高可用:HAProxy + PostgreSQL配置逐步详解(二)
- PostgreSQL Internals之路 Part-I 第7,8章 冻结、重建表和索引
- 乒坛最新消息引发巨震 - 世界第一王楚钦惨败林诗栋,王曼昱0-4遭横扫,还有孙颖莎4-2稳胜张本美和
