前言
昨天一大早,光头强直接把熊大喊过去,说他负责的云上某个region的Sybase ASE(后边简称Sybase)数据库出故障了。熊大问:啥故障?我们这Sybase数据库几年都没出过问题了,稳稳当当的。
光头强说:”系统的预警报的是:Sybase ASE Long Running Trans“
Details: Long running transaction '$chained_transaction': duration 3910 s,
process ID 7137,
login 'ppxxxxxxxxxxyz,
database 'CT_33333362efb8c8-e1f0-497a-b08c-5576bd9b2081'
就是有一个长事务,持续了一个来小时。妥妥的有问题了。
分析
熊大回想,这Sybase数据库在云环境下,按照固定模式维护,好几年也没出过什么问题,怎么突然来了这么个长事务呢?大多是因为被别的事务阻塞,导致时间很长都执行不过去。但是前几年跟应用开发人员反复磨合,基本上与死锁相关的问题全部都解决了。
因为上边已经提示了Process ID:7137. 运用监控的扩展存储脚本(过程),很容易定位是哪个SQL语句干的。
5> sp_sp 7137
6> go

select top 5 convert(varchar(38),o.name) AS table_name, row_count(db_id(), o.id) AS row_count, CONVERT(numeric(12, 4), (reserved_pages(db_id(), o.id, 0) + SUM ( reserved_pages(db_id(), i.id, i.indid) ) + reserved_pages(db_id(), o.id, 255))/1024 * (@@maxpagesize/1024)) AS MBS,(CASE when row_count(db_id(), o.id) = 0 then 0 else CONVERT(numeric(12, 4), (reserved_pages(db_id(), o.id, 0) + SUM ( reserved_pages(db_id(), i.id, i.indid) ) + reserved_pages(db_id(), o.id, 255))/1024 * (@@maxpagesize/1024))/(row_count(db_id(), o.id)) end) AS ROW_MBS, data_pages(db_id(), o.id, 0) AS data_pages, CONVERT(numeric(12, 4), data_pages(db_id(), o.id, 0)/1024 * (@@maxpagesize/1024)) AS data_mbs, (data_pages(db_id(), o.id, 255) + SUM ( data_pages(db_id(), i.id, i.indid) )) AS index_pages, CONVERT(numeric(12, 4), (data_pages(db_id(), o.id, 255) + SUM ( data_pages(db_id(), i.id, i.indid) )) /1024 * (@@maxpagesize/1024)) AS index_mbs from sysobjects o, sysindexes i, sysusers u where o.id = i.id and o.type='U' and i.indid > 0 and (i.status > 0) and o.uid=u.uid and u.name='pd1u8bon2e_migrate' group by o.uid, o.name order by MBS desc, table_name asc

(1 row affected)

Tables:

TABLE:          "sysusers"              rows: 65        use count: 1    datachange: 0

TABLE:          "sysobjects"            rows: 7213      use count: 2    datachange: 0

TABLE:          "sysindexes"            rows: 15808     use count: 1    datachange: 0
total number of tables used: 4
total number of worktables: 1

Final abstract plan text:
        ( sort ( nl_join ( group_sorted ( nl_join ( nl_join ( i_scan ncsysusers1 ( table ( u sysusers ) ) ) ( i_scan ncsysobjects ( table ( o [sysobjects@Gtt2] ) ) ) ) ( i_scan csysindexes ( table ( i sysindexes ) ) ) ) ) ( i_scan ncsysobjects ( table ( o [sysobj
         ects@Gtt0] ) ) ) ) ) ( prop ( table ( u sysusers ) ) ( parallel 1 ) ( prefetch 16 ) ( lru ) ) ( prop ( table ( o [sysobjects@Gtt2] ) ) ( parallel 1 ) ( prefetch 16 ) ( lru ) ) ( prop ( table ( i sysindexes ) ) ( parallel 1 ) ( prefetch 16 ) ( lru ) ) ( p
         rop ( table ( o [sysobjects@Gtt0] ) ) ( parallel 1 ) ( prefetch 16 ) ( lru ) )

............


Total estimated I/O cost for statement 1 (at line 1): 0.

Proccache used during compilation: 227 .
Total estimated LIO: 0.000000 .
Total estimated PIO: 0.000000 .
Total estimated CPU time: 0.000000 .
Query has started at: 2024/05/03 14:25:46.28 .
Query is running for: 8219000 ms.
(return status = 0)
这是一个统计用的SQL语句,杀了也无关紧要。于是熊大,直接找DBA把7137给杀掉了。可是,过了不到一两个小时,相同的现象又出现了。
并且这次出现了新的现象:
1> sp_sp 7307
2> go
  TRUNCATE TABLE NETWORK_ABC
  (1 row affected)QUERY PLAN FOR STATEMENT 1 (at line 1).
    STEP 1
        The type of query is TRUNCATE TABLE.Total estimated I/O cost for statement 1 (at line 1): 0.Proccache used during compilation: 0 .
Total estimated LIO: 0.000000 .
Total estimated PIO: 0.000000 .
Total estimated CPU time: 0.000000 .
Query has started at: 1900/01/01 00:00:00.00 .
Query is running for: 828347056 ms.
(return status = 0)
并且大量的别的操作被7307住了:
1> sp_w 7307
2> go
 fid    spid   command                            execution_time       physical_io blocked
 ------ ------ ---------------------------------- -------------------- ----------- -------
      0   6401 DELETE                                        192837463           0    7307
      0   2050 DELETE                                        246391744           0    7307
      0   5378 DELETE                                        250476678           0    7307
      0   2308 DELETE                                        179878656           0    7307
      0   4873 DELETE                                        259402093           0    7307
      0   1546 DELETE                                        215862390           0    7307
      0   4362 DELETE                                        241219845           0    7307
      0   7178 DELETE                                        200571587           0    7307
      0   2828 DELETE                                        252137754           0    7307
.....
      0   5483 SELECT                                        221493810           0    7307
      0   6763 SELECT                                        197529540           0    7307
      0   4461 SELECT                                          5286436           0    7307
      0   6254 SELECT                                          2737844           0    7307
      0   5233 SELECT                                        193457523           0    7307
      0   7281 SELECT                                          6863271           0    7307
      0   7793 SELECT                                        216482496           0    7307
      0   6002 SELECT                                        203802091           0    7307
.....
      0   7552 SELECT                                        202780999           0    7307
      0   1153 SELECT                                          3760369           0    7307
      0   4993 SELECT                                        186186321           0    7307
      0    130 SELECT                                            11573           0    7307
      0   4482 SELECT                                        181399639           0    7307
      0   7810 SELECT                                          3643055           0    7307
      0   6531 SELECT                                        206037933           0    7307
疑点一:Query has started at: 1900/01/01 00:00:00.00 . 就是这个SQL: TRUNCATE TABLE NETWORK_ABC
看着就不正常。一个truncate应该很快就执行完,确一直hang在那里。
凭多年直觉,感觉就是统计信息没有及时更新,表的统计信息与真实数据之间差距实在太大。于是熊大直接让DBA将表: NETWORK_ABC reorg一下(那样是最快的)。然后所有问题迎刃而解。
后来,熊大跟光头强总结复盘时,发现:
本来这些数据库应该是不会出问题的。因为监控运维系统有一个定时任务,就是每周做一次各个数据库的统计信息更新操作:
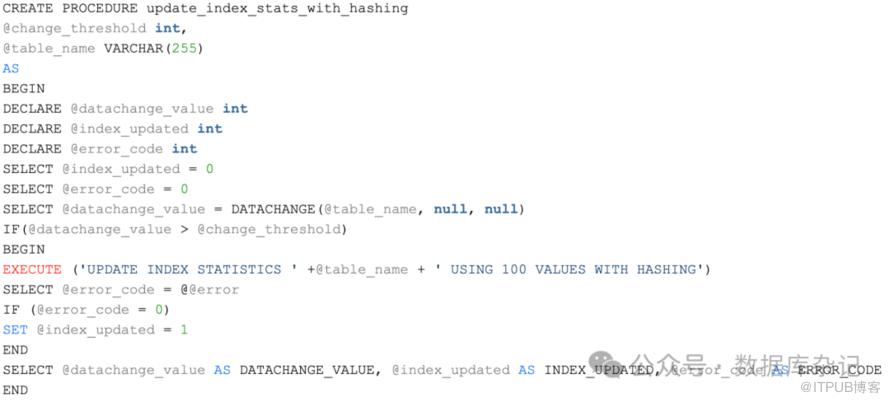
利用上边的过程,遍历业务系统中的所有表,即可完成更新操作,保持统计信息的一致。
可惜问题出在,有些业务库所在的租户处于“死”状态,即一两个月不访问,监控平台针对那些库就直接放弃更新。经过几年的偶发这种场景,最后就出现上述问题,而且是极少的情况下。除了上边的reorg,直接运行一遍更新统计信息,一样能解决问题。
总结
统计信息的更新,对各种数据库几乎都是通用的。更新不及时,一个是查询性能低下,严重情况下,甚至影响系统运行。
我是【Sean】, 欢迎大家长按关注并加星公众号:数据库杂记。为你提供及时更新。

往期导读:
1.
2. Sybase ASE近年来的版本发布
3. Sybase ASE案例-使用DB Tunnel无法正常连接Cloud中的ASE目标数据库
4. Sybase ASE中清除所有表以及获取表占用空间的方法
5. 也说说Sybase ASE中的空间膨胀及应对方案
6. Java版本的Sybase ASE ISQL命令行
7. 中国关系数据库市场:去O似乎还有很远的路要走
8. 聊聊数据库中的用户安全策略
9. PostgreSQL外部表插件jdbc_fdw使用体验
10. 由简单的mod运算符在几种数据库中的支持引发的思考
11. 扩展一下BenchmarkSQL,新增支持ASE/HANA/DB2/SQLServer,可以随便用了
12. PostgreSQL及其它几种数据库中的merge into操作
原文作者:数据库杂记;如有侵权,请联系管理员删除。

最新文章
- PostgreSQL Internals之路 Part-II 第10章 WAL日志
- 从Oracle过渡到PostgreSQL: 理解模式的概念
- PostgreSQL是Oracle的一个可行的替代方案——原因如下
- PostgreSQL Internals之路Part II: Buffer Cache和WAL第9章 Buffer Cache
- 天纵奇才 - "林诗栋"
- 没有PostgreSQL样例数据库,不用担心, 帮你搞定!
- 推荐几本数据库技术图书
- 由浅入深高可用:HAProxy + PostgreSQL配置逐步详解(二)
- PostgreSQL Internals之路 Part-I 第7,8章 冻结、重建表和索引
- 乒坛最新消息引发巨震 - 世界第一王楚钦惨败林诗栋,王曼昱0-4遭横扫,还有孙颖莎4-2稳胜张本美和
