关注并标星 3分钟秒懂大数据
每天1次,打卡阅读
更快更全面获取大数据技术博客
0
目录
1、什么是 Flink SQL CDC Connectors
2、Flink SQL CDC 原理介绍
3、三种数据同步方案
4、Flink SQL CDC + JDBC Connector 同步方案验证
5、Flink SQL CDC + JDBC Connector 端到端一致性分析
1
什么是Flink SQL CDC Connectors
在 Flink 1.11 引入了 CDC 机制,CDC 的全称是 Change Data Capture,用于捕捉数据库表的增删改查操作,是目前非常成熟的同步数据库变更方案。
Flink CDC Connectors 是 Apache Flink 的一组源连接器,是可以从 MySQL、PostgreSQL 数据直接读取全量数据和增量数据的 Source Connectors,开源地址:https://github.com/ververica/flink-cdc-connectors。
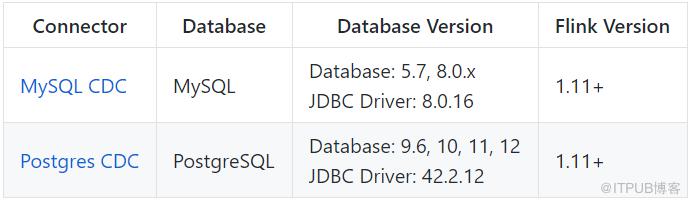
目前(1.13版本)支持的 Connectors 如下:
另外支持解析 Kafka 中 debezium-json 和 canal-json 格式的 Change Log,通过Flink 进行计算或者直接写入到其他外部数据存储系统(比如 Elasticsearch),或者将 Changelog Json 格式的 Flink 数据写入到 Kafka:

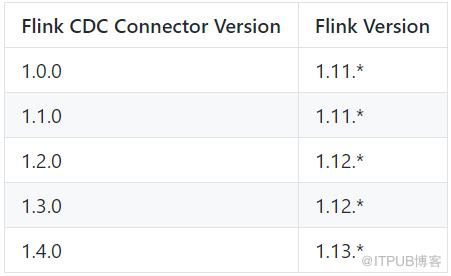
Flink CDC Connectors 和 Flink 之间的版本映射:
2
Flink SQL CDC 原理介绍
在最新CDC 调研报告中,Debezium 和 Canal 是目前最流行使用的 CDC 工具,这些 CDC 工具的核心原理是抽取数据库日志获取变更。在经过一系列调研后,目前Debezium (支持全量、增量同步,同时支持 MySQL、PostgreSQL、Oracle 等数据库),使用较为广泛。
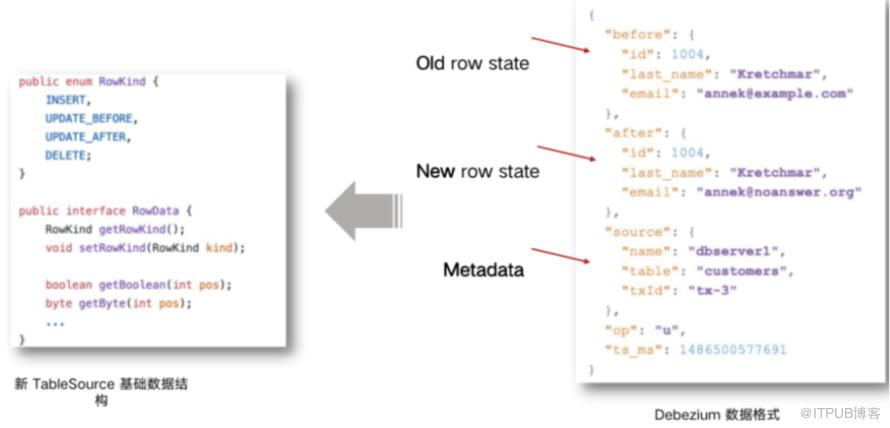
Flink SQL CDC 内置了 Debezium 引擎,利用其抽取日志获取变更的能力,将 changelog 转换为 Flink SQL 认识的 RowData 数据。(以下右侧是 Debezium 的数据格式,左侧是 Flink 的 RowData 数据格式)。
3
三种数据同步方案
3.1 方案一:Debezium+Kafka+计算程序+存储系统
采用 Debezium 订阅 MySQL 的 Binlog 传输到 Kafka,后端是由计算程序从 Kafka 里消费,最后将数据写入到其他存储,架构类似如下:

这种方案中利用 Kafka 消息队列做解耦,Change Log 可供任何其他业务系统使用,消费端可采用 Kafka Sink Connector 或者自定义消费程序,但是由于原生 Debezium 中的 Producer 端未采用幂等特性,因此消息可能存在重复,另外 Kafka Sink Connector(比如 JDBC Sink Connector 只能保证 At least once)或者自定义消费程序在保证数据的一致性上也有难度。
3.2 方案二:Debezium+Kafka+Flink SQL+存储系统
前面讲述了 Flink SQL 具备解析 Kafka 中 debezium-json 和 canal-json 格式的 Change Log 能力,我们可以采用如下同步架构:
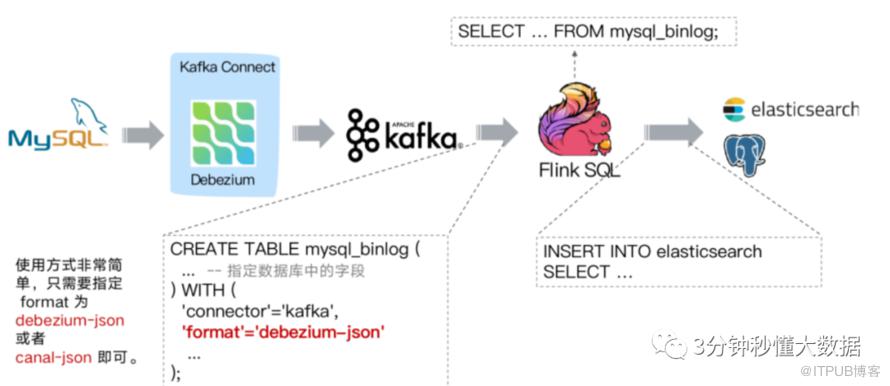
与方案一不同的是,方案二采用 Flink 创建 Kafka 表,指定 format 格式为 debezium-json,然后通过 Flink 进行计算后或者直接插入到其他外部数据存储系统。方案二和方案一类似,组件多维护繁杂,而前述我们知道目前 Flink 1.13 中 CDC Connectors 早已内置 Debezium 引擎,可以替换 Debezium+Kafka 方案,因此有了更简化的方案三。
3.3 方案三:Flink SQL CDC + JDBC Connector
将方案一、二的架构虚线部分用 Flink SQL 替换:
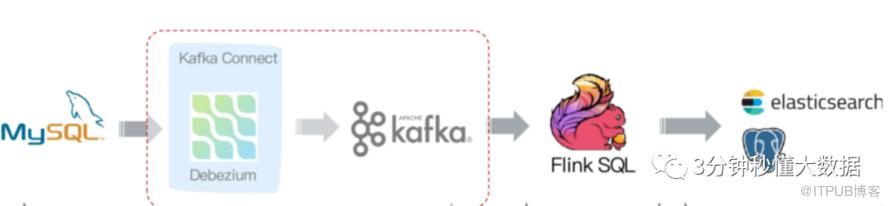
最终改进的方案三架构如下
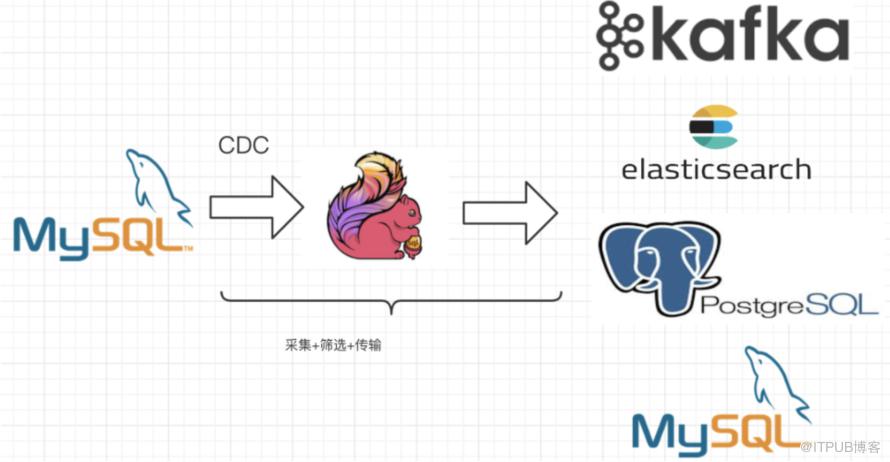
从官方的描述中,通过 Flink CDC connectors 替换 Debezium+Kafka 的数据采集模块,实现 Flink SQL 采集+计算+传输(ETL)一体化,优点很多:
开箱即用,简单易上手
减少维护的组件,简化实时链路,减轻部署成本
减小端到端延迟
Flink 自身支持 Exactly Once 的读取和计算
数据不落地,减少存储成本
支持全量和增量流式读取
binlog 采集位点可回溯
4
Flink SQL CDC + JDBC Connector 同步方案验证
4.1、环境测试和脚本编写
测试的环境和场景 使用 Flink SQL CDC 从 MySQL 数据库同步数据到目标 MySQL,Kafka中。
CREATE TABLE sbtest1 (id INT,k INT,c STRING,pad STRING) WITH ('connector' = 'mysql-cdc','hostname' = '192.XXX.XXX.XXX','port' = '3306','username' = 'root','password' = '123456','database-name' = 'cdcdb','table-name' = 'sbtest1','debezium.snapshot.mode' = 'initial');到DB:create table printSinkTable (id INT,k INT,c STRING,pad STRING,primary key (id) NOT ENFORCED) with ('connector' = 'jdbc','url' = 'jdbc:mysql://192.XXX.XXX.XXX:3306/mydb?useSSL=false&useUnicode=true&characterEncoding=UTF-8&characterSetResults=UTF-8&zeroDateTimeBehavior=CONVERT_TO_NULL&serverTimezone=UTC','username' = 'root','password' = '123456','table-name' = 'sbtest','driver' = 'com.mysql.cj.jdbc.Driver','sink.buffer-flush.interval' = '3s','sink.buffer-flush.max-rows' = '1','sink.max-retries' = '5');INSERT INTO printSinkTable SELECT * FROM sbtest1;到KAFKA:CREATE TABLE kafka_gmv (id INT,k INT,c STRING,pad STRING) WITH ('connector' = 'kafka','topic' = 'kafka_gmv','scan.startup.mode' = 'earliest-offset','properties.bootstrap.servers' = '192.XXX.XXX.XXX:9092','format' = 'changelog-json');INSERT INTO kafka_gmv SELECT * FROM sbtest1;
4.2 测试结论
■ 功能测试
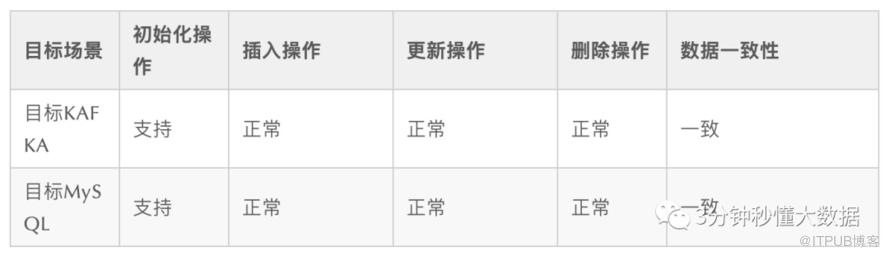
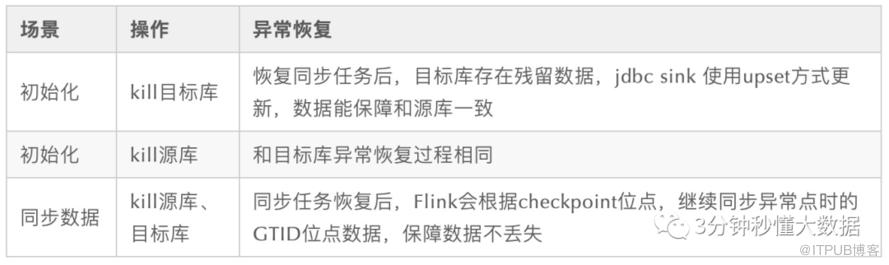
■ 异常测试
常规功能测试
基于 DNS 的数据库切换测试
测试示意图:

○ Flink 需要配置的参数:任务失败后延迟 5 秒重启,重试 10 次。restart-strategy: fixed-delay restart-strategy.fixed-delay.attempts: 10 restart-strategy.fixed-delay.delay: 5s。
○ MySQL 环境信息:一主库两个从库。
○ DNS 配置:DNS 申请了一个域名:XX.XX.cmbc.cn 策略:当前域名指向其中一个从库,探测数据库服务端口,每个 2 分钟自动探测一次。当前数据库异常后 DNS 修改指向到第二个从库。
○ 操作系统和 JVM 缓存配置:JVM 缓存配置 30 秒,操作系统缓存 30 秒。
测试结果:
当 Flink 参数未设置上述参数的情况下,kill 当前访问数据库,Flink 任务报错退出,查看 DNS 没有访问记录。
Flink 配置上述参数后,Flink 后台尝试访问上述数据库,本地 DNS 缓存在访问失败的情况下失效,重新请求 DNS 域名服务器获取新数据库访问信息,任务继续复制。
Flink 高可用测试
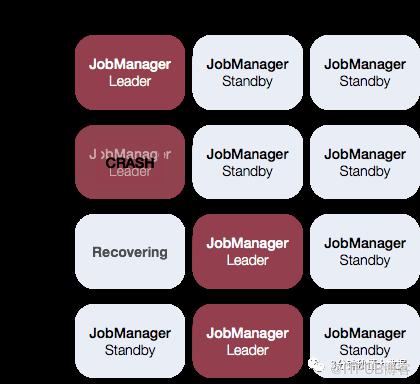
在 Flink 高可用测试中,我们使用 Standalone 集群高可用性方案进行测试,一个主 JobManager,一个从 JobManager,当主节点异常之后,备选节点成为新的 leader,并接管 Flink 集群。新 JobManager 成为新的 leader 后,集群恢复正常,并可以进行任务的调度,异常的任务恢复运行。
这里备选和主节点是一样的,也就是说每个 JobManager 都可以充当备选和主节点。官网的下图展示了这一过程:
异常测试步骤和结果如下:

■ 性能测试
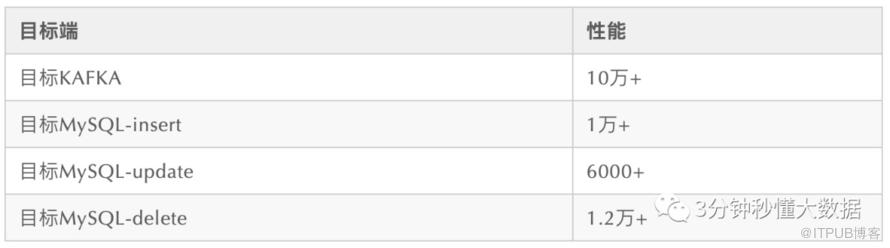
性能测试进行了累计测试,用以检测 Flink cdc 的极限性能,分别测试了 kafka 和 MySQL 作为目标的场景。
测试描述
使用 sysbench 进行压测,插入 200 余万数据,表结构如下:
CREATE TABLE `sbtest1` (`id` int(10) unsigned NOT NULL AUTO_INCREMENT,`k` int(10) unsigned NOT NULL DEFAULT '0',`c` char(120) NOT NULL DEFAULT '',`pad` char(60) NOT NULL DEFAULT '',PRIMARY KEY (`id`),KEY `k_1` (`k`));
累计性能测试结果:
5
Flink SQL CDC + JDBC Connector 端到端一致性分析
Flink SQL CDC + JDBC Connector 本质上是一个 Source 和 Sink 并行度为 1 的Flink Stream Application,Source 和 Sink 之间无 Operator,下面我们逐步分析 Flink SQL CDC + JDBC Connector 端到端如何保证一致性。
5.1 端到端一致性实现条件
一致性就是业务正确性,在“流系统中间件”这个业务领域,端到端一致性就代表 Exactly Once Msg Processing(简称 EOMP),即一个消息只被处理一次,造成一次效果。即使机器或软件出现故障,既没有重复数据,也不会丢数据。
流系统端到端链路较长,涉及到上游 Source 层、中间计算层和下游 Sink 层三部分,要实现端到端的一致性,需要实现以下条件:
上游可以 replay,否则中间计算层收到消息后未计算,却发生 failure 而重启,消息就会丢失。
记录消息处理进度,并保证存储计算结果不出现重复,二者是一个原子操作,或者存储计算结果是个幂等操作,否则若先记录处理进度,再存储计算结果时发生 failure,计算结果会丢失,或者是记录完计算结果再发生 failure,就会 replay 生成多个计算结果。
中间计算结果高可用,应对下游在接到计算结果后发生 failure,并未成功处理该结果的场景,可以考虑将中间计算结果放在高可用的 DataStore里。
下游去重,应对下游处理完消息后发生 failure,重复接收消息的场景,这种可通过给消息设置 SequcenceId 实现去重,或者下游实现幂等。
在 Flink SQL CDC + JDBC Connector 方案中,上游是数据库系统的日志,是可以 replay 的,满足条件1“上游可 replay”,接下来我们分别分析 Flink SQL CDC 如何实现条件 2 和 3,JDBCConnector 如何实现条件 4,最终实现端到端的一致性。以 MySQL->MySQL 为例,架构图如下(目前 Flink SQL1.13 还不支持 Source/Sink 并行度配置的,Flink SQL 中各算子并行度默认是根据 Source 的 Partition 数或文件数来决定的,而 DebeziumSource 的并行度是 1,因此整个 Flink Task 的并行度为 1):

5.2 Flink SQL CDC 的一致性保证
Flink SQL CDC 用于获取数据库变更日志的 Source 函数是 DebeziumSourceFunction,且最终返回的类型是 RowData,该函数实现了 CheckpointedFunction,即通过 Checkpoint 机制来保证发生 failure 时不会丢数,实现 exactly once 语义,这部分在函数的注释中有明确的解释。
/*** The {@link DebeziumSourceFunction} is a streaming data source that pulls captured change data* from databases into Flink.* 通过Checkpoint机制来保证发生failure时不会丢数,实现exactly once语义* <p>The source function participates in checkpointing and guarantees that no data is lost* during a failure, and that the computation processes elements "exactly once".* 注意:这个Source Function不能同时运行多个实例* <p>Note: currently, the source function can't run in multiple parallel instances.** <p>Please refer to Debezium's documentation for the available configuration properties:* https://debezium.io/documentation/reference/1.2/development/engine.html#engine-properties</p>*/public class DebeziumSourceFunction<T> extends RichSourceFunction<T> implementsCheckpointedFunction,ResultTypeQueryable<T> {}
为实现 CheckpointedFunction,需要实现以下两个方法:
public interface CheckpointedFunction {//做快照,把内存中的数据保存在checkpoint状态中void snapshotState(FunctionSnapshotContext var1) throws Exception;//程序异常恢复后从checkpoint状态中恢复数据void initializeState(FunctionInitializationContext var1) throws Exception;}
接下来我们看看 DebeziumSourceFunction 中都记录了哪些状态。
/** Accessor for state in the operator state backend.offsetState中记录了读取的binlog文件和位移信息等,对应Debezium中的*/private transient ListState<byte[]> offsetState;/*** State to store the history records, i.e. schema changes.* historyRecordsState记录了schema的变化等信息* @see FlinkDatabaseHistory*/private transient ListState<String> historyRecordsState;
再回到端到端一致性的条件 2 和 3
2.记录消息处理进度,并保证存储计算结果不出现重复,二者是一个原子操作,或者存储计算结果是个幂等操作,否则若先记录处理进度,再存储计算结果时发生failure,计算结果会丢失,或者是记录完计算结果再发生failure,就会replay生成多个计算结果。
3.中间计算结果高可用,应对下游在接到计算结果后发生failure,并未成功处理该结果的场景,可以考虑将中间计算结果放在高可用的DataStore里。
我们发现在 Flink SQL CDC 是一个相对简易的场景,没有中间算子,是通过 Checkpoint 持久化 binglog 消费位移和 schema 变化信息的快照,来实现 Exactly Once。接下来我们分析 Sink 端。
■ 5.2.1 JDBC Sink Connector 如何保证一致性
我们在官网上发现对于 JDBC Sink Connector 的幂等性中有如下解释:
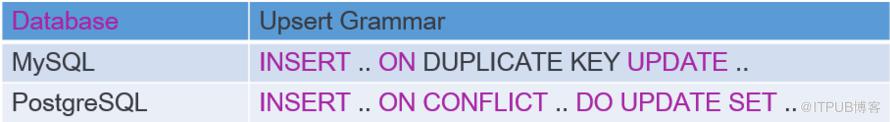
如果定义了主键,JDBC 写入时是能够保证 Upsert 语义的, 如果 DB 不支持 Upsert 语法,则会退化成 DELETE + INSERT 语义。Upsert query 是原子执行的,可以保证幂等性。
这个在官方文档中也详细描述了更新失败或者存在故障时候如何做出的处理,下面的表格是不同的 DB 对应不同的 Upsert 语法:
以上就是Flink SQL 1.13 — CDC的讲解内容!觉得好的,点赞,在看,分享三连击,谢谢!!!

End
找各类大数据技术文章和面经,就来
<3分钟秒懂大数据>
随时更新互联网大数据组件内容
专为学习者提供技术博文
快和身边的小伙伴一起关注我们吧!
作者简介:逆流而上Mr李,秋招7offer,CSDN博客:https://blog.csdn.net/weixin_38201936
原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
