标注并标星 3分钟秒懂大数据
每天1次,打卡阅读
获取AI大数据技术、面经、内推信息
Flink 是目前最火的流式计算组件,那Flink SQL的原理也必然是要掌握的,接下来我将带领大家了解一下Flink SQL的执行流程以及Operation操作。
1、Flink SQL有没有使用过?
用过,在Flink中,一共有四种级别的抽象,而Flink SQL作为最上层,是Flink API的一等公民
在标准SQL中,SQL语句包含四种类型
DML(Data Manipulation Language):数据操作语言,用来定义数据库记录(数据)。
DCL (Data Control Language):数据控制语言,用来定义访问权限和安全级别。
DQL (Data Query Language):数据查询语言,用来查询记录(数据)。
DDL(Data Definition Language):数据定义语言,用来定义数据库对象(库,表,列等)。
Flink SQL包含 DML 数据操作语言、 DDL 数据语言, DQL 数据查询语言,不包含DCL语言。
2、Flink被称作流批一体,那从哪个版本开始,真正实现流批一体的?
从1.9.0版本开始,引入了阿里巴巴的 Blink ,对 FIink TabIe & SQL 模块做了重大的重构,保留了 Flink Planner 的同时,引入了 Blink PIanner,没引入以前,Flink 没考虑流批作业统一,针对流批作业,底层实现两套代码,引入后,基于流批一体理念,重新设计算子,以流为核心,流作业和批作业最终都会被转为transformation。
3、Flink SQL 使用哪种解析器?
Flink SQL使用 Apache Calcite作为解析器和优化器。
Calcite 一种动态数据管理框架,它具备很多典型数据库管理系统的功能 如SQL 解析、 SQL 校验、 SQL 查询优化、 SQL 生成以及数据连接查询等,但是又省略了一些关键的功能,如 Calcite并不存储相关的元数据和基本数据,不完全包含相关处理数据的算法等。
4、Calcite主要功能包含哪些?
Calcite 主要包含以下五个部分:
(1) SQL 解析 (Parser)
Calcite SQL 解析是通过 JavaCC 实现的,使用 JavaCC 编写 SQL 语法描述文件,将 SQL 解析成未经校验的 AST 语法树。
(2) SQL 校验 (Validato)
校验分两部分
1)无状态的校验 即验证 SQL 语句是否符合规范。
2)有状态的校验 即通过与元数据结合验证 SQL 中的 Schema、Field、 Function 是否存 在,输入输出类型是否匹配等。
(3) SQL 查询优化
对上个步骤的输出( RelNode ,逻辑计划树)进行优化,得到优化后的物理执行计划 优化有两种:基于规则的优化 和 基于代价的优化,后面会详细介绍。
(4) SQL 生成
将物理执行计划生成为在特定平台/引擎的可执行程序,如生成符合 MySQL 或 Oracle 等不同平台规则的 SQL 查询语句等。
(5) 数据连接与执行
通过各个执行平台执行查询,得到输出结果。
在Flink 或者其他使用 Calcite 的大数据引擎中,一般到 SQL 查询优化即结束,由各个平台结合 Calcite SQL 代码生成 和 平台实现的代码生成,将优化后的物理执行计划组合成可执行的代码,然后在内存中编译执行。
5、Flink SQL 处理流程说一下?
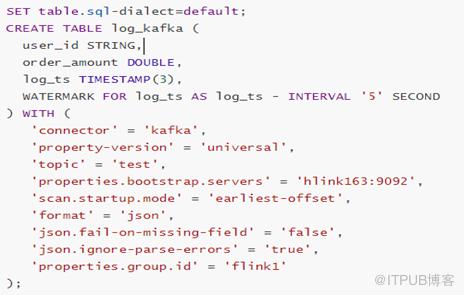
下面举个例子,详细描述一下Flink Sql的处理流程,如下图所示:
我们写一张source表,来源为kafka,当执行create table log_kafka之后 Flink SQL将做如下操作:
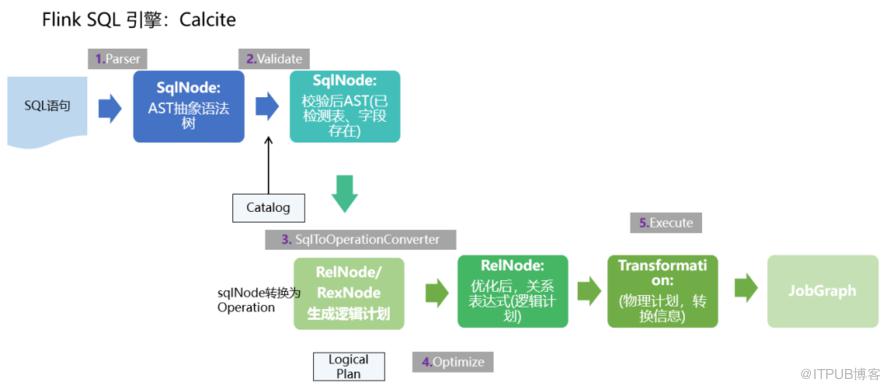
(1)首先,FlinkSQL 底层使用的是 apache Calcite 引擎来处理SQL语句,Calcite会使用javaCC做SQL解析,javaCC根据Calcite中定义的 Parser.jj 文件,生成一系列的java代码,生成的java代码会把SQL转换成AST抽象语法树(即SQLNode类型)。
(2)生成的 SqlNode 抽象语法树,他是一个未经验证的抽象语法树,这时,SQL Validator 会获取 Flink Catalog中的元数据信息来验证 sql 语法,元数据信息检查包括表名,字段名,函数名,数据类型等检查。然后生成一个校验后的SqlNode。
(3)到达这步后,只是将 SQL 解析到 java 数据结构的固定节点上,并没有给出相关节点之间的关联关系以及每个节点的类型信息。所以,还 需要将 SqlNode 转换为逻辑计划,也就是LogicalPlan,在转换过程中,会使用 SqlToOperationConverter 类,来将SqlNode转换为Operation,Operation会根据SQL语法来执行创建表或者删除表等操作,同时FlinkPlannerImpl.rel()方法会将SQLNode转换成RelNode树,并返回RelRoot。
(4)第4步将执行 Optimize 操作,按照预定义的优化规则 RelOptRule 优化逻辑计划。
Calcite中的优化器RelOptPlanner有两种,一是基于规则优化(RBO)的HepPlanner,二是基于代价优化(CBO)的VolcanoPlanner。然后得到优化后的RelNode, 再基于Flink里面的rules将优化后的逻辑计划转换成物理计划。
(5)第5步 执行 execute 操作,会通过代码生成 transformation,然后递归遍历各节点,将DataStreamRelNode 转换成DataStream, 在这期间,会依次递归调用DataStreamUnion、DataStreamCalc、DataStreamScan类中重写的 translateToPlan方法。递归调用各节点的translateToPlan,实际是利用CodeGen元编成Flink的各种算子,相当于直接利用Flink的DataSet或者DataStream开发程序。
(6)最后进一步编译成可执行的 JobGraph 提交运行。
6、Flink SQL包含哪些优化规则?
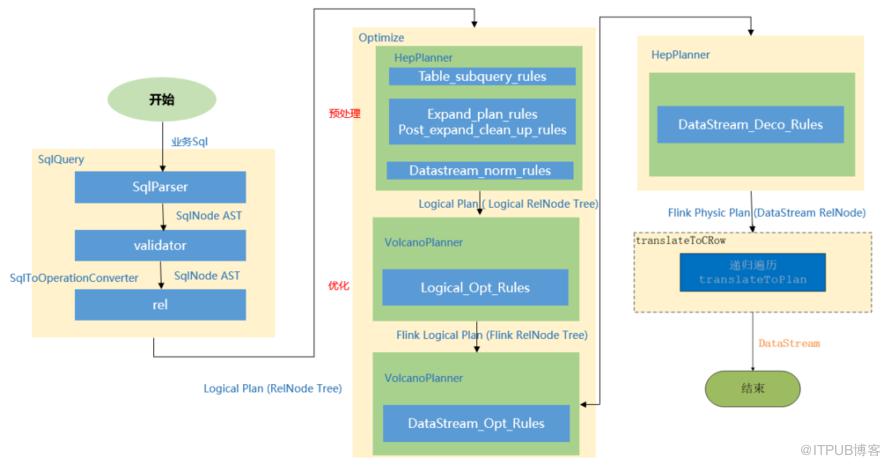
如下图为执行流程图
总结就是:
先解析,然后验证,将SqlNode转化为Operation来创建表,然后调用rel方法将sqlNode变成 逻辑计划 (RelNodeTree)紧接着对逻辑计划进行优化;
优化之前 会根据Calcite中的优化器中的基于规则优化的HepPlanner针对四种规则进行预处理,处理完之后得到Logic RelNode,紧接着使用代价优化的VolcanoPlanner使用 Logical_Opt_Rules(逻辑计划优化)找到最优的执行Planner,并转换为FlinkLogical RelNode。优化规则
最后运用 Flink包含的优化规则,如DataStream_Opt_Rules:流式计算优化,DataStream_Deco_Rules:装饰流式计算优化 将优化后的逻辑计划转换为物理计划。
优化规则包含如下:
Table_subquery_rules 子查询优化
Expand_plan_rules:扩展计划优化
Post_expand_clean_up_rules:扩展计划优化
Datastream_norm_rules:正常化流处理
Logical_Opt_Rules:逻辑计划优化
DataStream_Opt_Rules:流式计算优化
DataStream_Deco_Rules:装饰流式计算优化
7、Flink SQL中涉及到哪些operation?
先介绍一下什么是Operation
在Flink SQL中吗,涉及的DDL,DML,DQL操作都是Operation,在 Flink内部表示,Operation可以和SqlNode对应起来。
Operation执行在优化前,执行的函数为executeQperation,如下图所示,为执行的所有Operation。
以上就是Flink SQL的讲解内容!觉得好的,点赞,在看,分享三连击,谢谢!!!
End
最近整理了一份计算机类的书籍,包含python、java、大数据、人工智能、算法等,种类特别齐全。 获取方式:关注公众号:3分钟秒懂大数据,回复:福利,就可以获得这份超级大礼!,小伙伴们快来领取吧。 点个在看你最好看



原文作者:3分钟秒懂大数据;如有侵权,请联系管理员删除。

最新文章
- 大数据面试,被问到频率最高的三道考题,值得一看~
- 工作中常用的50+ Linux 命令,建议收藏~
- 字节面试sql题:有一张工资表,字段分别是:员工工号、部门、工资。要求各部门除去最高工资和最低工资后的平均工资
- 一篇忍不住看很多遍的数据建模理论与实践(7000字+25张图)
- 网易云音乐P0级事故!官方回应:未删库,未跑路!
- 我发现很多计算机专业的学生都长期处于迷茫中...
- 离职流程都走完了,领导又分了一个新任务让我要么工作日加班,要么周末加班,两周搞完...
- HR最认可的5个离职原因:1、个人发展空间受限;2、公司组织结构变化;3、工作内容与职业发展不匹配...
- 月薪4.5w,离职后每月只补偿2590元,违约就要赔100万!
- 这是雷军的简历,落魄时卡里只有冰冷的40亿...
