前言
python中一切皆对象。追本溯源,回归到基础的时候,发现有些地方,可能自己理解上还不是很深刻,所以自我感觉也有必要再次梳理巩固以下。关于python的垃圾回收机制和gc模块一些认知和理解 以下的纯属个人实践总结之谈,如有纰漏,还希望大佬多多指教。
问题(基于Python3.5的下的实践)
问:什么叫内存垃圾?
答:垃圾(Garbage),在电脑内存的世界里就是:就是那些不能被引用也不能被访问的对象。
问:GC系统所承担的工作主要有哪些?
答:它们负责三个重要任务
为新生成的对象分配内存 识别那些垃圾对象,并且 从垃圾对象那回收内存。
问:查看对象引用计数的方法是?
答:sys.getrefcount(对象)
python中内存回收策略有哪几种?
答:
总的就是:引用计数为主,分代回收 和 标记清除 为辅
引入:分代回收 和标记清除的简单说明。
引用计数为0,则表示当前的对象已无人使用,应该标记为垃圾进行内存释放。引用计数的缺陷就是对应循环应用的对应,无法通过计数标记来定义垃圾,这时候只能通过gc进行回收,所以引入了其他标记清除和分代回收的机制,主要是清理那么循环应用的垃圾。
引用计数回收器(Reference-count Based Collector) 分代回收器(Generation Collector) 标记清除回收器(Mark-and-sweep Collector) 缓存机制
python中的内存泄漏的本质是什么?
答:python内存管理策略中可以知道,如果一个标记为垃圾的对象被回收则内存得以释放。但是如果一些循环引用的对象一直无法释放,即使通过分代回收 和 标记清除也无法回收的情况下的话,就会变为常驻的内存一直占用。随着业务的一直访问创建这样的对象的时候,就是耗尽我们系统内存。所有有些时候我们重启系统后,系统就正常的原因,多数情况是我们的内存不足了,需要重启系统释放一下内存。
所以内存泄漏的本质就是在python里面的引用的技术无法标记为0,无法标记为0的对象则不能进行垃圾回收。
python中内存泄漏几个可能存在的场景?
答:
创建了长期存活的对象 对象变为了常驻内存,无法释放 对象的交叉引用也会造成内存无法释放的问题(循环应用问题) 如果在循环引用中的对象定义了__del__,那么python gc不能进行回收,索引存在内存泄漏的风险 一直不断创建没无法释放的对象 一个长期持有的对象不断的往一个dict或者list对象里添加新的对象, 而又没有即时释放,就会导致这些对象占用的内存越来越多,从而造成内存泄漏。 .......... 总的来说:容易造成内存问题一般可能存在于全局单例、全局缓存、长期存活的对象,对象循环引入等场景中。
python中的内存泄漏常用的分析工具有哪些?
答:
常用的有:
objgraph 非常轻巧的工具,主要用于排查内存泄露 gc Python标准库gc模块 memory_profiler 监控python进程的神器,它可以分析出每一行代码所增减的内存状况。-cProfiler 常用的性能分析器 tracemalloc 跟踪python分配的内存块的调试工具 resource Python标准库提供了抽样随机观察内存使用情况的模块 line_profiler 显示Python函数每一行的用时开销(辅助分析) guppy: 对堆里免对象进行统计,比较实用 pympler: 统计内存里边各种类型的使用, 获取对象的大小 pyrasite: 渗透进入正在运行的python进程动态修改里边的数据和代码,比较牛逼第三方库
什么是引用计数法?它的原理是什么?优缺点有哪些?
答:在解决内存自动回收过程中(即垃圾回收),垃圾回收的实现是一个复杂的过程,垃圾回收难点在于如何鉴别垃圾对 象。当一个对象不再被引用的时候就可以被回收了,程序如何定位到对象是否有被引用,所以仅引出了所谓的引用计数法。
它的原理是:每个对象维护一个ob_ref字段,用来记录此对象被引用的次数.当有新的引用指向时,引用计数+1,当相关的引用失效或删除的时候,则引用计数-1,当对应的引用计数为0的时候,则该对象会被回收,进行内存空间释放。
它的算法特点:
引用计数法示例:
import sys


class A():

   def __init__(self):
       print("对象的地址是:%d" % id(self))


def getObRef(x):
   print("对象的应用计数值为:% d" % sys.getrefcount(x))


if __name__ == "__main__":
   c = A()
   getObRef(c)
   b = c
   getObRef(b)
   del b
   getObRef(c)


 输出的结果是:
 对象的地址是:20298704
 对象的应用计数值为:4
 对象的应用计数值为:5
 对象的应用计数值为:4
 (.venv) PS D:\code\vscode\py>
另一个示例:
import sys


def getObRef(x):
    print("对象的应用计数值为:% d" % sys.getrefcount(x))

if __name__ == "__main__":
    jsd = "as"
    getObRef(jsd)
    jsd2 = jsd
    print(id(jsd))
    print(id(jsd2))
    getObRef(jsd)
    del jsd
    getObRef(jsd2)
输出结果为:
对象的应用计数值为:6
28359456
28359456
对象的应用计数值为:7
对象的应用计数值为:6
(.venv) PS D:\code\vscode\py>
需要单独的字段存储计数器,增加了存储空间的开销;
每次赋值都需要更新计数器,增加了时间开销;
垃圾对象便于辨识,只要计数器为0,就可作为垃圾回收;
及时回收垃圾,没有延迟性;
不能解决循环引用的问题;
引用计数增加的几种方式有哪些?
答:
示例:
import sys


def getObRef(x):
    return sys.getrefcount(x)


def ceshihanshu(x):
    s = x = 'asdas'
    return s


if __name__ == "__main__":
    jsd = "as"
    print("对象被创建:", getObRef(jsd))
    jsd2 = jsd
    print("赋值到另一个对象上:", getObRef(jsd))
    ceshihanshu(jsd)
    print("赋值到另一个对象上:", getObRef(jsd))
    a = [1, jsd, '3233', 'sadas']
    print("作为容器对象的一个元素:", getObRef(jsd))
    a = [1, jsd, '3233', jsd, 'sadas']
    print("作为容器对象的一个元素:", getObRef(jsd))

    对象被创建: 6
    赋值到另一个对象上: 7
    赋值到另一个对象上: 7
    作为容器对象的一个元素: 8
    作为容器对象的一个元素: 9
    (.venv) PS D:\code\vscode\py>
1.对象被创建:x="xxxx" +1 2.赋值到另一个对象上:y=x +1 3.被作容器作一个元素包含:a=[1,x,'33']
引用计数减少的方式有哪几种?
答:
示例:
 import sys


 def getObRef(x):
     return sys.getrefcount(x)


 if __name__ == "__main__":
     jsd = "as"
     print("对象被创建:", getObRef(jsd))
     jsd2 = jsd
     print("赋值到另一个对象上:", getObRef(jsd))
     del jsd2
     print("刪除赋值对象后:", getObRef(jsd))
     a = [1, jsd, '3233', 'sadas']
     print("作为容器对象的一个元素:", getObRef(jsd))
     a.pop(1)
     print("删除作为容器对象的一个元素后:", getObRef(jsd))
     a = [1, jsd, '3233', jsd, 'sadas']
     print("作为容器对象内嵌两个的一个元素:", getObRef(jsd))
     del a
     print("删除容器对象:", getObRef(jsd))

 输出结果:
 对象被创建: 6
 赋值到另一个对象上: 7
 刪除赋值对象后: 6
 作为容器对象的一个元素: 7
 删除作为容器对象的一个元素后: 6
 作为容器对象内嵌两个的一个元素: 8
 删除容器对象: 6
 (.venv) PS D:\code\vscode\py>
1:显示的进行销毁 如:del 2:赋值了新的一个新值对象 3:从容器对象中被删除 4:容器对象本身被删除或容器对象离开对应的函数作用域的时候
如何判断两个引用所指的对象是否相同?
答:使用is判断地址
示例:
if __name__ == "__main__":

    a = 1
    b = 1
    print(id(a), id(b), a is b)
    a = b
    print(id(a), id(b), a is b)

    a = "good"
    b = "good"
    print(id(a), id(b), a is b)

    a = "very good morning"
    b = "very good morning"
    print(id(a), id(b), a is b)

    a = [1]
    b = [1]
    print(id(a), id(b), a is b)

输出结果:
2036636096 2036636096 True
2036636096 2036636096 True
29014976 29014976 True
28478544 28478544 True
28981648 28981768 False
(.venv) PS D:\code\vscode\py>
当变量做为值传到函数也会增加计数引用吗?
答: 会,当使用某个引用作为参数,传递给getrefcount()时,参数实际上创建了一个临时的引用,所以计数会+1.
示例:
import sys


def getObRef(x):
    return sys.getrefcount(x)


if __name__ == "__main__":

    print(sys.getrefcount("asas"))
    kkk = "asas"
    print(sys.getrefcount(kkk))
    print(getObRef(kkk))

输出:
3
4
6
(.venv) PS D:\code\vscode\py>
引用计数底层内部结构是怎么样创建对象?
答:来自武沛齐老师视频笔记记录总结。
来源:https://www.cnblogs.com/wupeiqi/p/11507404.html
环状的双向链表 refchain:
在pythonc程序中所有创建的对象的都会被存放在环状的双向链表 refchain中。
因为python解析器是C写的,在底层,当我们的一个对象创建的时候,C内部的也对应的创建结构体:
 data = 3.14
内部会创建:
_ob_ next■refchai n中的上一个对象
_ob_ prev = refchain中的下一个对象
ob_ refcnt = 1
ob. type = float
ob_ fval = 3.14
删除引用后:

循环引用和交叉感染是啥?
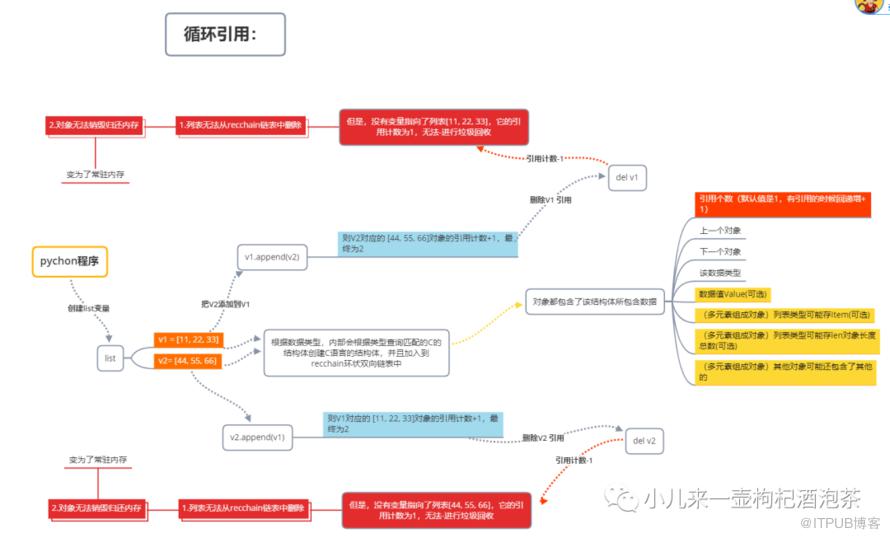
答: 来自武沛齐老师视频笔记记录总结。就是循环引用引起的内存无法释放的一种表现。
示例:
import sys

v1 = [11, 22, 33]
v2 = [44, 55, 66]
print(sys.getrefcount(v1))
print(sys.getrefcount(v2))
v1.append(v2)
v2.append(v1)
print(sys.getrefcount(v1))
print(sys.getrefcount(v2))
del v1
del v2

输出:
2
2
3
3
上面具体的流程图示是:
如何解决循环应用带来的内存暴涨问题?
答: 来自武沛齐老师视频笔记记录总结。引入标注清除机制。
标记-清除的回收机制 思路是:
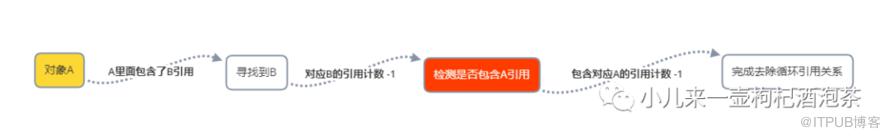 问题描述:假如A对B的引用是单向的, 在到达B之前我不知道B是否也引用了A,这样子先给B减1的话就会使得B称为不可达的对象了?
为了解决这个问题,python中常常把内存块一分为二,将一部分用于保存真的引用计数存在环状的双向链表 refchain,另一部分拿来做为一个引用计数的副本存在一个新的链表上,这个链表用于存贮放置哪些【可能存在】循环应用的对象。比如(list/tupe/dict/set等类型)。
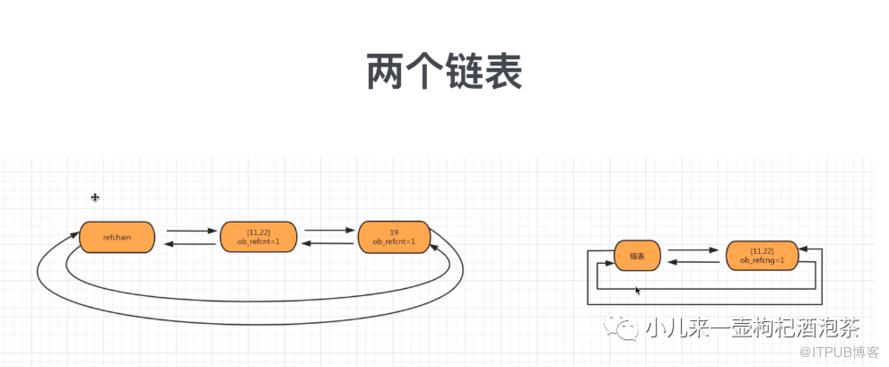 Python 内部,存在可能的触发进行垃圾回收机制时候,对可能存在循环引用的列表的每个元素进行扫描,检测循环应用的是否存在,存在的话,则让双方进行计数引用递减-1,如果是0的话,则进行回收处理。循环扫描可能存在的问题:
扫描的契机 链表的扫描过于庞大和耗时
如何解决标注清除机制带来的扫描问题?
答: 来自武沛齐老师视频笔记记录总结。
引入分代回收机制。
分代回收主要是为了就解决着提升垃圾回收的效率,因为垃圾回收需要鉴别垃圾对象的是否是真垃圾。 为了快速鉴别定位,我们根据垃圾回收频率进行分类,把收频频率详尽的对象归类到同一个类,就是所谓的分代。 分代回收是一种以空间换时间的操作方式,对于分代中,Python将内存根据对象的存活时间划分不同的‘代’。,分别为年轻代(第0代)、中年代(第1代)、老年代(第2代),他们对应的是3个链表,用于存贮放置哪些【可能存在】循环应用的对象。比如(list/tupe/dict/set等类型),它们的垃圾收集频率与对象的存活时间的增大而减小。 对于那些回收频率较高的“代”执行多几次扫描检测,相反,少的就少扫描。这样就可以提高垃圾回收的扫描效率。 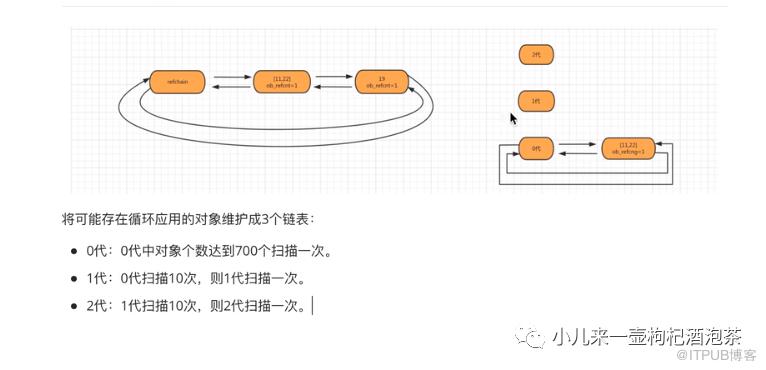
如果多次检测中发送变量的多次引用计数很高的话,说明不能定义为垃圾,如果在好几次垃圾检测中,该变量都是reachable的话,那就说明这个变量越不是垃圾,就要把这个变量往高的代移动,要减少对其进行垃圾检测的频率。 说简单点就是:对象存在时间越长,越可能不是垃圾,应该要减少对其进行垃圾检测的频率。
什么时候会触发GC垃圾回收呢?
答:
达到了垃圾回收阈值,Python虚拟机自动执行. 手动调用gc.collect(). Python虚拟机退出.
为什么小整数对象的引用计数那么多?
答:python为了避免整数的频繁申请和销毁内存空间,使用了小整数对象池,也是python为了内存管理所申请的一个内存池。在python里[-5, 257)内的整数都在小整数对象池中,还有所谓的短字符串,为了便于重复使用,他们都已经被提前建立好了,所以整数池和字母,在系统属于常驻内存(不会重新申请内存),为公用对象,所以输出的结果 比较特殊。这些常驻内存,不会被回收。
代码示例:
import sys
print(sys.getrefcount(-6))
print(sys.getrefcount(-5))
print(sys.getrefcount(-1))
print(sys.getrefcount(1))
print(sys.getrefcount(21))
print(sys.getrefcount(227))
print(sys.getrefcount(257))
print(sys.getrefcount(234234))

输出的结果为:

2
3
34
138
10
4
3
3
引入内存池机制能起到什么作用?
答:
程序运行过程会不断创建对象,进而消耗内存,对对象的创建操作等会引发底层C频繁的调用new/malloc,进而 导致大量的内存碎片,致使效率降低。 引入内存池作用就是预先在内存中申请一定数量的,大小相等的内存块留作备用,当有新的内存申请需求的时候,就优先从内存池中获取内存给这个新申请的需求,而不是开辟新的内存空间,这样做可以明显的减少内存碎片,提升效率。
如果修改分代机制的阀值?
答:
import gc
print(gc.get_threshold())
输出的结果是:
(700,10,10)
返回的是(700,10,10),是gc的分代回收器里设置默认阀值。这个值的意思是说,在分代回收机制中。
gc.set_threshold(threashold0,threshold1,threshold2)来手动设置这组阈值。
在第0代对象数量达到700个之前,不把未被回收的对象放入第一代; 而在第一代对象数量达到10个之前也不把未被回收的对象移到第二代。 在一次垃圾回收中,所有未被回收的对象会被移到高一代的地方。如果需要修改:可以是使用:
参考资料:
https://www.cnblogs.com/Leon-The-Professional/p/10137405.html
https://www.cnblogs.com/wufengtinghai/archive/2012/05/03/2479947.html
https://blog.csdn.net/onlyanyz/article/details/45605773
https://www.cnblogs.com/wupeiqi/p/11507404.html
https://www.jianshu.com/p/1e375fb40506
说明
部分的图来互联网,如有侵权,烦请联系,我会立即进行删除。
End
纯属个人实践中相关经验之谈,如有纰漏,还希望大佬们多多提点!
小钟同学 | 文 【原创】| QQ:308711822
原文作者:程序员小钟同学;如有侵权,请联系管理员删除。

最新文章
- 深入FastAPI异步编程-之并发编程(15)-定义全局的支持全局上下文变量和局部上下文的对象可以任意传递了!
- 深入FastAPI异步编程-之并发编程(13)-纠错-修改基于aiojobs库结合aiojobs的和FastAPI框架的示例
- 深入FastAPI异步编程-之并发编程(13)-基于aiojobs库实现类似Background Tasks的效果
- 深入FastAPI异步编程-之并发编程(12)-基于pyee异步事件驱动通知
- 深入FastAPI异步编程-之并发编程(11)-异步中的?同步原语
- 深入FastAPI异步编程-之并发编程(10)-?asyncio.wait 更精细化并发补充说明
- 深入FastAPI异步编程-之并发编程(9)-asyncio.as_completed的补充说明
- 深入FastAPI异步编程-之并发编程(8)-asyncio.gather的补充说明
- 深入FastAPI异步编程-之并发编程(7)番外篇~Windows系统下事件循环插曲
- 深入FastAPI异步编程-之并发编程(6)~事件循环
