fastapi框架源码分析系列-starlette框架之Debug方式学源码(4)-Request的body消费过程的文+图解
1 前言
从前面我们可以了解到一点,starlette框架本身组件设计其实都是围绕着一个一个ASGIAPP协议方式去封装,所以从这个角度上,我们可以甚至一个一个组件的去拆解分析每一个组件对应的设计理念。
本节重点:
分析HTTPConnection 分析Request 解读Request中的stream,body,json和from
2 requests 分析
首先我们的查看所有关于请求解析里面的包都是来自:
from starlette import requests
然后进入这个requests下面,我们可以看到大概有几个类:如图示:
包说明:
ClientDisconnect -自定义异常类 HTTPConnection - HTTP连接对象信息类 Request 基于HTTPConnection扩展封装类
还有其他几个方法:
cookie_parser cookie解析相关--是一个普通函数 empty_receive 空信息接收异常-RuntimeError--是协程函数 empty_send 空消息发送解析相关-RuntimeError--是协程函数
单独分析HTTPConnection
本身HTTPConnection是一个独立组件,所以我们可以通过它来分析当我们的一个请求过来的时候,我们是如何对请求参数scope: Scope进行‘拆解的’。如源码所示 :
class HTTPConnection(Mapping):
    """
    A base class for incoming HTTP connections, that is used to provide
    any functionality that is common to both `Request` and `WebSocket`.
    """

    def __init__(self, scope: Scope, receive: typing.Optional[Receive] = None) -> None:
        assert scope["type"] in ("http", "websocket")
        self.scope = scope

    def __getitem__(self, key: str) -> typing.Any:
        return self.scope[key]

    def __iter__(self) -> typing.Iterator[str]:
        return iter(self.scope)

    def __len__(self) -> int:
        return len(self.scope)

    # Don't use the `abc.Mapping.__eq__` implementation.
    # Connection instances should never be considered equal
    # unless `self is other`.
    __eq__ = object.__eq__
    __hash__ = object.__hash__

    @property
    def app(self) -> typing.Any:
        return self.scope["app"]

    @property
    def url(self) -> URL:
        if not hasattr(self, "_url"):
            self._url = URL(scope=self.scope)
        return self._url

    @property
    def base_url(self) -> URL:
        if not hasattr(self, "_base_url"):
            base_url_scope = dict(self.scope)
            base_url_scope["path"] = "/"
            base_url_scope["query_string"] = b""
            base_url_scope["root_path"] = base_url_scope.get(
                "app_root_path", base_url_scope.get("root_path", "")
            )
            self._base_url = URL(scope=base_url_scope)
        return self._base_url

    @property
    def headers(self) -> Headers:
        if not hasattr(self, "_headers"):
            self._headers = Headers(scope=self.scope)
        return self._headers

    @property
    def query_params(self) -> QueryParams:
        if not hasattr(self, "_query_params"):
            self._query_params = QueryParams(self.scope["query_string"])
        return self._query_params

    @property
    def path_params(self) -> typing.Dict[str, typing.Any]:
        return self.scope.get("path_params", {})

    @property
    def cookies(self) -> typing.Dict[str, str]:
        if not hasattr(self, "_cookies"):
            cookies: typing.Dict[str, str] = {}
            cookie_header = self.headers.get("cookie")

            if cookie_header:
                cookies = cookie_parser(cookie_header)
            self._cookies = cookies
        return self._cookies

    @property
    def client(self) -> typing.Optional[Address]:
        # client is a 2 item tuple of (host, port), None or missing
        host_port = self.scope.get("client")
        if host_port is not None:
            return Address(*host_port)
        return None

    @property
    def session(self) -> dict:
        assert (
            "session" in self.scope
        ), "SessionMiddleware must be installed to access request.session"
        return self.scope["session"]

    @property
    def auth(self) -> typing.Any:
        assert (
            "auth" in self.scope
        ), "AuthenticationMiddleware must be installed to access request.auth"
        return self.scope["auth"]

    @property
    def user(self) -> typing.Any:
        assert (
            "user" in self.scope
        ), "AuthenticationMiddleware must be installed to access request.user"
        return self.scope["user"]

    @property
    def state(self) -> State:
        if not hasattr(self, "_state"):
            # Ensure 'state' has an empty dict if it's not already populated.
            self.scope.setdefault("state", {})
            # Create a state instance with a reference to the dict in which it should
            # store info
            self._state = State(self.scope["state"])
        return self._state

    def url_for(self, name: str, **path_params: typing.Any) -> str:
        router: Router = self.scope["router"]
        url_path = router.url_path_for(name, **path_params)
        return url_path.make_absolute_url(base_url=self.base_url)
源码简单信息:
首先它是集成于mapping类型的,其实本身就是一个‘映射类型 dict(mapping)’,对于⼀个mapping对象它主要是可以将可哈希的值映射为任意对象,且映射是可变对象。在PY中有两种标准类型映射类型一个是dcit和Set,每个元素都是⼀个键值对(key:value),所以我们可以理解为HTTPConnection其实是一个自定义扩展字典类。
在初始化中,我们看到他需要传入的参数有:
scope: Scope - 必传参数,也就是包含请求信息字典 receive: typing.Optional[Receive] = None 可以为空 然后实现对应字典中其他魔法函数:
  def __getitem__(self, key: str) -> typing.Any:
        # 表示可以通过根据key取值(dict['key'])
        #当如类对象Object['key'],系统会自动调用__getitem__方法,然后返回该方法定义return值
        return self.scope[key]

    def __iter__(self) -> typing.Iterator[str]:
        # 表示表示这个类是一个迭代器(iterator)
        return iter(self.scope)

    def __len__(self) -> int:
        return len(self.scope)
其他的话,通过property应于一些定义某个方法,然后把它当做属性一样来调用方法
Bebug分析:
分析示例源码:
from starlette.types import Receive, Scope, Send
from starlette.requests import HTTPConnection
class FrameApp:
    async def __call__(self, scope: Scope, receive: Receive, send: Send) -> None:
       pass
       httpcon= HTTPConnection(scope,receive)
       print(httpcon)
       await send({
           'type': 'http.response.start',
           'status': 200,
           'headers': [
               [b'content-type', b'text/plain'],
           ],
       })
       await send({
           'type': 'http.response.body',
           'body': b'Hello, world!',
       })

app = FrameApp()
if __name__ == '__main__':
    import uvicorn
    uvicorn.run('dsasd:app')
从前面章节总我们可以知道, scope则具体包含那些信息呐?
scope = {dict: 12} {'type': 'http', 'asgi': {'version': '3.0', 'spec_version': '2.3'}, 'http_version': '1.1', 'server': ('127.0.0.1', 8000), 'client': ('127.0.0.1', 60256), 'scheme': 'http', 'root_path': '', 'headers': [(b'host', b'127.0.0.1:8000'), (b'connection', b'keep-al
 'type' = {str} 'http'
 'asgi' = {dict: 2} {'version': '3.0', 'spec_version': '2.3'}
 'http_version' = {str} '1.1'
 'server' = {tuple: 2} ('127.0.0.1', 8000)
 'client' = {tuple: 2} ('127.0.0.1', 60256)
 'scheme' = {str} 'http'
 'root_path' = {str} ''
 'headers' = {list: 12} [(b'host', b'127.0.0.1:8000'), (b'connection', b'keep-alive'), (b'cache-control', b'max-age=0'), (b'upgrade-insecure-requests', b'1'), (b'user-agent', b'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36'), (b'accept', b'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9'), (b'sec-fetch-site', b'none'), (b'sec-fetch-mode', b'navigate'), (b'sec-fetch-user', b'?1'), (b'sec-fetch-dest', b'document'), (b'accept-encoding', b'gzip, deflate, br'), (b'accept-language', b'zh-CN,zh;q=0.9')]
 'method' = {str} 'GET'
 'path' = {str} '/'
 'raw_path' = {bytes: 1} b'/'
 'query_string' = {bytes: 0} b''
 __len__ = {int} 12
其中:
type:表示此次请求的类型是http还是websocket asgi:则表示来圆asgi服务器的当下版本信息 http_version:http版本协议方式 server:服务启动服务IP和端口信息 client:来自客户端IP和端口号 scheme:请求协议方式 root_path:URL请求发起根目录路径,默认为空字符串 headers:请求头信息 method 请求使用的方式 path:请求URL的path路径信息 raw_path 请求URL的path路径信息 query_string 查询参数信息
所以HTTPConnection主要是对上面参数做一层包装而已, 所有有以下示例截图:
其中部分细节解析完成后:base-url解析完成后如图示: client解析完成后如图示:
url解析完成后:
从上面细节中我们大概可以的明白怎么设计一个解析对象,这样设计很容易让人理解代码的意思!!
那接下里我换成:
  httpcon= Request(scope,receive)
  print(httpcon)
   # 重点解读的地方!!!!!
   # 重点解读的地方!!!!!
  body = await httpcon.body()
  print(body)
由于其他参数解析如查询参数这些都和HTTPConnection一样,所以我们这里不多解析,这里我们重点关注而定是,如果我们需要解析对应的stream, body这些信息改怎么处理呢?
通过POSTMAN发起一个测试看看,图示如下:
然后开始分析,首先我们查看Request的源码:
class Request(HTTPConnection):
    def __init__(
        self, scope: Scope, receive: Receive = empty_receive, send: Send = empty_send
    ):
        # 实现父类的.__init__(scope)调用
        super().__init__(scope)
        # 判断解析请求必须是http类型,其他类似的不支持这种解析
        assert scope["type"] == "http"
        # 赋值当前发送过来消息--默认我我是empty_receive异常处理
        self._receive = receive
        # 赋值当前要发送出去的消息 --默认我我是empty_send异常处理
        self._send = send
        # 标记是否开始进行数据流消费,默认一开始初始化没有进行数据流消费
        self._stream_consumed = False
        # 标记连接是否关闭
        self._is_disconnected = False

    @property
    def method(self) -> str:
        return self.scope["method"]

    @property
    def receive(self) -> Receive:
        return self._receive

    async def stream(self) -> typing.AsyncGenerator[bytes, None]:
        # 注意这里是一个协程哦,所以我们调用的需要注意!

        if hasattr(self, "_body"):
            yield self._body
            yield b""
            return

        if self._stream_consumed:
            raise RuntimeError("Stream consumed")

        self._stream_consumed = True
        while True:
            message = await self._receive()
            if message["type"] == "http.request":
                body = message.get("body", b"")
                if body:
                    yield body
                if not message.get("more_body", False):
                    break
            elif message["type"] == "http.disconnect":
                self._is_disconnected = True
                raise ClientDisconnect()
        yield b""

    async def body(self) -> bytes:
        if not hasattr(self, "_body"):
            chunks = []
            async for chunk in self.stream():
                chunks.append(chunk)
            self._body = b"".join(chunks)
        return self._body

    async def json(self) -> typing.Any:
        if not hasattr(self, "_json"):
            body = await self.body()
            self._json = json.loads(body)
        return self._json

    async def form(self) -> FormData:
        if not hasattr(self, "_form"):
            assert (
                parse_options_header is not None
            ), "The `python-multipart` library must be installed to use form parsing."
            content_type_header = self.headers.get("Content-Type")
            content_type, options = parse_options_header(content_type_header)
            if content_type == b"multipart/form-data":
                multipart_parser = MultiPartParser(self.headers, self.stream())
                self._form = await multipart_parser.parse()
            elif content_type == b"application/x-www-form-urlencoded":
                form_parser = FormParser(self.headers, self.stream())
                self._form = await form_parser.parse()
            else:
                self._form = FormData()
        return self._form

    async def close(self) -> None:
        if hasattr(self, "_form"):
            await self._form.close()

    async def is_disconnected(self) -> bool:
        if not self._is_disconnected:
            message: Message = {}

            # If message isn't immediately available, move on
            with anyio.CancelScope() as cs:
                cs.cancel()
                message = await self._receive()

            if message.get("type") == "http.disconnect":
                self._is_disconnected = True

        return self._is_disconnected

    async def send_push_promise(self, path: str) -> None:
        if "http.response.push" in self.scope.get("extensions", {}):
            raw_headers = []
            for name in SERVER_PUSH_HEADERS_TO_COPY:
                for value in self.headers.getlist(name):
                    raw_headers.append(
                        (name.encode("latin-1"), value.encode("latin-1"))
                    )
            await self._send(
                {"type": "http.response.push", "path": path, "headers": raw_headers}
            )
从上面代码看,当我们需要读取消费请求提交过来的body信息的时候,顺序是:
第1步:await self.body() 第2步:在self.body()里面进行self.stream():的循环读取
如果是把body解析为JSON的话,那么顺序是:
第1步:await self.json() 第2步:await self.body() 第3步:在self.body()里面进行self.stream():的循环读取 第4再对步:body=await self.body()中的body进行转化self._json = json.loads(body)
所以在我们进行调用读取body的时候,首先第一步是:
# 返回是字节数组
 async def body(self) -> bytes:
        # 判断是否存在_body的属性,没有这个属性,说明我们还没有开始解析body的内容信息
        if not hasattr(self, "_body"):
            # 定义接收字节数据
            chunks = []
            # 开始循环的异步读取数据流信息
            async for chunk in self.stream():
                # 把所有读取到字节数据都添加到数组里面
                chunks.append(chunk)
            # 然后开始串联整个字节数组数据
            self._body = b"".join(chunks)
        # 如果有解析过,或者说解析完成了self._body,那么直接的返回
        return self._body
然后我们在进行不断循环读取字节数据的时候是通过stream协程读取:
  async def stream(self) -> typing.AsyncGenerator[bytes, None]:
        # 每一次都判断是不是我们已经完成读取过了body,有的话,我就直接返回,不需要再继续遍历读取了
        if hasattr(self, "_body"):
           # 第一次循环进来 -直接返回已经解析好的_body字节数组
            yield self._body
            # 第二次迭代,我都已经返回过了,我现在没有什么可以返回了,所以返回一个空的了
            yield b""
            return
        # 如果都没有解析完成过_body字节数组,我判断是否以前有开始进行数据量消费过,self._stream_consumed
        # 如果我们以前有消费过了数据流的话,说明已经读取过了,那就不能在进行二次消费了,
        if self._stream_consumed:
            # 二次读取!没了!根本没数据可以给你了!!你还读取!!!给你一个RuntimeError大保健!
            raise RuntimeError("Stream consumed")
        # 开始标记,我要开始接收整个的传递过来的数据了啊!,做个标记先!
        self._stream_consumed = True
        # 开始循环读取
        while True:
           # 开始解析读取发送消息,也就是ASGI服务器传递过来的receive对象
           # 这里回一次性解析读取完成,因为我们传递数据少
            message = await self._receive()
            # 判断这个消息里面的类似是不是http.request类型的
            if message["type"] == "http.request":
                # 如果存在body数据---直接
                body = message.get("body", b"")
                 # 如果存在body数据
                if body:
                    # 直接返回,不在继续往下
                    yield body
                # 当我们从循环里面第二次进来的时候,上面不会在继续跑了!而是直接来到这里判断是否还有更多数据
                if not message.get("more_body", False):
                   # 没有更多body数据需要读取了
                    break
            # 如果是连接关闭类型
            elif message["type"] == "http.disconnect":
                # 标记连接关闭
                self._is_disconnected = True
                # 抛出联机已关闭
                raise ClientDisconnect()
        yield b""
图解上述流程:
1:判断属性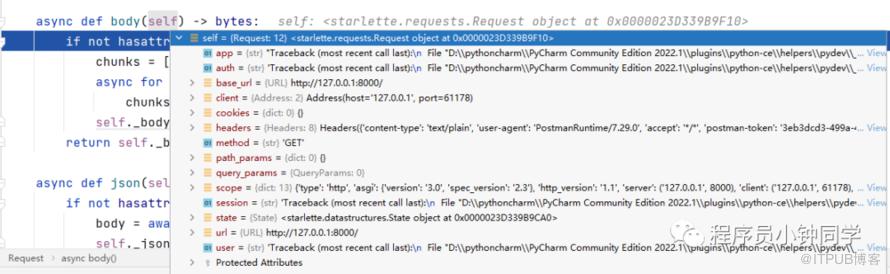 2:开始读取数据流
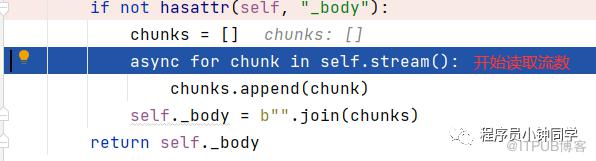 3:判断是否已经存在消费国boby数据
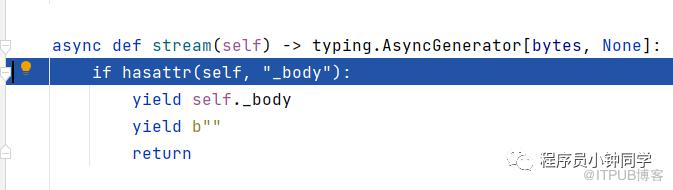 4:没有消费过,在判断是否已经标记也存在效果过
 5:开始标记
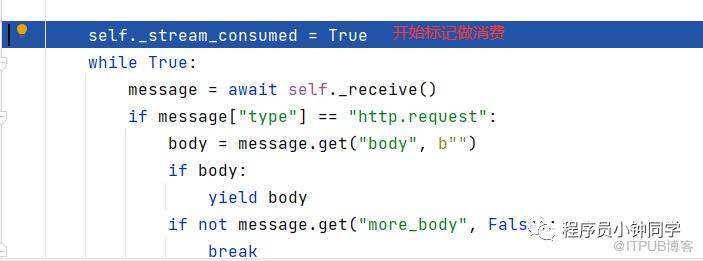 6:读消息
 7:进入到asgi服务器里面去读信息了
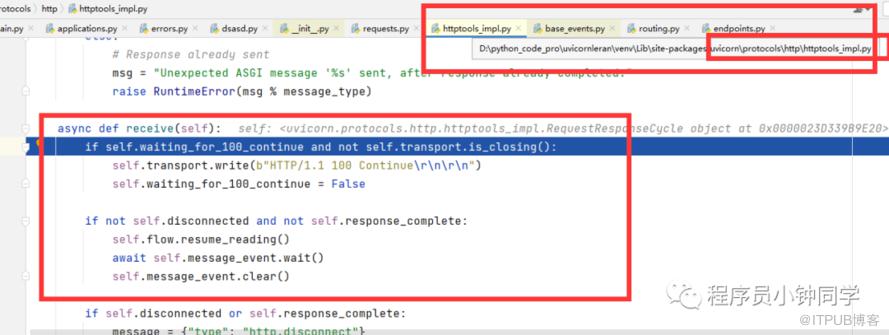 8:然后第一性读取完成发过来的额数据了,且类似也返回了
9:如果返回的body有数据存在,那么直接yield返回去,退出当前第一次循环
10:返回到循环中:
11:进行添加到数组中!
12:然后再【第二次】的进行循环里面:
13:查看是否还有更多的提交过来的body信息,发现没有了!就break了
14:既然没有了退出循环,那我就直接爬往下继续跑,这个时候就返回空字节了
15:这个时候发现我们的返回是空的字节了,
16:这个地方还会进行两次循环:
17:串联字节数组
18:开始返回具体读取body数据
以上就是关于一个请求过程中body消费的流程!其他则是JSON处理,如下图示例:
 如果我们的知道提交过来就是标准JSON的话可以直接使用上面的方式读取!!!!
关于form的话,其实大体都一样流程:
 async def form(self) -> FormData:
        # 先判断是否解析过FORM
        if not hasattr(self, "_form"):
            # 依赖于python-multipart库的检测
            assert (
                parse_options_header is not None
            ), "The `python-multipart` library must be installed to use form parsing."
            # 解析头部信息
            content_type_header = self.headers.get("Content-Type")
            content_type, options = parse_options_header(content_type_header)
            # 根据不同content_type类型处理
            if content_type == b"multipart/form-data":
                multipart_parser = MultiPartParser(self.headers, self.stream())
                self._form = await multipart_parser.parse()
            elif content_type == b"application/x-www-form-urlencoded":
               # 如果是文件类型,则调用self.stream()按流程的方式读取!
                form_parser = FormParser(self.headers, self.stream())

                self._form = await form_parser.parse()
            else:
                self._form = FormData()
        return self._form
这里面主要涉及到表单解析类处理:
class FormParser:
    def __init__(
        self, headers: Headers, stream: typing.AsyncGenerator[bytes, None]
    ) -> None:
        assert (
            multipart is not None
        ), "The `python-multipart` library must be installed to use form parsing."
        self.headers = headers
        self.stream = stream
        self.messages: typing.List[typing.Tuple[FormMessage, bytes]] = []

    def on_field_start(self) -> None:
        message = (FormMessage.FIELD_START, b"")
        self.messages.append(message)

    def on_field_name(self, data: bytes, start: int, end: int) -> None:
        message = (FormMessage.FIELD_NAME, data[start:end])
        self.messages.append(message)

    def on_field_data(self, data: bytes, start: int, end: int) -> None:
        message = (FormMessage.FIELD_DATA, data[start:end])
        self.messages.append(message)

    def on_field_end(self) -> None:
        message = (FormMessage.FIELD_END, b"")
        self.messages.append(message)

    def on_end(self) -> None:
        message = (FormMessage.END, b"")
        self.messages.append(message)

    async def parse(self) -> FormData:
        # Callbacks dictionary.
        callbacks = {
            "on_field_start": self.on_field_start,
            "on_field_name": self.on_field_name,
            "on_field_data": self.on_field_data,
            "on_field_end": self.on_field_end,
            "on_end": self.on_end,
        }

        # Create the parser.
        parser = multipart.QuerystringParser(callbacks)
        field_name = b""
        field_value = b""

        items: typing.List[typing.Tuple[str, typing.Union[str, UploadFile]]] = []

        # Feed the parser with data from the request.
        async for chunk in self.stream:
            if chunk:
                parser.write(chunk)
            else:
                parser.finalize()
            messages = list(self.messages)
            self.messages.clear()
            for message_type, message_bytes in messages:
                if message_type == FormMessage.FIELD_START:
                    field_name = b""
                    field_value = b""
                elif message_type == FormMessage.FIELD_NAME:
                    field_name += message_bytes
                elif message_type == FormMessage.FIELD_DATA:
                    field_value += message_bytes
                elif message_type == FormMessage.FIELD_END:
                    name = unquote_plus(field_name.decode("latin-1"))
                    value = unquote_plus(field_value.decode("latin-1"))
                    items.append((name, value))

        return FormData(items)
差不多吧!其实里面的我们需要关注点可能就是关于数据流的解析,后续关于文件流再单独抽出来去看!
以上仅仅是个人结合自己的实际需求,做学习的实践笔记!如有笔误!欢迎批评指正!感谢各位大佬!
结尾
END
简书:https://www.jianshu.com/u/d6960089b087
掘金:https://juejin.cn/user/2963939079225608
公众号:微信搜【程序员小钟同学】
小钟同学 | 文 【欢迎一起学习交流】| QQ:308711822
原文作者:程序员小钟同学;如有侵权,请联系管理员删除。

最新文章
- 深入FastAPI异步编程-之并发编程(15)-定义全局的支持全局上下文变量和局部上下文的对象可以任意传递了!
- 深入FastAPI异步编程-之并发编程(13)-纠错-修改基于aiojobs库结合aiojobs的和FastAPI框架的示例
- 深入FastAPI异步编程-之并发编程(13)-基于aiojobs库实现类似Background Tasks的效果
- 深入FastAPI异步编程-之并发编程(12)-基于pyee异步事件驱动通知
- 深入FastAPI异步编程-之并发编程(11)-异步中的?同步原语
- 深入FastAPI异步编程-之并发编程(10)-?asyncio.wait 更精细化并发补充说明
- 深入FastAPI异步编程-之并发编程(9)-asyncio.as_completed的补充说明
- 深入FastAPI异步编程-之并发编程(8)-asyncio.gather的补充说明
- 深入FastAPI异步编程-之并发编程(7)番外篇~Windows系统下事件循环插曲
- 深入FastAPI异步编程-之并发编程(6)~事件循环
