游戏行业内流传着一句口头禅:有米选米,无米选timi,这里的米并非小米公司,而是米哈游。
公司的福利方面也是很到位的:每年 2 次调薪窗口、 每年10天年假,补充公积金+五险+商业医疗险、3天带薪病假、免费体检福利(包含一位家属)、内部专属咖啡吧、零食饮料不限量供应、免费午餐晚餐 等,且不说其他,就前面两条已经足矣让很多人心动了。
有位同学得到了一些米哈游面经之后,已经准备了挺长时间,但是为了求稳,他放弃赶在五一前去米哈游面试了。
毕竟简历仅能投递1个岗位,稳一点还是挺好的,不过要参加春季校招的也要抓紧了,因为五一过后很快就会关闭网申/内推通道了。
看一下后端开发工程师的任职要求,虽然写的不多,但是考察的点还是挺细的。前一段时间还爆说:985硕士5连简历都过不了!,关于这一点咱不做评论。
下面分享一位米哈游后端面经,五一了,简单罗列下
另外文末有个彩蛋!
算法
手撕一个快速排序
快速排序的核心思想是分治法(Divide and Conquer)。该算法的基本步骤如下:
1、选择基准:从待排序的数组中选取一个元素作为基准元素(Pivot)。
2、分区操作:通过一趟排序,将待排序的数组分为两个子序列,左侧子序列中的所有元素都小于等于基准元素,右侧子序列中的所有元素都大于基准元素。这个过程称为分区操作,分区完成后,基准元素就位于数组中的一个固定位置,该位置的索引也反映了基准元素在排序后数组中的最终位置。
3、递归排序子序列:递归地对左右两个子序列重复上述步骤,即对左侧子序列和右侧子序列分别进行快速排序,直到整个序列变为有序。
golang手推代码
// quickSort 是快速排序的递归函数
func quickSort(arr []int, low, high int) {
    if low < high {
        // partitionIndex 是分区操作返回的索引,arr[partitionIndex] 已经在最终位置上了
        partitionIndex := partition(arr, low, high)
        // 对左子数组进行快速排序
        quickSort(arr, low, partitionIndex-1)
        // 对右子数组进行快速排序
        quickSort(arr, partitionIndex+1, high)
    }
}
// partition 函数负责将数组分为两部分,并返回基准元素的正确位置
func partition(arr []int, low, high int) int {
    pivot := arr[high] // 选择最后一个元素作为基准
    i := low - 1      // i 是比基准小的元素的最后一个位置
    for j := low; j < high; j++ {
        // 如果当前元素小于或等于pivot
        if arr[j] <= pivot {
            i++
            arr[i], arr[j] = arr[j], arr[i] // 交换元素
        }
    }
    // 把基准元素放到正确的位置上
    arr[i+1], arr[high] = arr[high], arr[i+1]
    return i + 1
}
首先定义了quickSort函数,它接收一个整数切片和两个索引(low和high),表示要排序的切片区间。在这个函数内部,通过调用partition函数来找到基准元素的正确位置,并对基准元素左右两侧的子数组递归地执行快速排序。
partition函数的作用是选取一个“基准”元素(这里简单地选择数组的最后一个元素),然后遍历数组,将所有小于等于基准的元素移动到基准的左侧,大于基准的元素移动到右侧,最后返回基准元素的正确索引位置。
操作系统
OSI参考模型
应用层:为特定应用程序提供数据传输服务,例如 HTTP、DNS 等协议。数据单位为报文。表示层:数据压缩、加密以及数据描述,这使得应用程序不必关心在各台主机中数据内部格式不同的问题。会话层:建立及管理会话。传输层(运输层):为进程提供通用数据传输服务。由于应用层协议很多,定义通用的传输层协议就可以支持不断增多的应用层协议。运输层包括两种协议:传输控制协议 TCP,提供面向连接、可靠的数据传输服务,数据单位为报文段;用户数据报协议 UDP,提供无连接、尽最大努力的数据传输服务,数据单位为用户数据报。TCP 主要提供完整性服务,UDP 主要提供及时性服务。网络层:为主机提供数据传输服务。而传输层协议是为主机中的进程提供数据传输服务。网络层把传输层传递下来的报文段或者用户数据报封装成分组。数据链路层:网络层针对的还是主机之间的数据传输服务,而主机之间可以有很多链路,链路层协议就是为同一链路的主机提供数据传输服务。数据链路层把网络层传下来的分组封装成帧。物理层:考虑的是怎样在传输媒体上传输数据比特流,而不是指具体的传输媒体。物理层的作用是尽可能屏蔽传输媒体和通信手段的差异,使数据链路层感觉不到这些差异。
❝五层协议没有表示层和会话层,而是将这些功能留给应用程序开发者处理。
❝TCP/IP 协议:它只有四层,相当于五层协议中数据链路层和物理层合并为网络接口层。
TCP/IP 体系结构不严格遵循 OSI 分层概念,应用层可能会直接使用 IP 层或者网络接口层。
数据在OSI参考模型中的传递过程
数据在OSI参考模型中的传递过程,在向下的过程中,需要添加下层协议所需要的首部和尾部,而在向上的过程中不断拆开首部和尾部。
路由器只有下面三层协议,因为路由器位于网络核心中,不需要为进程或者应用程序提供服务,因此也就不需要传输层和应用层。
数据在各层传递过程及数据格式变化
数据格式变化
短连接与长连接
当浏览器访问一个包含多张图片的 HTML 页面时,除了请求访问的 HTML 页面资源,还会请求图片资源。如果每进行一次 HTTP 通信就要新建一个 TCP 连接,那么开销会很大。
长连接只需要建立一次 TCP 连接就能进行多次 HTTP 通信。
从 HTTP/1.1 开始默认是长连接的,如果要断开连接,需要由客户端或者服务器端提出断开,使用 Connection : close;
在 HTTP/1.1 之前默认是短连接的,如果需要使用长连接,则使用 Connection : Keep-Alive。
HTTPS 采用的加密方式
HTTPS 的加密方式是采用混合的加密机制
使用 非对称密钥加密方式(一般是:RSA),传输对称密钥加密方式所需要的 Secret Key,从而保证安全性;获取到 Secret Key 后,再使用 对称密钥加密方式进行通信,从而保证效率。(下图中的 Session Key 就是 Secret Key)
关于对称密钥加密
关于对称密钥加密,加密和解密使用同一密钥。
优点:运算速度快; 缺点:无法安全地将密钥传输给通信方。
关于非对称密钥加密
非对称密钥加密,又称公开密钥加密(Public-Key Encryption),加密和解密使用不同的密钥。
公开密钥所有人都可以获得,通信发送方获得接收方的公开密钥之后,就可以使用公开密钥进行加密,接收方收到通信内容后使用私有密钥解密。
非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥(私钥)无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥(公钥)对签名进行解密,就能判断这个签名是否正确。
优点:可以更安全地将公开密钥传输给通信发送方; 缺点:运算速度慢。
建立连接的三次握手
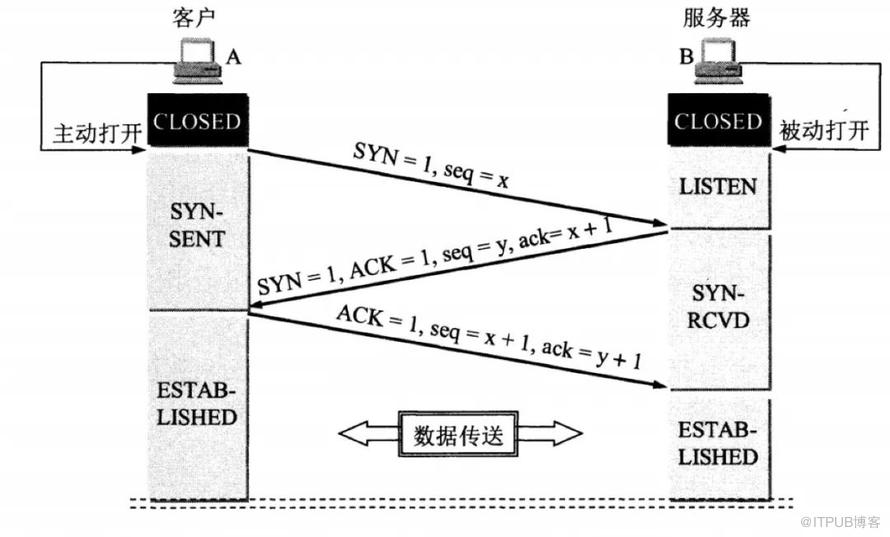
假设 A 为客户端,B 为服务器端。
首先 B 处于 LISTEN(监听)状态,等待客户的连接请求。
A 向 B 发送连接请求报文,SYN=1,ACK=0,选择一个初始的序号 x。
B 收到连接请求报文,如果同意建立连接,则向 A 发送连接确认报文,SYN=1,ACK=1,确认号为 x+1(x+数据长度。因为tcp建立连接三次握手中的固定的数据长度,所以是x+1),同时也选择一个初始的序号 y。
A 收到 B 的连接确认报文后,还要向 B 发出确认,确认号为 y+1,序号为 x+1。
B 收到 A 的确认后,连接建立。
TCP三次握手的原因
第三次握手是为了防止失效的连接请求到达服务器,让服务器错误打开连接。
客户端发送的连接请求如果在网络中滞留,那么就会隔很长一段时间才能收到服务器端发回的连接确认。客户端等待一个超时重传时间之后,就会重新请求连接。但是这个滞留的连接请求最后还是会到达服务器,如果不进行三次握手,那么服务器就会打开两个连接。如果有第三次握手,客户端会忽略服务器之后发送的对滞留连接请求的连接确认,不进行第三次握手,因此就不会再次打开连接。
Golang
GMP是什么
G(Goroutine):我们所说的协程,为用户级的轻量级线程,每个 Goroutine 对象中的 sched 保存着其上下文信息。M(Machine):对内核级线程的封装,数量对应真实的 CPU 数(真正干活的对象)。P(Processor):即为 G 和 M 的调度对象,用来调度 G 和 M 之间的关联关系,其数量可通过 GOMAXPROCS()来设置,默认为核心数。
GMP 调度流程
MySQL
MySQL的基本架构
客户端:最上层的服务并不是MySQL所独有的,大多数基于网络的客户端/服务器的工具或者服务都有类似的架构。比如连接处理、授权认证、安全等等。Server层:大多数MySQL的核心服务功能都在这一层,包括查询解析、分析、优化、缓存以及所有的内置函数(例如,日期、时间、数学和加密函数),所有跨存储引擎的功能都在这一层实现:存储过程、触发器、视图等。存储引擎层:第三层包含了存储引擎。存储引擎负责MySQL中数据的存储和提取。Server层通过API与存储引擎进行通信。这些接口屏蔽了不同存储引擎之间的差异,使得这些差异对上层的查询过程透明。
一条查询 SQL 的执行过程
1、先检查该语句是否有权限,如果没有权限,直接返回错误信息,如果有权限会先查询缓存(MySQL8.0 版本以前,MySQL8.0 版本之后去除大部分的查询缓存)。
2、如果没有缓存,解析器进行语法分析,提取 sql 语句中 select 等关键元素,然后判断 sql 语句是否有语法错误,比如关键词是否正确等等。
3、语法解析之后,MySQL的服务器会对查询的语句进行优化,确定执行的方案。
4、完成查询优化后,按照生成的执行计划调用数据库引擎接口,返回执行结果。
MySQL索引的数据结构
MySQL的默认存储引擎是InnoDB,它采用的是B+树结构的索引。
B+树:只有叶子节点才会存储数据,非叶子节点只存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。
在这张图里,有两个重点:
最外面的方块,的块我们称之为一个 磁盘块,可以看到每个磁盘块包含几个数据项(粉色所示)和指针(黄色/灰色所示),如根节点磁盘包含数据项(左开右闭)17和35,包含指针P1、P2、P3,P1表示小于等于17的磁盘块,P2表示在大于17和小于等于35之间的磁盘块,P3表示大于35的磁盘块。真实的数据存在于叶子节点即3、4、5……、65。非叶子节点不存储真实的数据,只存储指引搜索方向的数据项,如17、35并不真实存在于数据表中。叶子节点之间使用 双向指针连接,最底层的叶子节点形成了一个双向有序链表,可以进行范围查询。
索引失效的场景
在索引列上使用mysql的内置函数,索引失效。 对索引列运算(如,+、-、*、/),索引失效。 索引字段上使用(!= 或者 < >,not in)时,可能会导致索引失效。 索引字段上使用is null, is not null,可能导致索引失效。字段为空是可以走索引的,但是部分场景可能会失效,字段尽量设置为非null然后设置默认值 如果字段类型是字符串,where时一定用引号括起来,否则会因为隐式类型转换,索引失效 like通配符可能导致索引失效。最左前缀不仅仅适用于组合索引,还适用于varchar的like语句,但是要注意,只有like "XXX%"的情况走索引,like "%XXX"和like "%XXX%"是不走索引的。 查询条件包含or或者in,可能导致索引失效。具体是由MySQL优化器内部决定是全表扫描还是索引查找,用效率较高的一种方式。 联合索引,查询时的条件列不是联合索引中的第一个列,索引失效。 左连接查询或者右连接查询查询关联的字段编码格式不一样,可能导致索引失效。 MySQL优化器估计使用全表扫描要比使用索引快,则不使用索引:MySQL优化器内部就是找到一个索引扫描行数最少的方案去执行语句。那么扫描行数怎么来判断的?是逐行统计数据表的数据吗?其实并不是,而是根据统计信息来预估的值,这个统计信息就是我们常说的索引的“区分度”。
建议:在使用前最好还是先用 explain 来试试到底sql语句走不走索引,然后选择较优的sql。
觉得有用,点个赞、在看或者转发 再走呀❤️
最后,最后,彩蛋来啦~~
🎆烟花智能助理 V1.0上线啦!!
📚可以帮助我们高效创建个人专属知识库哦
💡想学的都可以交给烟花!搜索+总结+解析+答疑+召回 为我们一步服务到位哦。
使用手册(烟花添加二维码也在里面哦):
https://hqexj12b0g.feishu.cn/docx/KNfLdBpxOoYl9JxQg1AcNXosnwh

偷偷说一句:她已经在我微信聊天里置顶了,集实力与好听声音的女孩谁不爱。
另外想加入我们一支烟花AI社区学习交流群的加我微信,拉你入群一起学习交流~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

