大家好,我是皇子。
得物App是集正品潮流电商和潮流生活社区于一体的新一代潮流网购社区。
目前在招的2024年应届毕业生,毕业时间在2023年9月-2024年8月期间,要求:最高学历毕业后无全职工作经验。
校招的流程同其他公司基本一致的4步曲:投递&内推 > 笔试/测评 > 面试 > offer 发放。而面试轮次一般为1~3轮,根据不同职类会有所区别,不过技术类岗位都是3轮。
国内校招开放的城市包括:上海&武汉&郑州&南京&广州&香港
现在校招的技术岗位并不多了,想冲的抓紧吧~
这里分享一位得物后端同学的面经,这次问得虽然不是很细,但比较多,自己没把握住,止步二面了,想要得物内推的联系皇子,另外文末有彩蛋。
下面罗列考察的知识点,确实蛮多的,包括:
经典算法
Golang:new、make 关键字和 GMP 模型
Redis:数据类型的用法、Redis 的数据淘汰策略
服务器:正向代理、反向代理
MySQL:锁、MySQL 事务、事务隔离级别、并发一致性问题
操作系统:进程与线程、进程状态切换
容器化技术:Docker 和 Kubernetes 的核心概念。
手撕冒泡排序
冒泡排序:核心是,使用两次遍历
一次找元素
一次遍历比较确定最大值:比较相邻值,小的在左大的在右,最后一个即为最大值。
/**
 * @Desc:   冒泡排序
 *  1. 比较相邻的元素。如果第一个比第二个大,就交换他们两个。
 *  2. 对每一对相邻元素做同样的工作,从开始第一对到结尾的最后一对。在这一点,最后的元素应该会是最大的数。
 *  3. 针对所有的元素重复以上的步骤,除了最后一个。
 *  4. 持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较
 */

// 升序
func BubbleSort(arr []int64) []int64 {
    for i := 0; i < len(arr)-1; i++ {
        for j := 1; j < len(arr)-i; j++ {
            if arr[j-1] > arr[j] {
                arr[j], arr[j-1] = arr[j-1], arr[j]
            }
        }
    }
    return arr
}
Golang
如何在运行时检查变量类型
类型开关(Type Switch)是在运行时检查变量类型的最佳方式。类型开关按类型而不是值来评估变量。每个 Switch 至少包含一个 case 用作条件语句,如果没有一个 case 为真,则执行 default。
new 的作用是什么?
new 创建一个该类型的实例,并且返回指向该实例的指针。
new 函数是内建函数,函数定义:func new(Type) *Type
注意:
传递给 new 函数的是一个类型,而不是一个值 使用 new 函数来分配空间 返回值是指向这个新分配的地址的指针
make 的作用是什么?
make 的作用是为 slice``map、 chan 的初始化 然后返回引用。
make 函数是内建函数,函数定义:func make(Type, size IntegerType) Type
make(T, args) 函数的目的和 new(T) 不同,make仅仅用于创建 slice、map、channel 而且返回类型是实例
GMP是什么
G(Goroutine):我们所说的协程,为用户级的轻量级线程,每个 Goroutine 对象中的 sched 保存着其上下文信息。M(Machine):对内核级线程的封装,数量对应真实的 CPU 数(真正干活的对象)。P(Processor):即为 G 和 M 的调度对象,用来调度 G 和 M 之间的关联关系,其数量可通过 GOMAXPROCS()来设置,默认为核心数。
GMP 调度流程
Redis
介绍下Redis支持的数据类型及应用场景
STRING(字符串)
概念:String是Redis最基础的数据结构类型,它是二进制安全的,可以存储图片或者序列化的对象,值最大存储为512M
应用场景:共享 session、分布式锁,计数器、限流。
实现原理:C语言的字符串是char[]实现的,而Redis使用SDS(simple dynamic string) 封装,SDS源码如下:
struct sdshdr{
  unsigned int len; // 标记buf的长度
  unsigned int free; //标记buf中未使用的元素个数
  char buf[]; // 存放元素的坑
}
HASH(哈希)
概念:在Redis中,哈希类型是指v(值)本身又是一个键值对(k-v)结构
使用示例:hset hash-key field value 、hget hash-key field、hgetall hash-key、...
内部编码:ziplist(压缩列表) 、hashtable(哈希表)
应用场景:缓存用户信息等。
注意点:如果开发使用hgetall,哈希元素比较多的话,可能导致Redis阻塞,可以使用hscan。而如果只是获取部分field,建议使用hmget。
LIST(列表)
概念:列表(list)类型是用来存储多个有序的字符串,一个列表最多可以存储2^32-1个元素。
使用示例:lpush key value [value ...] 、lrange key start end
内部编码:ziplist(压缩列表)、linkedlist(链表)
应用场景:消息队列,文章列表
list应用场景参考以下:
lpush+lpop=Stack(栈)
lpush+rpop=Queue(简单队列)
lpush+ltrim=Capped Collection(有限集合)
lpush+brpop=Message Queue(消息队列)
SET(集合)
简介:集合(set)类型也是用来保存多个的字符串元素,但是不允许重复元素
使用示例:sadd key element [element ...]、smembers key
内部编码:intset(整数集合)、hashtable(哈希表)
应用场景:用户标签,生成随机数抽奖、社交需求。
注意点:smembers和lrange、hgetall都属于比较重的命令,如果元素过多存在阻塞Redis的可能性,可以使用sscan来完成。
ZSET(有序集合)
简介:已排序的字符串集合,同时元素不能重复
使用示例:zadd key score member [score member ...],zrank key member
底层内部编码:ziplist(压缩列表)、skiplist(跳跃表)
应用场景:排行榜,社交需求(如用户点赞)
Bitmaps
Bitmap,即位图,是一串连续的二进制数组(0和1),可以通过偏移量(offset)定位元素。
BitMap通过最小的单位bit来进行0|1的设置,表示某个元素的值或者状态,时间复杂度为O(1)。
由于bit是计算机中最小的单位,使用它进行储存将非常节省空间,特别适合一些数据量大且使用二值统计的场景。
Hyperloglogs
用来做基数统计的算法,HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定的、并且是很小的。比如适合统计网站的UV
在 Redis 里面,每个 HyperLogLog 键只需要花费 12 KB 内存,就可以计算接近 2^64 个不同元素的基数。这和计算基数时,元素越多耗费内存就越多的集合形成鲜明对比。
但是,因为 HyperLogLog 只会根据输入元素来计算基数,而不会储存输入元素本身,所以 HyperLogLog 不能像集合那样,返回输入的各个元素
什么是基数?
比如数据集 {1, 3, 5, 7, 5, 7, 8}, 那么这个数据集的基数集为 {1, 3, 5 ,7, 8}, 基数(不重复元素)为5。基数估计就是在误差可接受的范围内,快速计算基数。
基数:一个集合中不重复的元素的个数。
HyperLogLog则是一种算法,它提供了不精确的去重计数方案。
Geospatial
Geo 主要用于存储地理位置(空间)信息,并对存储的信息进行操作,该功能在 Redis 3.2 版本新增。
Redis GEO 操作方法有:
geoadd:添加地理位置的坐标。 geopos:获取地理位置的坐标。 geodist:计算两个位置之间的距离。 georadius:根据用户给定的经纬度坐标来获取指定范围内的地理位置集合。 georadiusbymember:根据储存在位置集合里面的某个地点获取指定范围内的地理位置集合。 geohash:返回一个或多个位置对象的 geohash 值。
跳跃表
跳跃表是有序集合的底层实现之一
跳跃表实现由
zskiplist和zskiplistNode两个结构组成,其中zskiplist用于保存跳跃表信息(如表头节点、表尾节点、长度),而zskiplistNode则用于表示跳跃表节点。跳跃表是Redis特有的数据结构,跳跃表就是在链表的基础上,增加多级索引提升查找效率。
跳跃表支持平均 O(logN),最坏 O(N)复杂度的节点查找,还可以通过顺序性操作批量处理节点。
在查找时,从上层指针开始查找,找到对应的区间之后再到下一层去查找。下图演示了查找 7 的过程。
与红黑树等平衡树相比,跳跃表具有以下优点:
插入速度非常快速,因为不需要进行旋转等操作来维护平衡性。
更容易实现。
支持无锁操作。
数据淘汰策略有哪些
我们通常在设计一个系统的时候,由于数据库的读取速度远小于内存的读取速度,所以为了加快读取速度,会将一部分数据放到内存中,称为缓存。
但是内存容量是有限的,当你要缓存的数据超出容量,就得有部分数据删除,这时候哪些数据删除,哪些数据保留, 就是缓存淘汰策略要干的事情。
Redis 具体有 6 种淘汰策略:
| 策略 | 描述 |
|---|---|
| volatile-lru | 当内存不足以容纳新写入数据时,从设置了过期时间的key中使用LRU(最近最少使用)算法进行淘汰 |
| allkeys-lru | 当内存不足以容纳新写入数据时,从所有key中使用LRU算法进行淘汰 |
| volatile-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,在过期的key中,使用LFU(最不经常使用)算法进行删除key |
| allkeys-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,从所有key中使用LFU算法进行淘汰 |
| volatile-random | 当内存不足以容纳新写入数据时,从设置了过期时间的key中,随机淘汰数据 |
| allkeys-random | 当内存不足以容纳新写入数据时,从所有key中随机淘汰数据 |
| volatile-ttl | 当内存不足以容纳新写入数据时,在设置了过期时间的key中,根据过期时间进行淘汰,越早过期的优先被淘汰 |
| noeviction | 默认策略,当内存不足以容纳新写入数据时,新写入操作会报错 |
服务器
正向代理
一个位于客户端和原始服务器(origin server)之间的服务器,为了从原始服务器取得内容,客户端向代理发送一个请求并指定目标(原始服务器),然后代理向原始服务器转交请求并将获得的内容返回给客户端。
客户端才能使用正向代理。
正向代理总结就一句话:代理端代理的是客户端。例如说:我们使用的OpenVPN 等等。
反向代理
反向代理(Reverse Proxy)方式,是指以代理服务器来接受Internet上的连接请求,然后将请求,发给内部网络上的服务器并将从服务器上得到的结果返回给 nternet上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。
反向代理总结就一句话:代理端代理的是服务端。
Mysql
MySQL 锁有哪几种
按锁粒度划分,有以下3种:
表锁:开销小,加锁快;锁定力度大,发生锁冲突概率高,并发度最低;不会出现死锁。
行锁:开销大,加锁慢;会出现死锁;锁定粒度小,发生锁冲突的概率低,并发度高。
页锁:开销和加锁速度介于表锁和行锁之间;会出现死锁;锁定粒度介于表锁和行锁之间,并发度一般。
按锁模式有该5种:记录锁、间隙锁、临键锁、意向锁、插入意向锁
按加锁方式有两种:乐观锁、悲观锁。
按兼容性,有如下两种:
共享锁(S Lock),也叫读锁(read lock),相互不阻塞。
排他锁(X Lock),也叫写锁(write lock),排它锁是阻塞的,在一定时间内,只有一个请求能执行写入,并阻止其它锁读取正在写入的数据。
MySQL 事务的四大特性
ACID是 MySQL 事务的四大特性
1、原子性(Atomicity)
事务被视为不可分割的最小单元,事务的所有操作要么全部提交成功,要么全部失败回滚。
回滚可以用回滚日志(Undo Log)来实现,回滚日志记录着事务所执行的修改操作,在回滚时反向执行这些修改操作即可。
2、一致性(Consistency)
数据库在事务执行前后都保持一致性状态。在一致性状态下,所有事务对同一个数据的读取结果都是相同的。假如 A 账户给 B 账户转 10 块钱,不管成功与否,A 和 B 的总金额是不变的。
3、隔离性(Isolation)
一个事务所做的修改在最终提交以前,对其它事务是不可见的。
4、持久性(Durability)
一旦事务提交,则其所做的修改将会永远保存到数据库中。即使系统发生崩溃,事务执行的结果也不能丢失。
系统发生崩溃可以用重做日志(Redo Log)进行恢复,从而实现持久性。
与回滚日志(Undo Log)记录数据的逻辑修改不同,重做日志记录的是数据页的物理修改。
事务隔离级别
读未提交(READ UNCOMMITTED):事务中的修改,即使没有提交,对其它事务也是可见的。
读已提交(READ COMMITTED):一个事务只能读取已经提交的事务所做的修改。换句话说,一个事务所做的修改在提交之前对其它事务是不可见的。
可重复读(REPEATABLE READ):保证在同一个事务中多次读取同一数据的结果是一样的。
可串行化(SERIALIZABLE):强制事务串行执行,这样多个事务互不干扰,不会出现并发一致性问题。该隔离级别需要加锁实现,因为要使用加锁机制保证同一时间只有一个事务执行,也就是保证事务串行执行。
事务隔离级别解决的并发一致性问题
并发一致性问题包含:脏读、不可重复读、幻读
一图看透4种事务隔离级别:读未提交、读已提交、可重复读、可串行化,分别解决哪些并发一致性问题。
操作系统
进程与线程
进程
进程是资源分配的基本单位。
进程控制块 (Process Control Block, PCB) 描述进程的基本信息和运行状态,所谓的创建进程和撤销进程,都是指对 PCB 的操作。
下图显示了 4 个程序创建了 4 个进程,这 4 个进程可以并发地执行。
线程
线程是独立调度的基本单位。
一个进程中可以有多个线程,它们共享进程资源。
QQ 和浏览器是两个进程,浏览器进程里面有很多线程,例如 HTTP 请求线程、事件响应线程、渲染线程等等,线程的并发执行使得在浏览器中点击一个新链接从而发起 HTTP 请求时,浏览器还可以响应用户的其它事件。
区别
拥有资源:
进程是资源分配的基本单位,但是线程不拥有资源,线程可以访问隶属进程的资源。调度:
线程是独立调度的基本单位,在同一进程中,线程的切换不会引起进程切换;从一个进程中的线程切换到另一个进程中的线程时,会引起进程切换。系统开销:由于创建或撤销进程时,系统都要为之分配或回收资源,如内存空间、I/O 设备等,所付出的开销远大于创建或撤销线程时的开销。类似地,在进行进程切换时,涉及当前执行进程 CPU 环境的保存及新调度进程 CPU 环境的设置,而线程切换时只需保存和设置少量寄存器内容,开销很小。
通信方面:线程间可以通过直接读写同一进程中的数据进行通信,但是进程通信需要借助 IPC。
进程状态切换
就绪状态(ready):等待被调度 运行状态(running):正在运行 阻塞状态(waiting):等待资源
应该注意以下内容:
只有
就绪态和运行态可以相互转换,其它的都是单向转换。就绪状态的进程通过调度算法从而获得 CPU 时间,转为运行状态;而运行状态的进程,在分配给它的 CPU 时间片用完之后就会转为就绪状态,等待下一次调度。阻塞状态是缺少需要的资源从而由运行状态转换而来,但是该资源不包括 CPU 时间,缺少 CPU 时间会从运行态转换为就绪态。
容器技术
Docker主要解决了什么问题
由于不同的机器有不同的操作系统,以及不同的库和组件,在将一个应用部署到多台机器上需要进行大量的环境配置操作。
Docker 主要解决环境配置问题,它是一种虚拟化技术,对进程进行隔离,被隔离的进程独立于宿主操作系统和其它隔离的进程。
使用 Docker 可以不修改应用程序代码,不需要开发人员学习特定环境下的技术,就能够将现有的应用程序部署在其它机器上。
Docker与虚拟机的比较优势是什么
虚拟机也是一种虚拟化技术,它与 Docker 最大的区别在于它是通过模拟硬件,并在硬件上安装操作系统来实现。
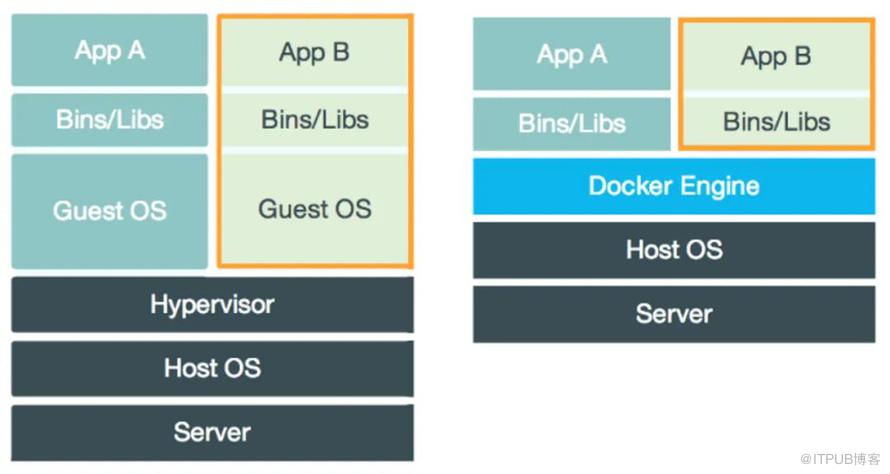
启动速度:
启动虚拟机需要先启动虚拟机的操作系统,再启动应用,这个过程非常慢;
而启动 Docker 相当于启动宿主操作系统上的一个进程。
占用资源:
虚拟机是一个完整的操作系统,需要占用大量的磁盘、内存和 CPU 资源,一台机器只能开启几十个的虚拟机。
而 Docker 只是一个进程,只需要将应用以及相关的组件打包,在运行时占用很少的资源,一台机器可以开启成千上万个 Docker。
Docker还有哪些优势
更容易迁移:提供一致性的运行环境。已经打包好的应用可以在不同的机器上进行迁移,而不用担心环境变化导致无法运行。
更容易维护:使用分层技术和镜像,使得应用可以更容易复用重复的部分。复用程度越高,维护工作也越容易。
更容易扩展:可以使用基础镜像进一步扩展得到新的镜像,并且官方和开源社区提供了大量的镜像,通过扩展这些镜像可以非常容易得到我们想要的镜像。
介绍Kubernetes及核心的概念有哪些
Kubernetes是一个开源的容器编排平台,用于自动化部署、扩展和管理容器化应用程序。
Kubernetes的主要目标:简化容器应用程序的部署和管理。它提供了一组丰富的功能,包括自动化部署、自动伸缩、负载均衡、存储管理、自我修复等。通过使用Kubernetes,开发人员可以更轻松地构建、部署和管理容器化应用程序,同时运维人员可以更高效地管理和扩展应用程序。
Kubernetes的核心概念包括以下几个方面:
Pod:是Kubernetes中最小的可部署单元,包含一个或多个容器。 ReplicaSet:用于定义Pod的副本数量,确保Pod的可用性和扩展性。 Deployment:用于定义应用程序的部署策略,包括Pod的副本数量、更新策略等。 Service:提供了一个稳定的网络入口,用于访问一组Pod。 -
Namespace:用于将集群划分为多个虚拟集群,实现资源隔离和管理。
觉得有用,点个赞、在看或者转发 再走呀❤️
最后,最后,彩蛋来啦~~
🎆烟花智能助理 V1.0上线啦!!
📚可以帮助我们高效创建个人专属知识库哦
💡想学的都可以交给烟花!搜索+总结+解析+答疑+召回 为我们一步服务到位哦。
使用手册(烟花添加二维码也在里面哦):
https://hqexj12b0g.feishu.cn/docx/KNfLdBpxOoYl9JxQg1AcNXosnwh
偷偷说一句:她已经在我微信聊天里置顶了,集实力与好听声音的女孩谁不爱。
另外想加入我们一支烟花AI社区学习交流群的加我微信,拉你入群一起学习交流~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

