大家好,我是皇子。
哗哩哔哩是中国年轻一代高度聚集的综合性视频社区,被用户亲切地称为B站。
B站自2009年成立以来,已经从一个小小的弹幕视频网站发展成为一个拥有庞大用户基础的综合性视频社区。
它以其独特的弹幕文化和社区互动,围绕用户、创作者和内容,吸引了大量忠实粉丝,成为中国年轻一代的重要聚集地。
B站还构建了一个源源不断产生优质内容的生态系统,目前,B站94%的视频播放量都来自于专业用户创作的视频。

在我看来,B站是一个有温度的社区,有着以技术驱动的二次元乐园,还有开源共享精神,有着丰富的免费课程,受众非常广泛。
如:大家都熟悉的罗翔说刑法;互联网技术从业者熟悉的编程与计算机科学的:计算机编程入门(如Python、Golang、Java等)、Web开发(前端、后端技术)、人工智能与机器学习等;还有前段时间,B站在五四青年节到来之时,以这些网络乱象为背景,邀请演员祖峰,扮演一位操控舆论、玩弄真假的“大魔术师”,为我们揭示网络谣言背后的剧本世界 ——《大魔术师》。这是一部“献给五四青年节的讽刺喜剧公益片”,其中有一句很经典:当情绪占据舆论的主导地位,真相将不再重要,辟谣会被当成洗地,解释会被当成掩饰,连道歉都被当成占用公共资源。
.....
就是这样一个有温度的社区,也成为有很多同学在2024年春招都想进去的理由。
听在里面的小伙伴说,里面的氛围还不错:Mentor 很有责任心、不 push 加班,工作时间固定:10:00 - 19:00,中午 2 小时休息。20:30 有深夜食堂,21:30 打车免费,不定期的员工福利活动(UP 主扫楼、大会员首映礼、健身班、健康体检等等),另外有非常非常多的社团,可以根据自己的喜好参加。
下面就介绍一位B站后端开发的面经,他虽然被挑战了,但还是等来了HR面,坐等office中(另外,文末有彩蛋)
手撕算法
三数之和
给定一个包含 n 个整数的数组 nums,判断 nums 中是否存在三个元素 a,b,c,使得 a + b + c = 0?找出所有满足条件且不重复的三元组。
注意:
解集不能包含重复的三元组。 你可以假设每个输入都只有一个解。
解题思路:对数组进行排序是解决这类问题的第一步。排序之后,可以更方便地利用双指针技巧来查找满足条件的元素组合,同时能够简化检查重复解的过程。
设计LRU
LRU(Least Recently Used)算法是一种缓存淘汰策略,当缓存空间不足时,它会优先移除最近最少使用的数据项,以确保经常访问的数据得以保留。
LRU的核心在于高效地维护数据的访问顺序,这通常通过哈希表(快速查找)和双向链表(维护访问顺序)结合实现。
实现思路:
1、哈希表:用于快速定位数据的链表节点,键为数据的唯一标识(如key),值为链表节点的指针。
2、双向链表:按访问顺序排列数据,新访问的数据移到链表头部,头部为最近访问的数据,尾部为最久未访问的数据。
网络
HTTPS 采用的加密方式
HTTPS 的加密方式是采用混合的加密机制
使用 非对称密钥加密方式(一般是:RSA),传输对称密钥加密方式所需要的 Secret Key,从而保证安全性;获取到 Secret Key 后,再使用 对称密钥加密方式进行通信,从而保证效率。(下图中的 Session Key 就是 Secret Key)
关于对称密钥加密
关于对称密钥加密,加密和解密使用同一密钥。
优点:运算速度快; 缺点:无法安全地将密钥传输给通信方。
关于非对称密钥加密
非对称密钥加密,又称公开密钥加密(Public-Key Encryption),加密和解密使用不同的密钥。
公开密钥所有人都可以获得,通信发送方获得接收方的公开密钥之后,就可以使用公开密钥进行加密,接收方收到通信内容后使用私有密钥解密。
非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥(私钥)无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥(公钥)对签名进行解密,就能判断这个签名是否正确。
优点:可以更安全地将公开密钥传输给通信发送方; 缺点:运算速度慢。
建立连接的三次握手
假设 A 为客户端,B 为服务器端。
1、首先 B 处于 LISTEN(监听)状态,等待客户的连接请求。
2、A 向 B 发送连接请求报文,SYN=1,ACK=0,选择一个初始的序号 x。
3、B 收到连接请求报文,如果同意建立连接,则向 A 发送连接确认报文,SYN=1,ACK=1,确认号为 x+1(x+数据长度。因为tcp建立连接三次握手中的固定的数据长度,所以是x+1),同时也选择一个初始的序号 y。
4、A 收到 B 的连接确认报文后,还要向 B 发出确认,ACK=1,确认号为 y+1,序号为 x+1。
5、B 收到 A 的确认后,连接建立。
TCP三次握手的原因
第三次握手是为了防止失效的连接请求到达服务器,让服务器错误打开连接。
客户端发送的连接请求如果在网络中滞留,那么就会隔很长一段时间才能收到服务器端发回的连接确认。客户端等待一个超时重传时间之后,就会重新请求连接。但是这个滞留的连接请求最后还是会到达服务器,如果不进行三次握手,那么服务器就会打开两个连接。如果有第三次握手,客户端会忽略服务器之后发送的对滞留连接请求的连接确认,不进行第三次握手,因此就不会再次打开连接。
TCP 关闭连接的四次挥手
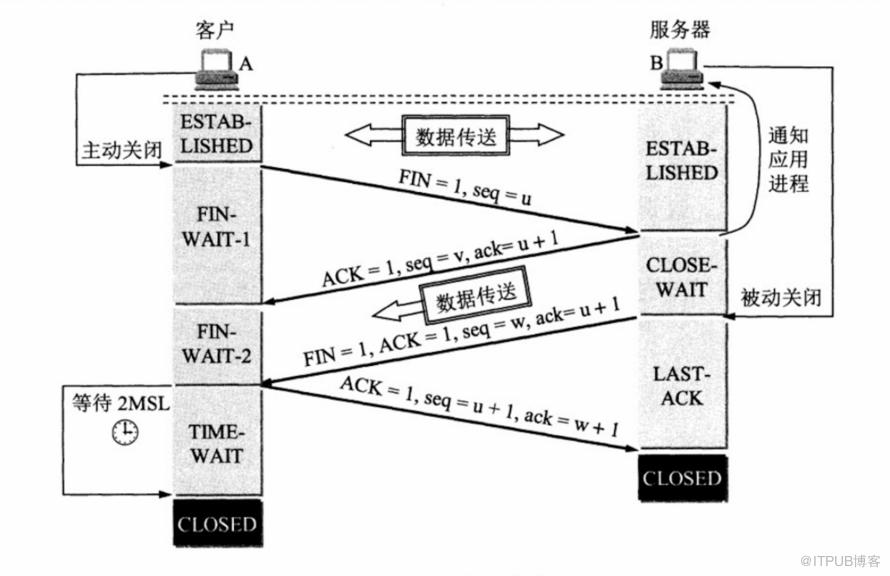
以下描述不讨论序号和确认号,因为序号和确认号的规则比较简单。并且不讨论 ACK,因为 ACK 在连接建立之后都为 1。
1、A 发送连接释放报文,FIN=1。
2、B 收到之后发出确认,此时 TCP 属于半关闭状态,进入CLOSE-WAIT状态,B 能向 A 发送数据但是 A 不能向 B 发送数据。
3、当 B 不再需要连接(B在处理的请求全部发送给了A)时,发送连接释放报文,FIN=1。
4、A 收到后发出确认,进入 TIME-WAIT 状态,等待 2 MSL(最大报文存活时间)后释放连接。
5、B 收到 A 的确认后释放连接。
四次挥手的原因
客户端发送了 FIN 连接释放报文之后,服务器收到了这个报文,就进入了 CLOSE-WAIT 状态。这个状态是为了让服务器端发送还未传送完毕的数据,传送完毕之后,服务器会发送 FIN 连接释放报文。
Golang
GMP是什么
G(Goroutine):我们所说的协程,为用户级的轻量级线程,每个 Goroutine 对象中的 sched 保存着其上下文信息。M(Machine):对内核级线程的封装,数量对应真实的 CPU 数(真正干活的对象)。P(Processor):即为 G 和 M 的调度对象,用来调度 G 和 M 之间的关联关系,其数量可通过 GOMAXPROCS()来设置,默认为核心数。
GMP 调度流程
Redis
缓存穿透
指的是对某个一定不存在的数据进行请求,该请求将会穿透缓存到达数据库。
解决方案:
对这些不存在的数据缓存一个空数据;
对这类请求进行过滤。
缓存雪崩
指的是由于数据没有被加载到缓存中,或者缓存数据在同一时间大面积失效(过期),又或者缓存服务器宕机,导致大量的请求都到达数据库。
在有缓存的系统中,系统非常依赖于缓存,缓存分担了很大一部分的数据请求。当发生缓存雪崩时,数据库无法处理这么大的请求,导致数据库崩溃。
解决方案:
为了防止缓存在同一时间大面积过期导致的缓存雪崩,可以通过观察用户行为,合理设置缓存过期时间来实现;
为了防止缓存服务器宕机出现的缓存雪崩,可以使用分布式缓存,分布式缓存中每一个节点只缓存部分的数据,当某个节点宕机时可以保证其它节点的缓存仍然可用。
也可以进行缓存预热,避免在系统刚启动不久由于还未将大量数据进行缓存而导致缓存雪崩。
缓存一致性
缓存一致性要求数据更新的同时缓存数据也能够实时更新。
解决方案:
在数据更新的同时立即去更新缓存;
在读缓存之前先判断缓存是否是最新的,如果不是最新的先进行更新。
要保证缓存一致性需要付出很大的代价,缓存数据最好是那些对一致性要求不高的数据,允许缓存数据存在一些脏数据。
Mysql
说说 MySQL 的基础架构?
客户端:最上层的服务并不是MySQL所独有的,大多数基于网络的客户端/服务器的工具或者服务都有类似的架构。比如连接处理、授权认证、安全等等。
Server层:大多数MySQL的核心服务功能都在这一层,包括查询解析、分析、优化、缓存以及所有的内置函数(例如,日期、时间、数学和加密函数),所有跨存储引擎的功能都在这一层实现:存储过程、触发器、视图等。
存储引擎层:第三层包含了存储引擎。存储引擎负责MySQL中数据的存储和提取。Server层通过API与存储引擎进行通信。这些接口屏蔽了不同存储引擎之间的差异,使得这些差异对上层的查询过程透明。
MySQL有哪些常见存储引擎?
常见的有:InnoDB和MylSAM
InnoDB和 MylSAM 存储引擎的区别?
存储结构:每个MyISAM在磁盘上存储成三个文件.frm、.MYD、.MYI;InnoDB所有的表都保存在同一个数据文件(共享表:.ibdata),也可能是多个文件或者是独立的表空间文件(独享表:.ibd),InnoDB表的大小只受限于操作系统文件的大小,一般为2GB。
事务支持:MyISAM不提供事务支持;InnoDB提供事务支持事务,具有事务(commit)、回滚(rollback)和崩溃修复能力(crash recovery capabilities)的事务安全特性。
并发及最小锁粒度:MyISAM只支持表级锁,更新时会锁住整张表,导致其它查询和更新都会被阻塞; InnoDB支持行级锁。
备份:InnoDB 支持在线热备份。
主键必需:MyISAM允许没有任何索引和主键的表存在;InnoDB如果没有设定主键或者非空唯一索引,就会自动生成一个6字节的主键(用户不可见),数据是主索引的一部分,辅助索引保存的是主索引的值。
表的具体行数:MyISAM保存了表的总行数,如果select count(*) from table;会直接取出出该值; InnoDB没有保存表的总行数,如果使用select count(*) from table;就会遍历整个表;但是在加了wehre条件后,MyISAM和InnoDB处理的方式都一样。
外键支持:MyISAM不支持外键;InnoDB支持外键。
崩溃恢复:MyISAM 崩溃后发生损坏的概率比 InnoDB 高很多,而且恢复的速度也更慢。
其它特性:MyISAM 支持压缩表和空间数据索引。
设计搜索引擎的思路
1、决定搜索引擎覆盖的内容范围,例如全网搜索、特定领域的垂直搜索(如学术、新闻、图片等)
2、制定爬取规则,包括种子URL的选择、深度与广度优先策略、遵守robots.txt协议等。
3、开发爬虫程序:编写代码实现自动访问网页、下载内容、跟踪链接并避免重复抓取。
4、内容提取:从下载的网页中提取有用信息,如标题、正文、链接、图片等。
5、数据清洗:去除无关字符、HTML标签,进行文本规范化(如转换为小写、分词)。
6、建立索引库:根据提取的信息创建倒排索引,将关键词映射到包含它们的文档。
7、查询处理:分析用户输入,执行关键词提取、同义词扩展、拼写纠错等。
8、检索算法:基于索引快速找出匹配文档。
推荐阅读
最后,最后,彩蛋来啦~~
🎆烟花智能助理 V1.0已经上线啦!
📚可以帮助我们高效创建个人专属知识库哦
💡想学的都可以交给烟花!搜索+总结+解析+答疑+召回 为我们一步服务到位哦。
使用手册(烟花添加二维码也在里面哦):
https://hqexj12b0g.feishu.cn/docx/KNfLdBpxOoYl9JxQg1AcNXosnwh
偷偷说一句:她已经在我微信聊天里置顶了,集实力与好听声音的女孩谁不爱。
另外想加入我们一支烟花AI社区学习交流群的加我微信,拉你入群一起学习交流~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

