百度二面,没想到草草结束了
即使不如意,但每一次的结束都是新开始的序章。
大家好,我是皇子。
近日,百度旗下的无人驾驶出行——萝卜快跑(Apollo Go)爆火,并于周三登上微博热搜。
今年三月份时,在《对话·开年说》——新探索 新奋斗节目中,我才第一次知道大佬李彦宏关于百度的萝卜快跑的这个项目,那时有500辆萝卜快跑的车还在大约300万人口规模的武汉市进行运营,也是当时全世界最大规模的商业化无人驾驶运营。
萝卜对应的是英文单词robot(机器人)的意思,有意思的是节目开头大佬直接把他们的这个车称为汽车机器人。
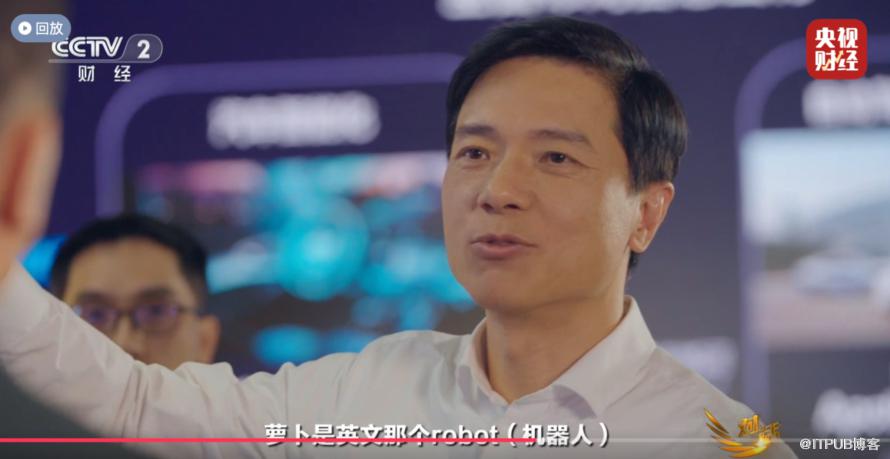
而实际上,萝卜快跑是百度旗下自动驾驶出行服务平台,在全国11个城市落地自动驾驶出行服务,在北京、上海、深圳、武汉4个城市开展了车内无人的示范运营。
昨日“萝卜快跑”冲上热搜!还带动百度股价大涨近10%。
武汉的商业模式成功有望异地复制,自动驾驶或将挑战出租车网约车行业,这也是当时特斯拉的一个蓝图,没想到百度竟然能领先一步了。
还别说,我都想买一辆萝卜快跑,上班负责接送我,平时负责挣钱养我。
好了,言归正传,我们今天来介绍一位百度国际化-Golang社招的面经。
这位同学一面还挺顺利的,主要问了他自己参与的一些项目情况,基本0八股。
但二面的八股时,草草结束了,应该会挂了。
我这里也稍微整理了一二面相关技术点,希望能帮到大家。
架构设计
分布式锁实现
1、数据库的唯一索引获得锁时向表中插入一条记录,释放锁时删除这条记录。唯一索引可以保证该记录只被插入一次,那么就可以用这个记录是否存在来判断是否处于锁定状态。
存在以下几个问题:
锁没有失效时间,解锁失败的话其它进程无法再获得该锁; 只能是非阻塞锁,插入失败直接就报错了,无法重试; 不可重入,已经获得锁的进程也必须重新获取锁。
2、Redis 的 SETNX 指令使用 SETNX(set if not exist)指令插入一个键值对,如果 Key 已经存在,那么会返回 False,否则插入成功并返回 True。
SETNX 指令和数据库的唯一索引类似,保证了只存在一个 Key 的键值对,那么可以用一个 Key 的键值对是否存在来判断是否存于锁定状态。
EXPIRE 指令可以为一个键值对设置一个过期时间,从而避免了数据库唯一索引实现方式中释放锁失败的问题。
3、Redis 的 RedLock 算法RedLock是一种基于Redis集群环境下的分布式锁实现方法,它通过多个Redis节点之间的协调来提高锁的可靠性和一致性。
RedLock算法通过随机性、一致性、故障恢复等机制确保在高可用性环境下也能正确地实现分布式锁
1)尝试从 N 个互相独立 Redis 实例获取锁;
2)计算获取锁消耗的时间,只有时间小于锁的过期时间,并且从大多数(N / 2 + 1)实例上获取了锁,才认为获取锁成功;如果获取锁失败,就到每个实例上释放锁。
这些方法各有优缺点,选择合适的实现方式需要根据实际应用场景和需求来决定。例如,对于简单场景,使用
SETNX + EXPIRE可能就足够了
负载均衡算法
集群中的应用服务器(节点)通常被设计成无状态,用户可以请求任何一个节点。
负载均衡器会根据集群中每个节点的负载情况,将用户请求转发到合适的节点上。
1、轮询(Round Robin):轮询算法把每个请求轮流发送到每个服务器上。
2、加权轮询(Weighted Round Robbin):加权轮询是在轮询的基础上,根据服务器的性能差异,为服务器赋予一定的权值,性能高的服务器分配更高的权值。
3、 最少连接(least Connections):由于每个请求的连接时间不一样,使用轮询或者加权轮询算法的话,可能会让一台服务器当前连接数过大,而另一台服务器的连接过小,造成负载不均衡。
4、加权最少连接(Weighted Least Connection):在最少连接的基础上,根据服务器的性能为每台服务器分配权重,再根据权重计算出每台服务器能处理的连接数。
5、随机算法(Random):把请求随机发送到服务器上。和轮询算法类似,该算法比较适合服务器性能差不多的场景。
6、源地址哈希法 (IP Hash):源地址哈希通过对客户端 IP 计算哈希值之后,再对服务器数量取模得到目标服务器的序号。可以保证同一 IP 的客户端的请求会转发到同一台服务器上,用来实现会话粘滞(Sticky Session)。
设计限流方案
在分布式系统和高并发场景下,需要我们对系统设计限流方案。
限流并不一定意味着系统负载能力不行,而是系统设计中的一种主动防护机制,用于确保系统在高并发场景下的稳定性和可靠性。
合理地实施限流与提高并发性并不冲突,反而可以相互促进:系统并发能力越强,限流阈值可以设置得更高,从而服务更多的合法请求。
所以在设计系统时,应将限流视为并发策略的一部分,而不是对立面。
合理的限流策略应当考虑以下几点:
动态调整阈值:根据系统状态和业务需求动态调整限流阈值,确保既能应对突发流量,又能充分利用系统资源。 分级限流:区分不同优先级或类型的请求,对高优先级请求放宽限流,对低优先级或可疑请求严格限流。 反馈机制:当请求被限流时,提供清晰的错误信息,帮助客户端理解情况并适当调整请求策略。
具体的方案包括:
1、确定限流的目标和策略:目标可以针对整个系统、某个API、某个用户、某个IP地址或是资源的类别进行限流;策略可以是固定速率(例如每分钟100次请求)、滑动窗口(过去一分钟内平均速率)、令牌桶算法、漏桶算法等。
2、选择限流算法:
令牌桶算法:允许突发请求,但长期来看不会超过设定的平均速率。适用于需要突发处理能力的场景。 漏桶算法:平滑请求流,超出容量的请求会被丢弃。适用于不需要突发处理能力的场景。 滑动窗口算法:跟踪一段时间内的请求速率,可以更精确地控制瞬时流量。
3、容错与降级策略:当限流机制触发时,应有明确的错误处理流程,例如返回HTTP状态码429 Too Many Requests,或执行降级逻辑。
Golang
介绍GMP
G(Goroutine):我们所说的协程,为用户级的轻量级线程,每个 Goroutine 对象中的 sched 保存着其上下文信息。 M(Machine):对内核级线程的封装,数量对应真实的 CPU 数(真正干活的对象)。 P(Processor):即为 G 和 M 的调度对象,用来调度 G 和 M 之间的关联关系,其数量可通过 GOMAXPROCS()来设置,默认为核心数。
GMP调度流程
1、每个 P 有个局部队列,局部队列保存待执行的 goroutine(流程 2),当 M绑定的 P 的局部队列已经满了之后就会把 goroutine 放到全局队列(流程 2.1) 。
2、每个P 和一个M 绑定,M 是真正的执行 P 中 goroutine 的实体(流程 3),M从绑定的 P 中的局部队列获取G执行。
3、当 M 绑定的 P 的局部队列为空时,M 会从全局队列获取到本地队列来执行 G(流程 3.1),当从全局队列中没有获取到可执行的 G 时候,M 会从其他 P的局部队列中偷取(一半) G 来执行(流程 3.2),这种从其他 P 偷的方式称为**work stealing**。
4、当 G 因系统调用(syscall)阻塞时会阻塞 M,此时 P 会和 M 解绑即 hand off,并寻找新的 idle(空闲) 的 M,若没有 idle 的 M 就会新建一个 M(流程 5.1) 。
5、当 G 因 channel 或者 network I/O 阻塞时,不会阻塞 M,M 会寻找其他runnable 的 G;当阻塞的 G 恢复后会重新更新状态为 runnable 进入 P 队列等待执行(流程 5.3)。
算法
两数之和
给定一个整数数组 nums 和一个目标值 target,找出数组中和为目标值的那两个整数,并返回它们的数组下标。
题解:采用了哈希表的方法,时间复杂度为 O(n),空间复杂度也为 O(n)
package main

import (
    "fmt"
)

// twoSum 函数接收一个整数切片 nums 和一个目标整数 target,
// 返回两个整数的下标,这两个整数的和等于目标值。
func twoSum(nums []int, target int) []int {
    // 创建一个映射(map)来保存数值和其对应的下标
    numMap := make(map[int]int)

    // 遍历数组
    for i, num := range nums {
        // 计算目标值与当前数值的差
        complement := target - num

        // 如果差值存在于 map 中,说明找到了两个数
        if j, ok := numMap[complement]; ok {
            return []int{j, i}
        }

        // 将当前数值和其下标存入 map
        numMap[num] = i
    }

    // 如果没有找到满足条件的两个数,返回空 slice
    return []int{}
}

func main() {
    nums := []int{2, 7, 11, 15}
    target := 9
    result := twoSum(nums, target)
    fmt.Println(result) // 应该输出 [0, 1]
}
并发检验URL有效性
假如给 10 个 url,通过并发实现哪些 url 能通,最后一次性输出通的url和不通的url。
要求:go 实现,先写的输出的通的,然后让输出不通的,都要一次性输出。
package main

import (
	"fmt"
	"net/http"
	"sync"
	"time"
)

func checkURL(url string, wg *sync.WaitGroup, reachable, unreachable *sync.Map) {
	defer wg.Done()
	resp, err := http.Get(url)
	if err != nil || resp.StatusCode != 200 {
		unreachable.Store(url, struct{}{})
	} else {
		reachable.Store(url, struct{}{})
	}
}

func main() {
	urls := []string{
		"http://www.google.com",
		"http://www.example.com",
		"http://www.nonexistentwebsite9999.com",
		"http://www.github.com",
		"http://www.stackoverflow.com",
		"http://www.bing.com",
		"http://www.wikipedia.org",
		"http://www.yahoo.com",
		"http://www.cnblogs.com",
		"http://www.404error.com",
	}

	var wg sync.WaitGroup
	reachable := &sync.Map{}
	unreachable := &sync.Map{}

	for _, url := range urls {
		wg.Add(1)
		go checkURL(url, &wg, reachable, unreachable)
	}

	wg.Wait()

	fmt.Println("Reachable URLs:")
	reachable.Range(func(key, value interface{}) bool {
		fmt.Println(key)
		return true
	})

	fmt.Println("\nUnreachable URLs:")
	unreachable.Range(func(key, value interface{}) bool {
		fmt.Println(key)
		return true
	})
}
golang + Redis实现令牌桶限流
假设我们要在API入口处限制每个用户每分钟不超过100次请求,可以使用Redis的INCR和EXPIRE命令实现令牌桶算法。
// 检查用户是否可以发出请求
func canMakeRequest(rdb *redis.Client, userID string) bool {
    ctx := context.Background()
    // 构建key名
    key := fmt.Sprintf("rate_limit:%s", userID)
    // 尝试获取令牌(递增请求计数)
    currentValue, err := rdb.Incr(ctx, key).Result()
    if err != nil {
        fmt.Printf("Error incrementing rate limit: %v\n", err)
        return false
    }
    // 如果这是第一次请求,设置过期时间为1分钟
    if currentValue == 1 {
        err := rdb.Expire(ctx, key, time.Minute).Err()
        if err != nil {
            fmt.Printf("Error setting expire on rate limit: %v\n", err)
            return false
        }
    }
    // 如果超过限制,重置计数器
    if currentValue > 100 {
        _, err := rdb.Del(ctx, key).Result()
        if err != nil {
            fmt.Printf("Error deleting rate limit key: %v\n", err)
            return false
        }
        return false
    }
    return true
}
Redis
什么是缓存穿透问题?
先来看一个常见的缓存使用方式:读请求来了,先查下缓存,缓存有值命中,就直接返回;缓存没命中,就去查数据库,然后把数据库的值更新到缓存,再返回。
**缓存穿透:**指查询一个一定不存在的数据,由于缓存是不命中时需要从数据库查询,查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到数据库去查询,进而给数据库带来压力。
通俗点说,读请求访问时,缓存和数据库都没有某个值,这样就会导致每次对这个值的查询请求都会穿透到数据库,这就是缓存穿透。
缓存穿透一般都是这几种情况产生的
业务不合理的设计,比如大多数用户都没开守护,但是你的每个请求都去缓存,查询某个userid查询有没有守护。
业务/运维/开发失误的操作,比如缓存和数据库的数据都被误删除了。
黑客非法请求攻击,比如黑客故意捏造大量非法请求,以读取不存在的业务数据。
如何避免缓存穿透
一般有三种方法
1、如果是非法请求,我们在API入口,对参数进行校验,过滤非法值。
2、如果查询数据库为空,我们可以给缓存设置个空值,或者默认值。
但是如有有写请求进来的话,需要更新缓存,以保证缓存一致性,同时,最后给缓存设置适当的过期时间。(业务上比较常用,简单有效)
3、使用布隆过滤器快速判断数据是否存在。即一个查询请求过来时,先通过布隆过滤器判断值是否存在,存在才继续往下查。
简单来说,
布隆过滤器(BloomFilter)是一种数据结构。特点是存在性检测,如果布隆过滤器中不存在,那么实际数据一定不存在;如果布隆过滤器中存在,实际数据不一定存在。相比于传统数据结构(如:List、Set、Map等)来说,它更高效,占用空间更少。缺点是它对于存在的判断是具有概率性。
MySQL
索引失效的场景
在索引列上使用mysql的
内置函数,索引失效。对索引
列运算(如,+、-、*、/),索引失效。索引字段上使用(!= 或者 < >,not in)时,可能会导致索引失效。
索引字段上使用
is null, is not null,可能导致索引失效。字段为空是可以走索引的,但是部分场景可能会失效,字段尽量设置为非null然后设置默认值如果字段类型是字符串,where时一定用引号括起来,否则会因为
隐式类型转换,索引失效like通配符可能导致索引失效。
最左前缀不仅仅适用于组合索引,还适用于varchar的like语句,但是要注意,只有like "XXX%"的情况走索引,like "%XXX"和like "%XXX%"是不走索引的。查询条件包含
or或者in,可能导致索引失效。具体是由MySQL优化器内部决定是全表扫描还是索引查找,用效率较高的一种方式。联合索引,查询时的条件列不是联合索引中的
第一个列,索引失效。左连接查询或者右连接查询查询关联的
字段编码格式不一样,可能导致索引失效。MySQL优化器估计使用全表扫描要比使用索引快,则不使用索引:MySQL优化器内部就是找到一个索引扫描行数最少的方案去执行语句。那么扫描行数怎么来判断的?是逐行统计数据表的数据吗?其实并不是,而是根据统计信息来预估的值,这个统计信息就是我们常说的索引的“区分度”。
建议:在使用前最好还是先用 explain 来试试到底sql语句走不走索引,然后选择较优的sql。
一条SQL查询语句的执行顺序?
FROM:对FROM子句中的左表<left_table>和右表<right_table>执行笛卡儿积(Cartesianproduct),产生虚拟表VT1ON:对虚拟表VT1应用ON筛选,只有那些符合<join_condition>的行才被插入虚拟表VT2中JOIN:如果指定了OUTER JOIN(如LEFT OUTER JOIN、RIGHT OUTER JOIN),那么保留表中未匹配的行作为外部行添加到虚拟表VT2中,产生虚拟表VT3。如果FROM子句包含两个以上表,则对上一个连接生成的结果表VT3和下一个表重复执行步骤1)~步骤3),直到处理完所有的表为止WHERE:对虚拟表VT3应用WHERE过滤条件,只有符合<where_condition>的记录才被插入虚拟表VT4中GROUP BY:根据GROUP BY子句中的列,对VT4中的记录进行分组操作,产生VT5ROLLUP|CUBE:对表VT5进行CUBE或ROLLUP操作,产生表VT6(CUBE和ROLLUP是用于在GROUP BY语句中生成更复杂的分组统计的扩展功能,它们主要用于数据分析和报表生成场景,能够提供不同维度的汇总数据)HAVING:对虚拟表VT6应用HAVING过滤器,只有符合<having_condition>的记录才被插入虚拟表VT7中。SELECT:第二次执行SELECT操作,选择指定的列,插入到虚拟表VT8中DISTINCT:去除重复数据,产生虚拟表VT9ORDER BY:将虚拟表VT9中的记录按照<order_by_list>进行排序操作,产生虚拟表VT10LIMIT:取出指定行的记录,产生虚拟表VT11,并返回给查询用户
MySQL CPU负载打满如何处理
1、先确定占用CPU最高的查询:使用数据库的性能监控工具(如SHOW PROCESSLIST在MySQL中)查看当前运行的查询,找到那些占用CPU最多的查询。
2、终止相关查询:如果有长时间运行或特别耗CPU的查询,可以考虑终止它们。在MySQL中,可以使用KILL QUERY <process-id>。
3、关闭非关键后台查询任务:暂时禁用任何非关键的后台任务或批处理脚本,以减轻数据库的负担。
4、增加硬件资源:如果可能,临时增加资源,比如扩展虚拟机的CPU或内存。
当然,为避免这种情况再发生,我们日常开发要关注数据库查询性能,如:优化慢查询,添加必要的索引,可以考虑使用读写分离或负载均衡技术,避免单点过载等等。
以上,觉得有用点亮【赞与在看】让我们总能披荆斩棘,挑战自我。
推荐阅读
关于作者:一位热爱技术,并在职场与自媒体间探索的实践者,希望通过分享个人经验和见解,帮助更多人实现自我成长和价值。
如果您对我的公众号内容感兴趣,欢迎关注我。
也可以在下方添加我微信和一支烟花AI社区技术群,一起交流技术、职场心得。欢迎~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

