读不下去的,略读也是不错,美名曰“好读书,不求甚解;每有会意,便欣然忘食。”
大家好,我是皇子。
对于渴望深入理解AI的爱好者和研究者来说,阅读经典论文不仅是获取知识的途径,更能让我们产生新的思维方式。
历史文章分享过一次《Attention is All You Need》论文的精读,我也不是算法和机器学习的从业者,有很多不解,但是不影响我在后面学习大语言模型(LLM)相关技术时提供了理论基础。
《Attention is All You Need》这篇论文堪称经典一点不为过,早期的GPT、BERT、T5模型都是在此论文提供的Transformers框架上进行后续的模型设计和优化的。
所以今天,为大家推荐大模型推理经典论文速读版,看完感觉自己通透了,包含:Zero-shot(零样本提示)、Few-shot(少样本提示)、Retrieval-Augmented Generation (RAG检索增强)
在此之前,先分享一个想看中文翻译版原文的高效办法:
为了方便中文阅读:安装浏览器插件“沉浸式翻译(https://immersivetranslate.com)”,支持多种浏览器,多个翻译服务。
PDF翻译后样式不方便阅读,调整为HTM版本:将 arxiv PDF 论文原地址域名中的
x更换成5即变成可访问的HTML版本链接,然后就可以愉快的使用“沉浸式翻译”进行原文阅读了。例如:arxiv PDF 论文原地址:https://arxiv.org/pdf/1706.03762.pdf,替换后HTML版本的链接:https://ar5iv.org/pdf/1706.03762.pdf论文中看不懂的
公式/概念,对于不是搞算法的可以不用专研,毕竟没有算法功底和更详细的上下文有些很难读懂,google或者AI一下知道是干嘛的就够了(个人阅读习惯,大佬跳过~)。
Zero-shot(零样本提示)
论文名称:《Finetuned Language Models Are Zero-Shot Learners》
简单摘要:零样本提示
中文摘要:本文探讨了一种提高语言模型零样本学习能力的简单方法。我们表明,指令调整(在通过指令描述的数据集上微调语言模型)可以显著提高未见任务的零样本性能。
我们采用 137B 参数预训练语言模型,并在通过自然语言指令模板表达的 60 多个 NLP 数据集上对其进行指令调整。我们在前所未见的任务类型上评估了这个指令调整模型(我们称之为 FLAN)。FLAN 大大提高了其未修改版本的性能,并在我们评估的 25 个数据集中的 20 个数据集上超越了零样本 175B GPT-3。FLAN 在 ANLI、RTE、BoolQ、AI2-ARC、OpenbookQA 和 StoryCloze 上的表现甚至远远超过了少样本 GPT-3。消融研究表明,微调数据集的数量、模型规模和自然语言指令是指令调整成功的关键。
论文链接:https://arxiv.org/abs/2109.01652
关键研究::图1:顶部:指令调整和 FLAN 概述。指令调整针对以指令形式表达的混合任务对预训练语言模型进行微调。在推理时,我们会对一种未见过的任务类型进行评估;例如,当指令调整期间未看到 NLI 任务时,我们可以在自然语言推理 (NLI) 上评估模型。底部:零样本 FLAN 与零样本和少样本 GPT-3 相比,在三种未见过的任务类型上的表现,在我们评估的十种任务中,指令调整显著提高了性能。NLI 数据集:ANLI R1–R3、CB、RTE。阅读理解数据集:BoolQ、MultiRC、OBQA。封闭式 QA 数据集:ARC-easy、ARC-challenge、NQ、TriviaQA。
Few-shot(少样本提示)
论文名称:《Language Models are Few-Shot Learners》
简单摘要:少样本提示
中文摘要:最近的研究已经证明,通过在大量文本语料库上进行预训练,然后针对特定任务进行微调,
许多 NLP 任务和基准测试都取得了显著的进步。虽然这种方法在架构上通常与任务无关,但它仍然需要数千或数万个示例的特定于任务的微调数据集。
相比之下,人类通常可以仅根据几个示例或简单的指令执行一项新的语言任务——这是当前的 NLP 系统在很大程度上仍难以做到的。
在这里,我们展示了扩展语言模型可以大大提高与任务无关的少样本性能,有时甚至可以与之前最先进的微调方法相媲美。具体来说,我们训练了 GPT-3,这是一个具有 1750 亿个参数的自回归语言模型,比任何以前的非稀疏语言模型多 10 倍,并在少样本设置中测试其性能。对于所有任务,GPT-3 均无需任何梯度更新或微调即可应用,任务和少样本演示完全通过与模型的文本交互来指定。GPT-3 在许多 NLP 数据集上都表现出色,包括翻译、问答和完形填空任务,以及一些需要即时推理或领域适应的任务,例如解读单词、在句子中使用新词或执行三位数算术。同时,我们还确定了一些 GPT-3 的小样本学习仍然难以实现的数据集,以及一些 GPT-3 面临与大型网络语料库训练相关的方法问题的数据集。最后,我们发现 GPT-3 可以生成新闻文章样本,而人类评估者很难将这些样本与人类撰写的文章区分开来。我们讨论了这一发现以及 GPT-3 总体的更广泛的社会影响。
论文链接:https://arxiv.org/abs/2005.14165
关键研究:语言模型元学习。在无监督的预训练过程中,语言模型会开发出一系列技能和模式识别能力。然后,它会在推理时使用这些能力来快速适应或识别所需的任务。我们使用术语“上下文学习”来描述此过程的内部循环,该循环发生在每个序列的前向传递中。此图中的序列并非旨在代表模型在预训练期间将看到的数据,而是旨在表明有时单个序列中会嵌入重复的子任务。
Retrieval-Augmented Generation (RAG检索增强)
论文名称:《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》
简单摘要:结合资料库检索,让LLM变得更强、回答讯息更正确
中文摘要:大型预训练语言模型已证实在其参数中储存事实知识,并在微调后在下游自然语言处理任务中取得了最先进的成果。
然而它们访问和精确操作知识的能力仍然有限,在知识密集型任务上,它们的表现落后于特定任务架构。
此外为其决策提供出处讯息和更新其世界知识,仍是开放性的研究问题。虽然具有可微访问机制的预训练模型,能够使用明确的非参数化记忆,但到目前为止,这些模型仅用于探讨摘要性的下游任务。
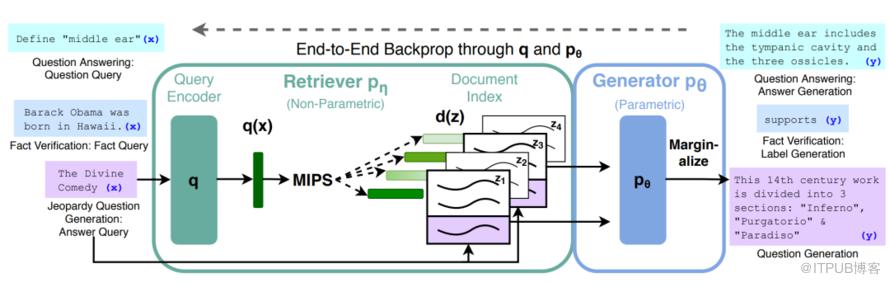
所以我们探索了一种用于检索增强生成(RAG)的通用微调方法— 这些模型结合了预训练的参数化和非参数化记忆以进行语言生成。
在RAG模型中,参数化记忆是一个预训练的seq2seq模型,而非参数化记忆是维基百科的密集向量索引,其通过预训练的神经检索器进行访问。另外我们比较了两种RAG形式,一种在整个生成序列中条件于相同的检索段落,另一种可以每个标注使用不同的段落。我们对一系列知识密集型自然语言处理任务进行了微调和评估,在三个开放领域的问答任务中取得了最先进的成果,优于参数化seq2seq模型和特定任务的检索和提取架构。对于语言生成任务,我们发现RAG模型生成的语言更加具体、多样且具有事实性,超过了最先进的仅参数化seq2seq基线。
链接论文:https://arxiv.org/pdf/2005.11401.pdf
关键研究:联合“预训练的检索器(查询编码器+文档索引)”+“预训练的seq2seq模型(生成器)”+“微调”端到端
以上,点亮【赞与在看】让我们心中充满力量、披荆斩棘、不惧未来。
推荐阅读
关于作者:一位热爱技术,并在职场与自媒体间探索的实践者,希望通过分享个人经验和见解,帮助更多人实现自我成长和价值。
如果您对我的公众号内容感兴趣,欢迎关注我。
也可以在下方添加我微信和一支烟花AI社区技术群,一起交流技术、职场心得。
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

