Rgb大神自从将卷积神经网络引入了目标检测领域后,一发不可收拾,从rcnn到fast-rcnn,然后到end-to-end的faster-rcnn,除了yolo一枝独秀外,基本垄断了整个目标检测领域;而何凯明的resnet基本成了整个图像分类算法的巅峰,后续的小修小补基本在resnet旁边晃悠。好了,这一次,强强联手准备狙击实例分割(instance segmentation)了。
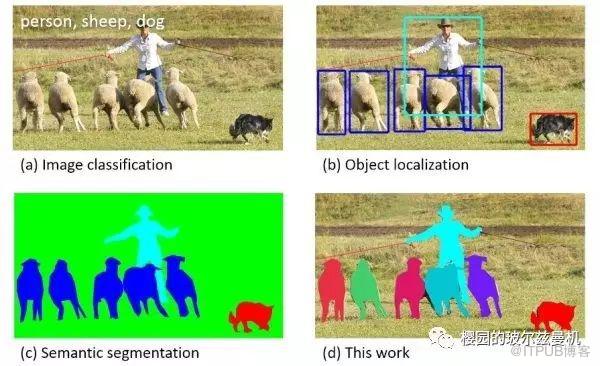
先谈谈什么是instance segmentation,大白话就是,一群人在图片里面,我希望把每个人都给我分割出来。分类只能做到识别这个图片是人;目标检测只能检测到这个图片里有人,把人的地方框出来,对每一个人这个个体不一样是没有判断的,统一认为是人;而图像分割主要是将人和背景分割出来,而实例分割就是要把每个人清晰的分割出来。
套用一张图片就是这个样子:
想想其实蛮难的。何凯明他们这次做的工作就是在faster-rcnn的基础上加了点东西,然后就可以做实例分割了。加了点啥呢,就是在已有的目标检测的框回归上,加了个分支,来做实例的预测。相当于有三个损失函数:1分类的损失函数;2框回归的损失函数;3实例预测(其实也是像素框的回归)的损失函数。画个图就是这样的:
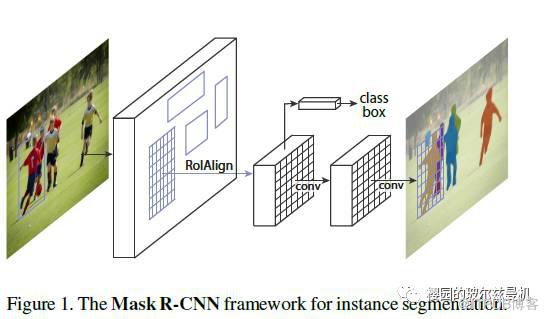
具体一点就是这样:
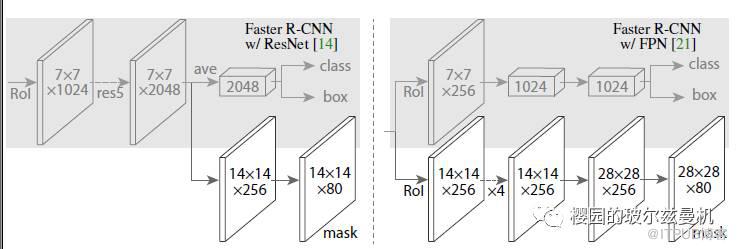
最精髓的东西好像上面一句话就讲完了。其实还是不够的。文中讲了三个loss如何在一起训练然后收敛的道理,推了公式的。微信上看公式也没什么印象,大家还是自己去原文细看吧。
文中其它的就是说这个方法的效果很好,在coco数据集上基本比2016年的冠军的成绩还要好,然后就是简单干净易使用,稍后还放上源码。最后讲了这个可以用来做人体的姿势估计。

这个跟这篇论文很像:Realtime Multi-Person 2D Pose Estimation using Part Affinity Fields
这篇文章是2016年MSCOCO关键点挑战赛以及2016年ECCV最佳演示奖,并发表在2017年CVPR的口头论文(Oral Paper)中。论文地址:https://arxiv.org/abs/1611.08050。也是搞姿态估计的。
本文的原文地址在这里:https://arxiv.org/pdf/1703.06870.pdf
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

