今天我们来把玩一下这篇文章:Deformable Convolutional Networks。这篇文章已经是旧文章了。我也早就看了别人写的summary。包括win叔的,写的很好。孔子说,温故而知新,今晚我特意看了原论文,一千个读者有一千个哈姆雷特,横看成岭侧成峰,剑走偏锋,我们谈点不一样的。
在这里顺带说一句:首席跟我未从谋面,但我请教问题他一直温和回答,我也很喜欢他直率的性格,觉得人很nice,算作是一种小回应。
然后,谈点外围的话,这篇文章都是微软亚研院的实习生写的,河流只有入江海才能奔腾不息,微软亚研院我觉得是大家都可以去尝试join啊。
我看文章喜欢用一句话来概括paper。今天的这篇论文我想用两句话来讲。
第一句:形象来说,有一位设计师修建草坪时首先没有铺石头路,让人们自由踩踏草坪,时间久了形成了许多泥路,然后设计师顺着这些泥路铺石头路,人们很自然走石头路不踩踏青草了。
前面的是比喻说法,文章通俗的说法就是,图片中的物体形状本来就是千奇百怪,方框型的卷积核,即使卷积多次反卷积回去仍然是方框,不能真实表达物体的形状,如果卷积核的形状是可以变化的,这样卷积后反卷积回去就可以形成一个物体真实的多边形,更贴切的表达物体形状,从而可以更好的进行像素分割和物体检测。
之前我跟哥们一起做目标检测的时候,就有这样两个问题,一是标注的时候只能是矩形框,事实上矩形框内有很多背景像素,哥们觉得用圆形或者椭圆形来标注较合适。但是椭圆形需要表达的参数比较多,中心点,长半轴短半轴,学习起来也很麻烦。就此作罢。第二个问题是标注的时候同一个物体在不同图片中标注的时候,手误会导致表的框有大有小,就是大的框背景比较多,小的框可能框中满满的都是object,结果训练好模型测试的时候发现同一个物体出现了大小两个框。。。
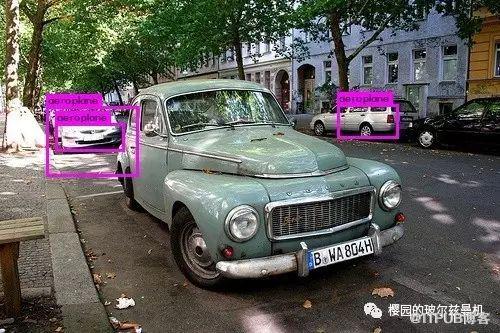
比如这张图片中左边出现一架大灰机两个框来预测(汽车而已)。
好了,一些外围的思考讲完了。我们来直捣黄龙。
一、这篇文章思想来源于空间可变的卷积网络。M. Jaderberg, K. Simonyan, A. Zisserman, and K. Kavukcuoglu. Spatialtransformer networks. In NIPS, 2015。不过他做的更好,可以在已有的cnn加点东西就实现端到端快速的训练。他的代码稍后会放出来。
二、文章提出了可变卷积和可变ROI采样。原理是一样的,就是在这些卷积或者ROI采样层上,添加了位移变量,这个变量根据数据的情况学习,偏移后,相当于卷积核每个方块可伸缩的变化,从而改变了感受野的范围,感受野成了一个多边形。
三、加的这个偏移量怎么学习训练的。这里来谈点公式。

公式一是正常的卷积计算公式,公式2是添加了偏移后的公式,然后对这个公式做线性插值变化就成了3,3的左边是原始图的位置,x(q)是卷积后的特征图,G就是需要学习的变换核。这样就可以求偏导进行梯度下降学习了。4就是这个需要学习的核的表示。
四、我们来解说图。
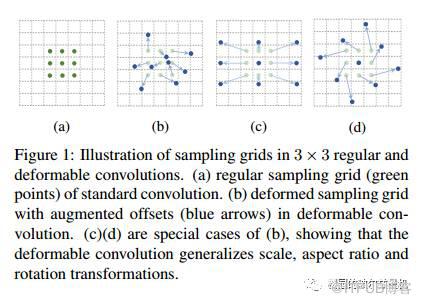
这张图说的是,规规矩矩的卷积核,加入偏移变量后,想怎么变就怎么变。具有更丰富的表达能力。
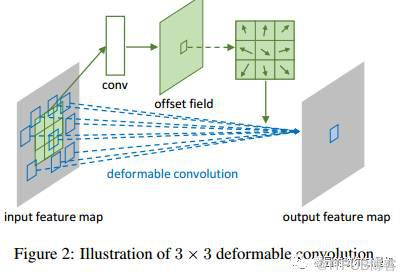
这个图的意思是,添加进的偏移变量加上2维的卷积变化,相当于三维变化了。一个可变形的卷积map反射回去是一些稀疏的小块了。
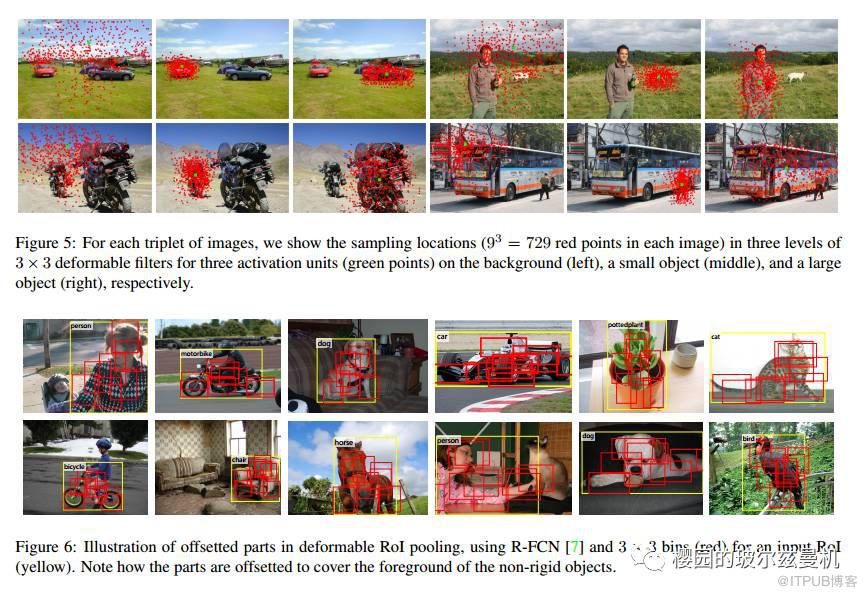
这个图上一张是可变卷积的。一些随机的稀疏红点,通过可变卷积核转换,可以表达小物体或大物体。
下一张是可变ROI采样的,可以在一个框中更细分的分出前景和背景,前景都用一些红框框出来了,这样可以解决我开头提到的问题。
五、文章用的网络叫做Aligned-Inception-ResNet,结合了Inception 和ResNet。应该很有趣。
最后,这篇文章有没有可以优化的地方。有。欢迎关注公众号,我们一起玩花招。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

