众多中国败家娘们的马爸爸前些日子在人工智能峰会上说:“去年大家把AlphaGo捧得天花乱坠,我听到这个消息就想,So TM What!”确实霸气。好了,今早刚看了阿里大神们待投NIPS的论文Multiagent Bidirectionally-Coordinated Nets for Learning to Play StarCraft Combat Games要用AI攻占星际争霸了。论文地址在这里:https://arxiv.org/pdf/1703.10069.pdf。
里面的策略网络和激励函数的公式我没有来得及细敲。我看论文喜欢一句话概括一下,那这篇文章我的总结就是:每一个作战单位是一个智能体,他的行为的激励有两方面--自身的激励和团队的激励,如果说前进对自身没有好处,但作为团队的一员,它的位置是最适合吸引火力,那激励函数给他的信号就是激励,从而它会前进。同时,团队协同作战时的激励函数又根据分组来分发,每个小组相当于一个集体作战单元。论文里的话就是:引入的双向协调网络(BiCNet)由策略网络(actor)和Q值网络(critic)组成,两者均基于双向RNN。策略网络用于独立智能体做出行动决策。因此,独立智能体能够保持自己的内部状态,同时能够与其他合作者共享信息。双向递归机制不仅是智能体之间的交流手段,而且还作为本地记忆状态。研究者进一步加强了actor的分组概念,这在社会行为中起着重要的作用。作为输入,我们允许少量的智能体程序在进入递归层之前构建局部相关性。因此,该模型的表现要好得多。在实验中,我们发现基于分组的actor有助于学习社会活动,如集中火力攻击。 Q值网络将策略网络的状态和行为作为输入,向每个独立智能体返回估算的本地Q值。然后组合本地Q值,提供全局回报的估计值。
先上几张效果图:
四个AI的小智能体和两个敌方单位对战的时候。
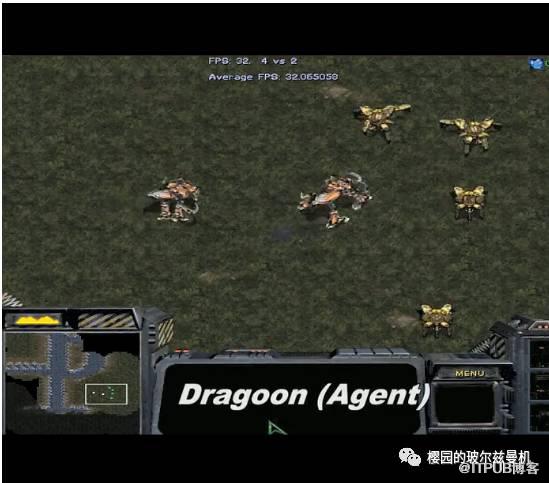
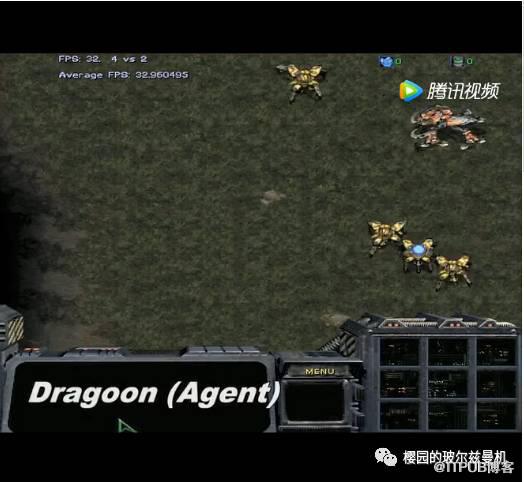
一个小智能体根据全局激励函数的约束,成功吸引火力让敌方追着自己跑,然后成了神一样的队友。小伙伴们可以开心的追着敌方单位的打了
还有一个案例是一堆火枪手排成一排不断前进或后退攻击对手的案例。
大概情况讲完了。谈几点自己的感受:
1、我也玩过冰封王座,电脑的微操本来就比人好,因为人需要敲击键盘和鼠标来操作作战体嘛。人打败电脑主要不在微操而在于战略规划和意识流。之前玩暗夜精灵的moon我觉得就是意识流高手。
2、我也看了电脑自带的疯狂难度的微操,应该没有这么炫。给大神们点一个赞,说明AI攻占星际争霸,已经开始撕开了一道口子了。
3、文章说这个比下围棋难,我的理解是:这个虽然要解决多个作战体协同作战的问题,他问题广度要广,但蒙特卡洛搜索树的深度应该比不上围棋的。
4、这些微操的实战学习资料肯定不是人操作的对战,人操作没有那么精准的,问了下论文的首作者,他也说全部是根据增强学习学到的。(ps增强学习就是两个智能机器对战,不断自学习更多的策略)。
5、Deepmind也在着手玩坏星际争霸比赛,不知道研究的是啥。
6、不管怎样,给大神们一个大大的赞。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

