腾讯AI lab CVPR paper把玩:cosFace、ArcFace--additive margin softmax
最近准备正儿八经的搞点事,琢磨着也发点paper,经常action,接地气的解决实际问题,别人还以为我是deeplearning的民间玩家。
正好腾讯AI lab刚发了波CVPR,找了找发现有一篇我觉得好玩的。结果一看,发现跟我之前看的文章类似,顺藤摸瓜,我发现3篇文章其实讲的都是一回事情。
1、cosFace:Large Margin cosine loss for deep face recognition (tencent AI lab) 1月29
2、ArcFace: additive angular margin loss for deep face recognition (deepInsight) 1月23
3、additive margin softmax for face verification (happynear) 1月18
不过腾讯发文章的时候特意说了,他们的文章17年就出来给同行看了。刷榜的结果也是17年提交的。
昨天跟第三篇的小哥凌晨扯了好久,这小哥是个等着毕业,期待博士期间发篇CVPR的博士。So,这个idea是不可能再中CVPR了。。。
论文原地址自己查一下吧。翻译的活我也不干了。
先说说为啥这3篇文章是一回事呢,本质上的工作就是loss函数的变化。
1、cos θ1 -m = cos θ2
2、Cos(θ +m)
3、Cos θ - m
第二篇文章号称比第3篇文章刷榜的效果好,估计是因为他在网络结构上花了点花招吧。按损失函数来说,应该是一回事。你想,2是改变角度的大小,改变角度大小的本质不就是改变cos函数值的大小吗?跟在外面加个常量改变函数值的大小本质是一样的。
前面这些话算是个引子,总起了一下。接下来以第1篇为例,讲讲 他们所谓的 cos θ +m
是怎么回事。我发现腾讯AI lab写的文章是这个三篇里面最清晰的,条理分明,一点即透。个人看法,讲真我也是昨天才刚开始看这玩意。
先说清楚,我的文章不能代替你看原论文,我的文章相当于是论文讨论会,大家看过论文后,一起反刍讨论而已。也许看了我的文章会给你一些启发,可以让你一些思路连成片,当然,如果写错了就帮我纠正。
深度学习界从开始到现在,所有的论文基本就干了两件事情,一、发现一个牛逼的网络结构,提高了网络的表达能力;二、发现了一个好玩的损失函数,提升了模型的鲁棒性和精度。人脸识别的优化方向就两个,一是不断增大不同人之间的距离,二是不断降低一个人不同人脸照片之间的距离。 center loss 和 tripleloss都是干这个事情。但他们损失函数的根基还是softmax的交叉熵,现在,这三篇文章琢磨的是把这个根基变一变,从而扩大分类面之间的margin。这样就自然达到了上面两个方向的目的了。是不是?

直观的看图说话,就是论文里的这张图了。LMCL的全称是 large margin cosine loss。
那么他这个增大分类面之间的margin是怎么做到的呢?
首先,交叉熵的损失是长这样的:
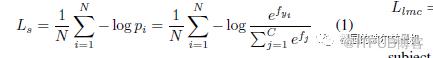
其中,fj是卷积网络最后一层的feature map和 权值向量的点乘。
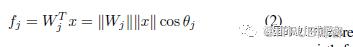
然后,他通过L2范数正则化,把 ||Wj||固定为1,把权值 ||x||固定为s。这下整个损失函数的唯一变量是这个角度 θ了。然后他就给他加个margin,(文章中试了试,这个超参数0.35比较理想,但跟分类个数相关,太大了不收敛,太小了没感觉)这样就让不同人的图片经过卷积后的特征分得更开了。
预测的时候,提得的特征,他也用余弦距离来做判断,提升精度。
整个算法的核心在这里:
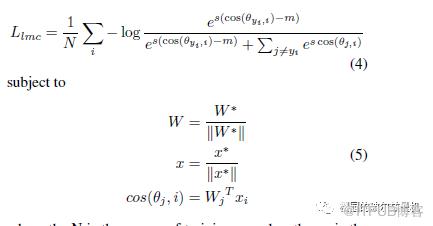
第一个式子就是加了m(margin)后,交叉熵展开的式子,后面的就是前面讲的一些条件,用初中数学的语言说法就是 令 。最后一行应该是公式编辑器编辑的不对,就是 i和 j直接的θ,cos(θi,j),i和j是平行对等的。
这篇文章的东西就讲完了,文章后面讲的是超参数怎么选,跟其他loss的对比,以及一些实验结果图。
好长一段时间没写文章了,朋友都问我啥时候更新公众号,就写篇给大家玩玩吧。
学而不思则罔,思而不学则殆。
多看Paper,勤敲代码。只看paper不动手就会飘在表面,只写代码不看paper就会思路窄。
写这篇文章,算是给大家提供宽的思路,推荐一下我琢磨过的paper吧。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

