文章有些长,建议收藏后慢慢看。
细粒度图像分类仍然是一个可以出文章的课题。做这个方向的人,我觉得可以好好琢磨注意力机制。注意力机制的本质跟人眼的工作原理是相近的,因而可以让机器更智能。
做学问我对自己的要求是,做小做精做透,大大说,一物不知深以为耻,是为大伙该有的座右铭乎。
学习就是一个建立知识树的过程。网上有很多文章都只是树身上树干上的一个小枝干,所以不能给你建立一个完整的知识体系树。
今天我这篇文章也只是一个小枝干。
我力争让大家能够窥一斑而知全豹。
Faster-rcnn和RA-CNN两篇文章都是在注意力机制上做文章,前一篇是监督式的,后一篇是半监督的。我觉得半监督学习是一个很有意思的事情。
后一篇篇文章的地址在这里:
论文:Look Closer to See Better: Recurrent Attention Convolutional Neural Network for Fine-grained Image Recognition
论文链接:http://openaccess.thecvf.com/content_cvpr_2017/papers/Fu_Look_Closer_to_CVPR_2017_paper.pdf
(1) Faster-rcnn中的RPN。
温故而知新。我还是希望深入浅出的给大家拎一下faster-rcnn的知识脉络。
1、输入与输出。输入是规整化1000*600的图片+标注的框,这个规格是参数,你自己可以指定。指定完后,输入的框的坐标自然做放大或缩小。同时把这个扩大缩小的比例记录下来。在输入的DATA层参数im_info里。算法的输出是目标框坐标和框中的物体名称。
2、RPN的功能。RPN就是根据注意力机制生成候选框的。要讲清楚这个里面的机制,得讲明白两个核心概念:anchor和ROIpooling。
Anchor:经常有人在微信上问我这个究竟是个什么东西,这里我统一白话文似的给大家讲明白。
一张图片经过VGG或者其他什么网络,得到特征图后,这个特征图可能是50*30*512。这个50*30,你可以认为是原图片缩小了20倍,因而这个512维的向量代表的就是原图中20*20这么大小的感受野。
这个特征图后面再接卷积层,一个分支得到的是50*30*(2*9),一个分支得到的是50*30*(4*9),其中9是框的种类个数,2是前景和背景的概率,4是框的坐标。
Anchor机制就是说,他默认你这个2*9这些参数,比如说50*30*18的第一个18,代表的是原图,0-20*0-20这个像素块上的box,前景和后景的概率值。这个像素块的box怎么生成的,你可以看lib/rpn/generate_anchors.py是怎么生成的。
这里有一张图,讲了anchor的生成box问题,他这个图三个尺寸,长宽比分别是1:1,1:2,2:1,这个图这些小框事实上他们的中心坐标应该是重叠的。
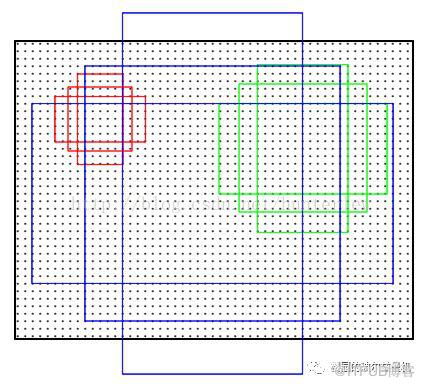
ROIPooling:根据Anchor机制生成的候选框,只要跟原图中的一些框重合大于0.7,就留了下来。这些框大大小小参差不齐,当然会做一些去重处理,这些大大小小的框,通过ROIpooling后,统一规划成了7*7的大小,比如说一个框是100*100,那么他就应该是14*14的小图,pooling成一个值。框数相当于是特征图的batch_size了。应该没有讲错,所以,训练faster-rcnn的时候,输入的原始图片一般都是1张,因为这个时候生成的框已经有很多个了。如果放2张,生成框就有可能爆显存。
ROIpooling出来的值,拿去做分类和回归loss学习。
这就是整个RPN的全貌了。
(2) RA-CNN中的APN。
1、输入和输出。输入是一张图片,规整为了224*224,输出是图片所属类别的标签。
2、APN的功能。APN的输入是没有目标的框的,他输入的就是一张图片,然后经过一个VGG(或者别的网络)后,得到的feature map,比如说14*14*256,然后接一个全连接层,变成1*1*1024,然后再接一个全连接层,变成1*1*3。3是正方形的坐标,包括左上角的xy,以及框长l。然后把这个框再放大为224*224后,送入级联网络的下一层。放大的时候是用多线性插值的,这样得到的图更细致。
APN训练的时候,他每次只生成了一个注意力框,没有很多个,因此训练的批你可以设置大一些。
APN说白了就是两个全连接层让你来学正方形的大小。整个机理是怎么样的,请看我前一篇文章:
更进一步,我联系上了文章的作者郑博,他说他们训练的时候操作的粒度不是在批上,而是通过设置学习率来达到交替训练的,一段时间内,APN层的学习率为0,训练VGG分类网络;一段时间内,VGG分类网络的学习率为0,训练APN层。

话说,大伙对注意力机制感觉更深了没有。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

