多看paper,勤敲代码。今天给大家分享一下23年2月17号挂出来的这个paper:Multimodal Chain-of-Thought
Reasoning in Language Models[1] 及代码[2]。
我也是看了机器之心这个报道才决定摸摸这个的。他这个标题有些夸张不符实际。事实上它这个论文只是在COT上构建了一个多模态打败了GPT3.5的单模态;注意:只是COT这一个点:并且也只是一个小数据集。他这样一些吸引眼球以为这个小模型可以完全替代chatgpt是不对的。这次分享,要给大家讲清楚三件事情:一、如何构建一个数据集训练COT模型,二、两阶段训练COT;二、单模态与多模态COT是怎么实现的;论文只是代码思维的文字化,总归是有gap的。很多细节还得看代码跑代码敲代码摸一遍。你对问题的理解是完全不一样的。我也是昨天晚上把这个项目搞明白的。一、训练COT的数据集长相
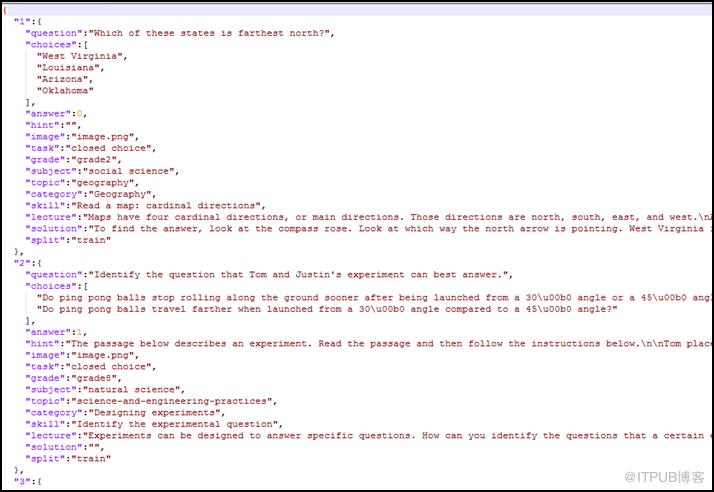
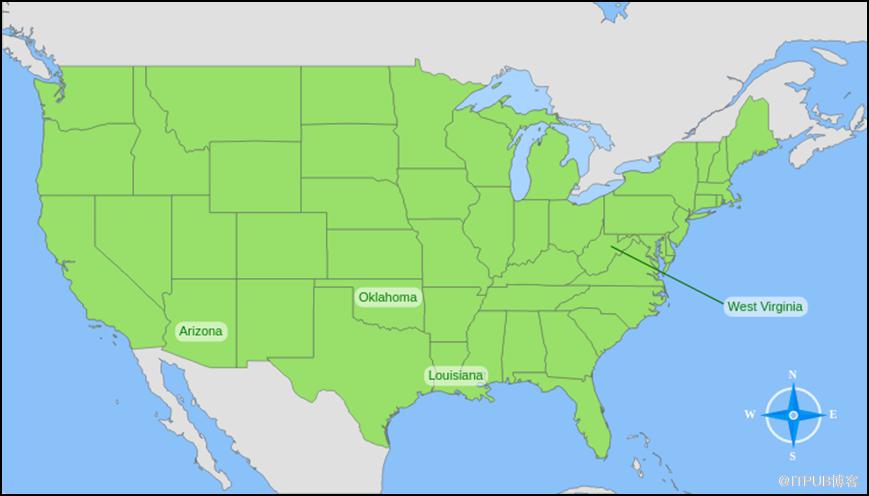
整个训练数据就是这样的。其中,pid_splits.json是做训练测试集划分的。Train数据集中的是图片。每个ID一张图片。Problems.json就是每个问题的定义和答案,以及COT的内容。我们先看问题内容:第一个问题讲的是哪个州在最北边?然后,其中有solution和lecture来做解说,但他们都不是cot,cot是hint这一栏。第一个题目是没有cot的,第二题就有,他给你了提示。不过他在代码里构建prompt的时候把solution和lecture都加进去了。我们来看图片,你一看就明白为啥多模态的效果这么好了。问题对应的图片就是四个州在图片中有具体位置的。明眼人一看就知道是哪个州在最北方,还带了指南针说明的。因此你就理解了为啥这么小的模型能比GPT3.5好。因为他增加了图片这个更大信息熵的通道。二、两阶段训练COT
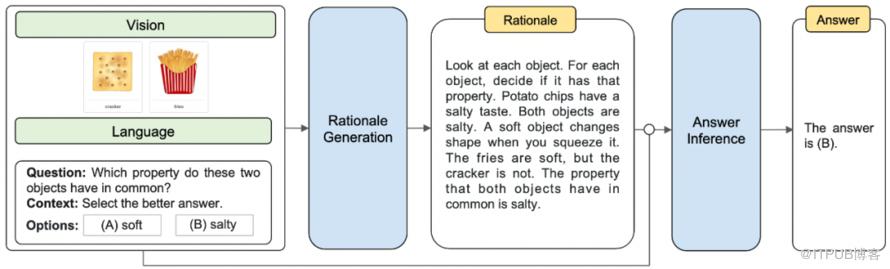
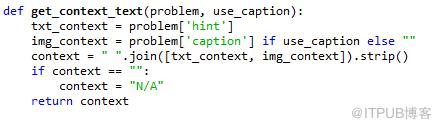
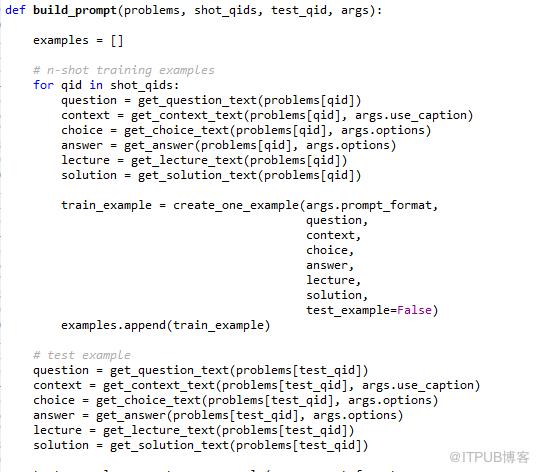
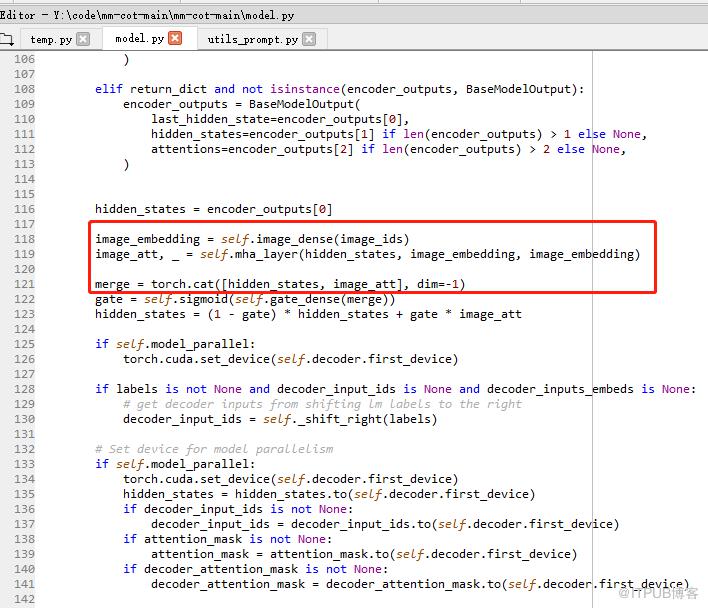
这一块就是完全印证了我之前对COT的定义:先学一个条件概率P(思维链|input),然后学一个条件概率 P(answer|思维链)。这个论文中说分两步效果更好,根就在这里。我本来也是想从这入手发论文的,因为我觉得分两步做条件概率更好,没想到已经有人发表了。见上次分析:Chatgpt内核情景二:真正的思维CoT与prompt训练的checkpoint长这样,其中的pytorch_model.bin不是训练的结果,而是一个文本特征提取器。预测时,第一步生成这样的中间结果:第二步拿着这样的中间结果去生产真正的answer。论文核心架构图就是专门讲这个逻辑的。他一开始生成了一个逻辑推理中间结果,然后再预测答案。先说单模,他首先读取problem.json里的信息,然后把他们连在一起,接着用文本特征提取器构建成prompt。所谓的多模态COT,他用resnet提取了图片特征,并增加了一个注意力机制层进去了,然后做了一个torch cat,把图像特征和文本prompt结合到一起。核心代码在红框里:滴水穿石,先把一些学术界的关于chatgpt的散状的点都囊起来,然后把他们连成线。 通过这次实践,基本搞清楚了COT的训练过程包括多模态的COT,对两次条件概率的理解更深了。同时也是第一次训练cot模型,发现把batch调小一点,我的rtx titan 24G 还是够用的。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。