最近又耽搁了不少。Opensora都开始写代码了。我看了下。他们还一直在更新。我还在盘逻辑中。不过也没事,先想明白再写代码。CVPR 2024 关于视频生成这个topic的文章就有200多篇。我简单过了一遍,主要聚焦在5个方面。这五个方面也是视频生成的核心技术壁垒:1、视频动作理解。我看有一篇文章是做了一个视频理解数据集。2、视频语义对应。视频中一连串帧要讲一个故事。3、视频生成pipeline优化。例如先生成骨架画面,再生产具有语义的动作。4、视频时空编码。如何将视频编码好目前还是一个课题。5、text语义映射到video语义、video生产新video需要视频语义到新的视频语义。这些映射关系的优化。其他一些新模型的也有。这一块没有细看。选了几篇文章供大家看。1、deepmind的。
Video Interpolation with Diffusion Models
Siddhant Jain (Google Research) · Daniel Watson (Google DeepMind) · Aleksander Holynski (UC Berkeley & Google Research) · Eric Tabellion (Google) · Ben Poole (Google) · Janne Kontkanen (Research, Google)
2、字节的像素跳跃。
Make Pixels Dance: High-Dynamic Video Generation
Yan Zeng (ByteDance) · Guoqiang Wei (ByteDance) · Jiani Zheng (None) · Jiaxin Zou (ByteDance Ltd.) · Yang Wei (East China Normal University) · Yuchen Zhang ( ByteDance Research) · Hang Li (ByteDance Technology)
3、这个是北大的。讲多模态语义模型对长视频语义理解的。
TimeChat: A Time-sensitive Multimodal Large Language Model for Long Video Understanding
Shuhuai Ren (None) · Linli Yao (Peking University) · Shicheng Li (Peking University) · Xu Sun (Peking University) · Lu Hou (Huawei Technologies Ltd.)
4、对视频时空编码构建开放的字典表(codebook)。
Towards Open-Vocabulary Spatio-Temporal Video Grounding
Syed Talal Wasim (None) · Muzammal Naseer (MBZUAI) · Salman Khan (Mohamed bin Zayed University of Artificial Intelligence) · Ming-Hsuan Yang (University of California at Merced) · Fahad Shahbaz Khan (Inception Institute of Artificial Intelligence)
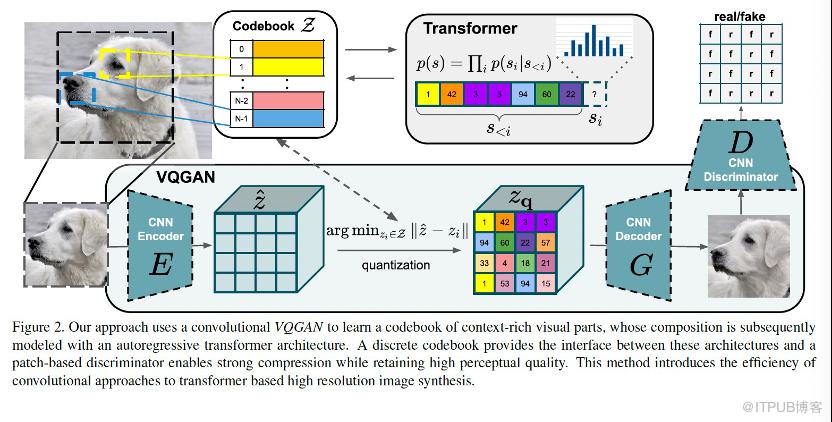
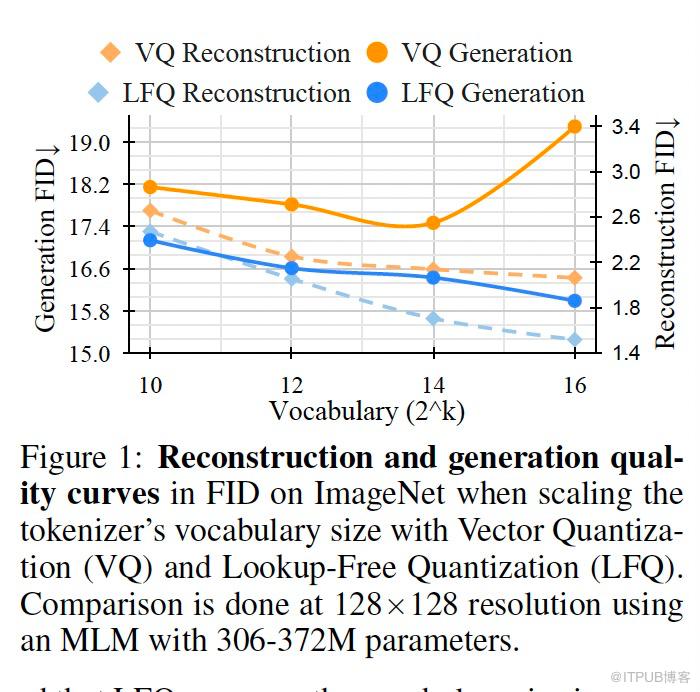
言归正传。最近我也是下了些力气才完整把codebook和LFW(lookup free Quantization)[1] 搞明白。我们前面几节讲过,图像变成token的过程是有一个codebook,然后根据这个codebook(类似查找字典)将连续特征图离散化为code。后面,谷歌的MAGVIT-v2 又发明了一个新算法,不需要在codebook里面查最近特征,直接可以离散化为code,发现视频生成的效果大增。我们得深入理解里面的逻辑,才能明白MAGVIT-v2 真正内涵。我们再来看这个图。来详细讲解codebook Z是怎么来的。有时候论文不是程序员沟通的语言。写的太绕了。仔细看了代码才搞明白。1、CNN encoder就是一个imagenet分类网络特征提取器。大家回顾下,imagenet的标准分类网络不是有很多中间层可以当特征提取器么。就是这个。例如你取了一个中间层256 *20*20。那么一张图片就可以得到一个256*400的矩阵。256是通道数,400是 Z的特征维度。然后,Z的个数目前VQ-GAN论文里面取的是1024个,因此,这时,你需要sample抽样一些图片,然后都生成这样的256*400的矩阵后,将这些向量求一个kmeans聚类(具体算法可以更优,方便理解直接写kmeans)中心,聚类中心的个数是1024个。就得到了初始化的codebook Z。接下来讲训练过程中是如何update codebook的。上图中有一个公式:arg min || codebook里面的 字典Z – 特征编码器输出的特征Z^|| ,来训练codebook Z。他的意思就是,后面,我们还会见到很多新的图片,然后,如果新图片输出的特征图 去codebook里找最近邻的Zi,发现距离还很远,就将它加入codebook,从codebook中找两个最相近的Zj 和Zk,移除一个。保证这个1024个Z 是最具有代表性的。二、MAGVIT-v2 核心改进LFQ(lookup free Quantization)真正内涵我们通过上面的分析,很自然就知道,这个codebook Z的个数是图像生成的瓶颈。类似于tokenizer的分词器分出的维度。如果是中文+英文+符号一起都有好几十万维。即使图像的token是抽象的高维特征,但1024个仍然不够用。越大当然表达能力更强咯。MAGVIT-v2 中,做了一个实验,如图橙色所示,发现codebook 的size越大,例如词汇表大小到2^16次分=65536时,VQ的生成器效果反而变差(FID值变大)。这个其实也很好理解,词汇表变大后,最近邻搜索就变麻烦,字典变大会导致训练不够充分,从而导致生成图片的时候效果变差。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。