承接上文。
上次讲的还都是一些外围的东西。这一次讲算法的内核。
目前对video synthesis 基本全搞明白了。Sora 也就是在当下业界最前沿做出了一个迭代吧。不过我看的学术届的东西已经是24年发表的论文,发表的paper都是半年前的工作,因此当下最热的玩法还不太清楚。
搞明白一个算法,其实只有三件事情,1、训练任务,即loss函数长什么样。2、输入的数据是什么,输出的数据什么。3、中间转换过程的模型结构。就这么回事。抓住这个主线就抓住了全部算法内核。
文末有福利。莫错过!
一、训练任务
Videopoet 预训练任务有 文本到视频(T2V),文本到图片(T2I),还有四个自监督学习任务:预测下一帧,从中心内扩,从中心外扩(即一张图片mask 调四周的像素,给中间100个像素(概数),预测中心外围四周的所有像素)。音频视频续接(Audio-Video Continuation,简称AVCont)是一种多媒体生成任务,其中模型被提供一段视频的第一帧以及相应的音频,目标是预测接下来的连续16帧视频帧及其匹配的音频。这个任务要求模型能够理解并模拟视频中的空间内容和时间动态,同时还要处理与视频内容同步的音频信息。他对各个任务做了数据均衡处理。
除预训练外,总体训练任务包括:文本到图像(text-to-image)、文本到视频(text-to-video)、图像到视频(image-to-video)以及视频到视频(video-to-video)任务——涵盖外围绘制(outpainting)、修复(inpainting)、风格化(stylization)和未来帧预测(future frame prediction),以及视频到音频(video-to-audio)、音频到视频(audio-to-video)、无条件图像(unconditioned image)和无条件视频(unconditioned video)生成。我们针对两个任务——文本到图像和文本到视频——进行微调,以进行文本到视频评估,以及使用视频到音频任务来生成一些带有匹配音频的视频示例。
二、输入与输出
输入的数据集是1B 的image-text 对和270M的videos,其中包括 100M的 video with text对。没有text的视频就做video 2video训练或者其他预训练任务。
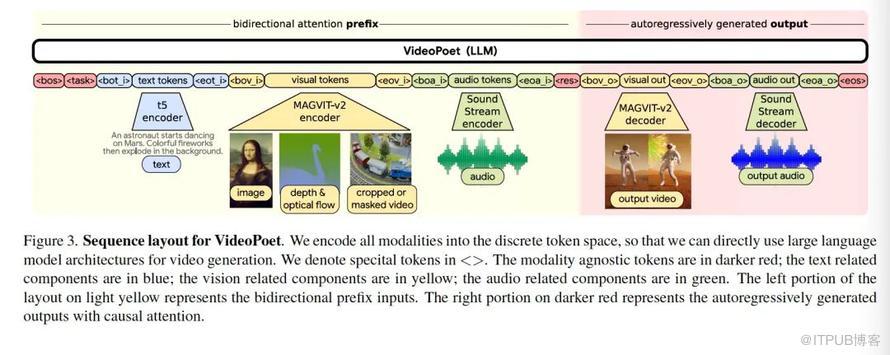
如图所示,左边浅黄色的是输入,右边浅红色的是输出。
输入:1)视觉的token,音频的token基于一个统一cookbook编码成一个token list。整个token list词表如下:前256个 词表用于特殊token和任务prompt编码,接下来的262144个词表用于图片和视频的token,然后是4096个音频的词汇表。文本的token不在这个里面,因为他没有输出的任务。输入的text通过谷歌的T5 大语言模型提取特征后编码为embedding备用。视频的编码器是 magvit-v2,音频的编码器是SoundStream 编码器。
输出:预测整个词汇表空间266496个token的概率值。然后通过解码器将预测出的token解码到像素空间或音频空间。解码出来的还是低清视频,他通过高清算法模型模块将低清视频转换成高清视频。
三、模型
他的mask token 预测网络是一个只有解码器的标准化 大语言模型的transformer结构。他的低分辨率生成高分辨率的transformer结构有优化。
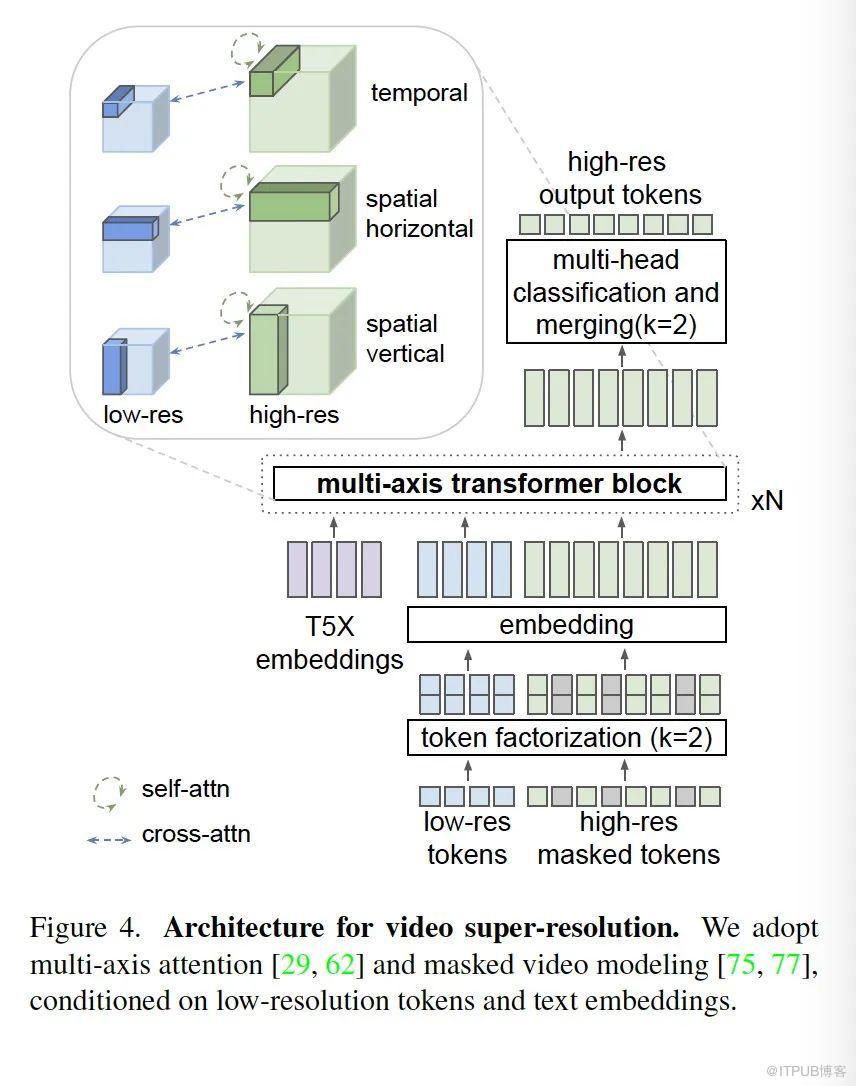
如图所示,从下往上看。他输入有两个:低分辨率的tokens(MAGVIT2生成的),高分辨率的masked的 tokens。然后生成embedding后,加上text的T5 模型生成的embedding,输入到多坐标轴的transformer block中。这个block预测出全部的 高清tokens。多坐标轴其实就三个,分别是时间轴,水平空间自注意力轴,垂直空间自注意力轴。
架子搭好就可以训练了。整个训练有两个部分。主干部分过程其实是这样的:先用编码器将视频、图片、音频编码成tokens,然后将文体例如T5模型编码成embedding,接着过一个大语言模型架构的transformer,预测出tokens,然后将这个预测出来的tokens解码成video和音频audio。
第二部分是高清视频预测。
他原始视频下采样为低清视频,转换成tokens,然后加上原始视频text和mask tokens,目标输出是原始视频的tokens。推理的时候,是低清视频的tokens和text,输出高清视频。
视频生成的整个过程就是这样的。这个是videopoet,sora 的过程在于训练任务不一样,他是一个diffusion 的denoise的任务。
题外话:
手上最近有一批4090 技嘉涡轮卡。包含发票价格大概1万7千块。不是 4090D,是原版的技嘉服务器级别涡轮卡。如果是自己用的话,还有一种4090定制卡。性价比超高。欢迎大家联系采购。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

