这个是ICLR2024 的paper with code。LanguageBind: Extending Video-Language Pretraining to N-Modality by Language-based Semantic Alignmenthttps://github.com/PKU-YuanGroup/LanguageBind这是北大和腾讯一起搞的工作。后来我细盘了下,发现这个课题组PKU-YUAN-Lab (袁粒课题组-北大信工)的工作值得认真关注。他们在cvpr2024还发了一个多模态对齐的工作叫做Chat-UniVi: Unified Visual Representation Empowers Large Language Modelswith Image and Video Understanding然后,我下午才发现这个课题组也是目前在做open-sora的那帮人。并且袁粒非常年轻。17年本科毕业,未来可期。这个工作核心贡献是将多个模态与文本模态对齐。这样的工作对于text2video是非常重要的。对齐即语义对齐,比如说文本是:一只小鸟在树枝上唱歌。那么如果图片是油菜花地,就是不对的;然后音频,如果是狗叫声,也跟小鸟唱歌不匹配。这就是视频、图片、音频(甚至深度图)跟文本语义对齐的意思。LanguageBind 这个名字也是相对于meta CVPR2023的工作 ImageBind来的。IMAGEBIND: One Embedding Space To Bind Them All (CVPR 2023)https://github.com/facebookresearch/ImageBind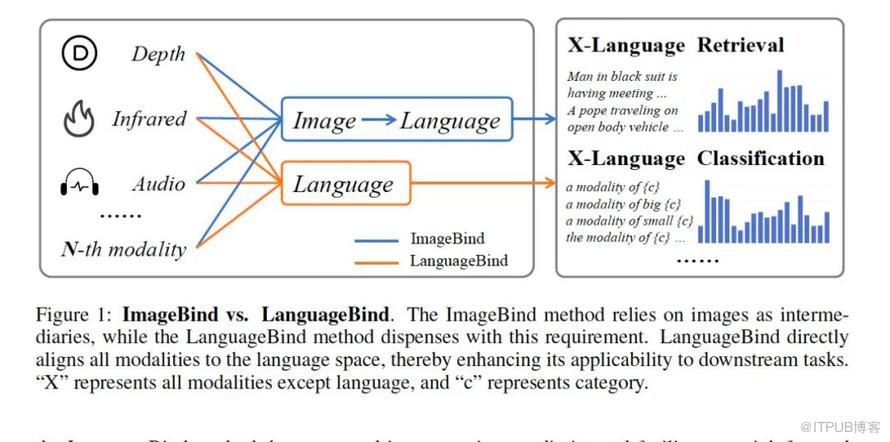
ImageBind 是先将其他模态,例如深度图,红外图,音频这些,先跟图片语义对齐,然后图片跟文本是不需要对齐的,他们有标准的image-text文本图像对去对应。这样的话,相当于 图片是一个中间转换器,将文本和音频深度图这些模态对应上了。这个是有原因的,因为互联网上image-text pair对是很多的,但音频-text对就比较少。这样的一个工作可以让text对应上多模态,从而扩大了训练集。LanguageBind 如图所示,它就更直观,直接讲多个模态和text语义对齐。那么不是缺audio-text pair对么?这个工作就自己建立了一个几百万的数据集。VIDAL-10M数据集是一个多模态数据集,包含了1000万对视频-语言数据、1000万对红外-语言数据、1000万对深度-语言数据以及100万对音频-语言数据。从这个角度来看,LanguageBind 这个工作有点讨巧,不过也算是一个突破吧。整个pipeline 全在这个图里。我们来详细讲解下。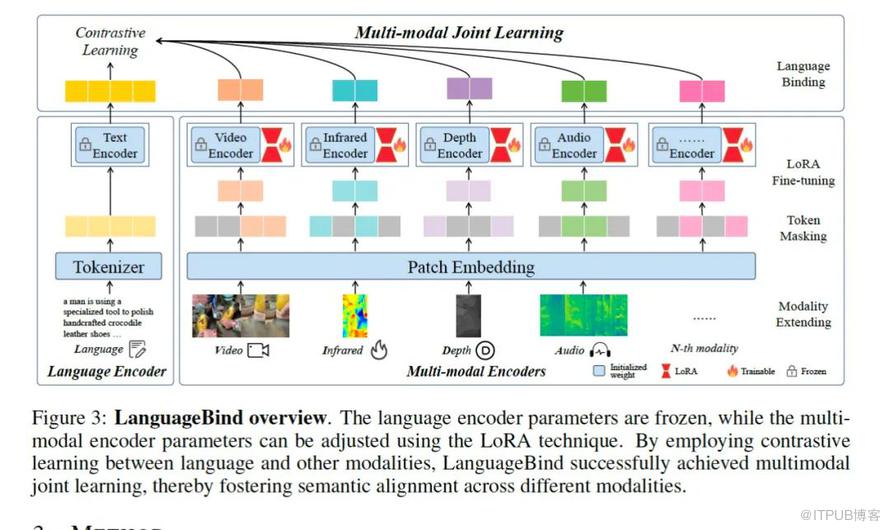
首先,他认为文本模态是最稳定的,text是基准,他们的编码器固定不变;然后,视频、音频这些编码器是可训练的。他训练的方式不是训练基座编码器,而是训练的微调lora。他训练的方式就是经典的CLIP 训练方式。即openai 于2021年发表的论文:Learning Transferable Visual Models From Natural Language Supervision 里面的Contrastive Language-Image Pretraining。这个loss 原本是文本和图片配对训练的。这次LanguageBind 将其扩展到了多模态领域。
Loss 函数看起来非常复杂,我一句话给大家讲明白:就是 如果两个模态,例如 音频是小鸟叫,文本是小鸟在树枝上叫,那么,他们之间的相似性应该是1,其他都是0.放在batch 里面去计算交叉熵:例如batch=3的矩阵:(A是一个模态,B是另一个模态,然后数字编号代表是同一个pair)打* 号的位置应该是1,其他接近0.就这么训练。这样很好理解的。
原文作者:Agent的潜意识;如有侵权,请联系管理员删除。

