▼最近直播超级多,预约保你有收获
—1—
LangChain 的2大核心概念
—2—
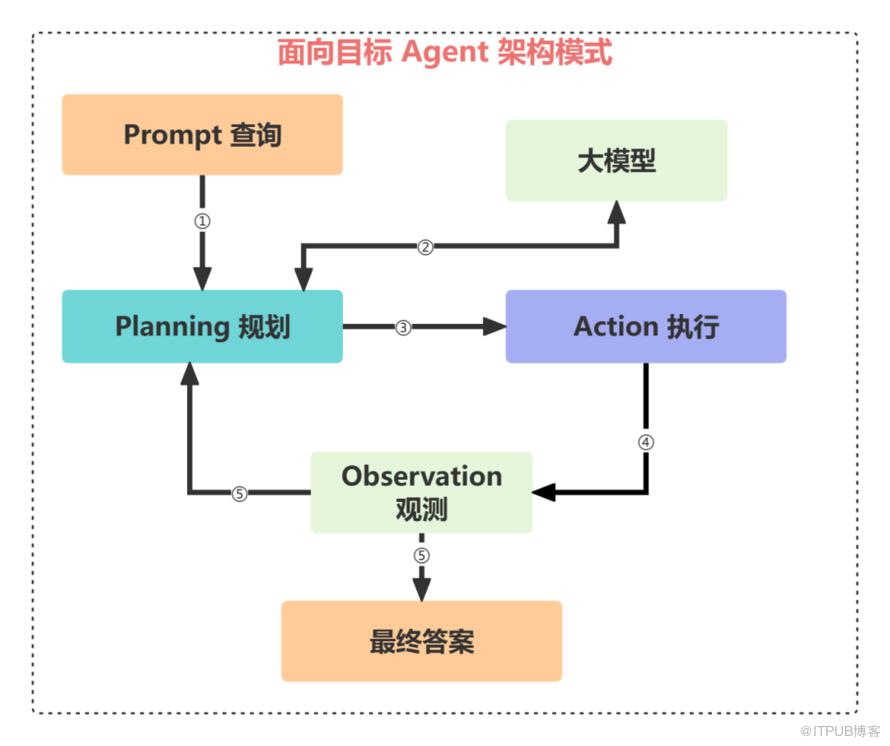
LangGraph 架构设计
LangGraph 以 LangChain 为核心,用于创建工作流程中循环图的开发框架。
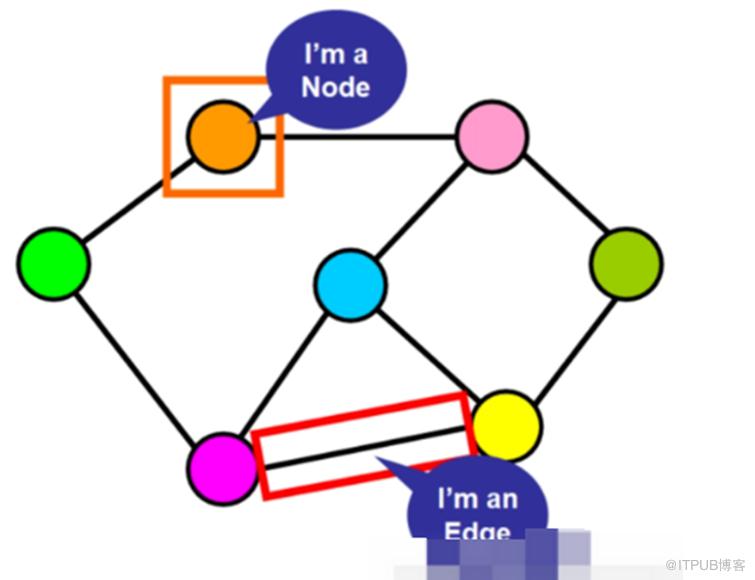
我们来看如下的需求:
你希望在知识库上搭建一个基于 RAG 的检索增强系统。现在,你希望引入这样一种情况:如果 RAG 检索输出未满足特定质量要求,智能体/链应该再次检索数据,并且 Rewrite Prompt 提示词。重复此过程,直到检索数据达到质量阈值为止。
—3—
使用 LangGraph 改善 RAG

3.1、初始化大模型。这里使用 OpenAI API,也可以使用其他大模型。
from typing import Dict, TypedDict, Optional
from langgraph.graph import StateGraph, END
from langchain.vectorstores import Chroma
from langchain.chains import RetrievalQA
from langchain.llms import OpenAI
from langchain.embeddings.openai import OpenAIEmbeddings

llm = OpenAI(openai_api_key='your API')
3.2、定义一个 StateGraph,为 LangGraph 的图对象。
class GraphState(TypedDict):
    question: Optional[str] = None
    classification: Optional[str] = None
    response: Optional[str] = None
    length: Optional[int] = None
    greeting: Optional[str] = None

workflow = StateGraph(GraphState)3.3、从现有向量数据库中初始化一个 RAG 检索链。
def retriever_qa_creation():
        embeddings = OpenAIEmbeddings()
        db = Chroma(embedding_function=embeddings,persist_directory='/database',collection_name='details')
        qa = RetrievalQA.from_chain_type(llm=llm, chain_type="stuff", retriever=db.as_retriever())
        return qa

rag_chain = retriever_qa_creation()
3.4、我们将向该 StatGraph 图中添加节点。
def classify(question):
    return llm("classify intent of given input as greeting or not_greeting. Output just the class.Input:{}".format(question)).strip()

def classify_input_node(state):
    question = state.get('question', '').strip()
    classification = classify(question)
    return {"classification": classification}

def handle_greeting_node(state):
    return {"greeting": "Hello! How can I help you today?"}

def handle_RAG(state):
    question = state.get('question', '').strip()
    prompt = question
    if state.get("length")<30:
         search_result = rag_chain.run(prompt)
    else:
         search_result = rag_chain.run(prompt+'. Return total count only.')

    return {"response": search_result,"length":len(search_result)}


def bye(state):
    return{"greeting":"The graph has finished"}

workflow.add_node("classify_input", classify_input_node)
workflow.add_node("handle_greeting", handle_greeting_node)
workflow.add_node("handle_RAG", handle_RAG)
workflow.add_node("bye", bye)
使用 state.get() 来读取任何状态变量。
-
handle_RAG 节点帮助实现我们希望的循环自定义逻辑。如果输出的长度< 30,则使用提示符 A;否则使用提示符 B。对于第一种情况(当 RAG 节点尚未执行时),我们将传递 length=0,并提供一个提示词。
3.5、我们将添加入口点和边。
workflow.set_entry_point("classify_input")
workflow.add_edge('handle_greeting', END)
workflow.add_edge('bye', END)3.6、 我们添加条件边。
def decide_next_node(state):
    return "handle_greeting" if state.get('classification') == "greeting" else "handle_RAG"

def check_RAG_length(state):
    return "handle_RAG" if state.get("length")>30 else "bye"

workflow.add_conditional_edges(
    "classify_input",
    decide_next_node,
    {
        "handle_greeting": "handle_greeting",
        "handle_RAG": "handle_RAG"
    }
)

workflow.add_conditional_edges(
    "handle_RAG",
    check_RAG_length,
    {
        "bye": "bye",
        "handle_RAG": "handle_RAG"
    }
)3.7、编译并调用提示词。初始时保持 length 变量设置为0。
app = workflow.compile()
app.invoke({'question':'Mehul developed which projects?','length':0})
# 输出
{'question': 'Mehul developed which projects?',
 'classification': 'not_greeting',
 'response': ' 4',
 'length': 2,
 'greeting': 'The graph has finished'}
对于上述提示多次,LangGraph 图流程如下所示:
classify_input: 情感将为not_greeting。
由于第一个条件边界,移至handle_RAG。
由于 length=0,使用第一个提示并检索答案(总长度将大于30)。
由于第二个条件边界,再次移至 handle_RAG。
由于 length>30,使用第二个提示符。
由于第二个条件边界,移至 bye。
结束。
为了帮助同学们彻底掌握 LangChain 和 LangGraph 的架构设计应用,今晚20点我会开一场直播和同学们深度剖析,请同学们点击以下预约按钮免费预约。
—4—
AI大模型架构设计直播课程
立即扫码,即可免费预约
进入直播,大佬直播在线答疑!
本期名额有限
高度起始于速度(手慢无!!)
—5—
领取一份《AI 大模型技术知识图谱》
第二步:扫码后,点击以下关注按钮,就可关注我。

参考:https://mp.weixin.qq.com/s/Qxnny8ZHA_yG_XLQJm_QKg
END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

