▼最近直播超级多,预约保你有收获
—1—
大模型在线推理 GPU 资源如何选择?
在业务场景中大模型的在线推理服务大都是 OLTP 场景,需要实时响应,才能够满足业务的时延需求(比如:搜索、推荐等场景)。大模型的推理首 token 时延(time to first token)要求1秒以内,甚至毫秒级。这样的实时在线场景都是显存I/O速度受限(Memory-Bound)的。也就是说需要首先优化大模型的响应速度,而大模型的在线推理吞吐量(throught,tokens per second)不是首要目标(当然业务每秒上万并发或者10万并发除外)。除了首 token 时延,大模型在线推理服务也需要关注尾 token 时延(即完成一次会话响应的时延),站在业务的使用角度,大模型在线推理的 Response 响应越快越好。
在 Memory-Bound 场景里,为了提升 GPU 利用率,往往采取张量并行(intra-layer)的加速方式,将大模型参数进行切分,减少从显存中读取大模型参数的耗时,从而提升参数计算的速度。如下图所示:
大模型参数层内划分,切分一个独立的层划分到不同的 GPU 上 0 号卡和 1 号卡分别计算某个层的不同部分
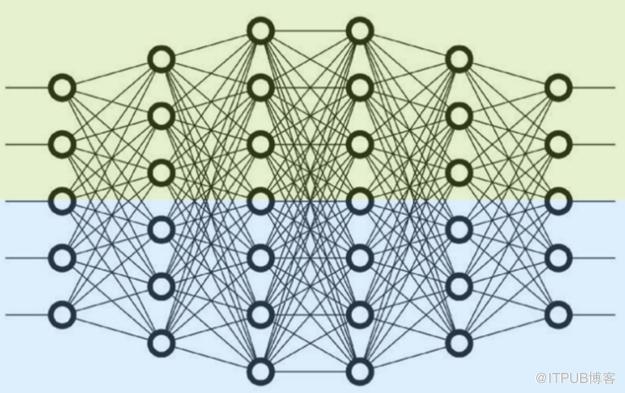
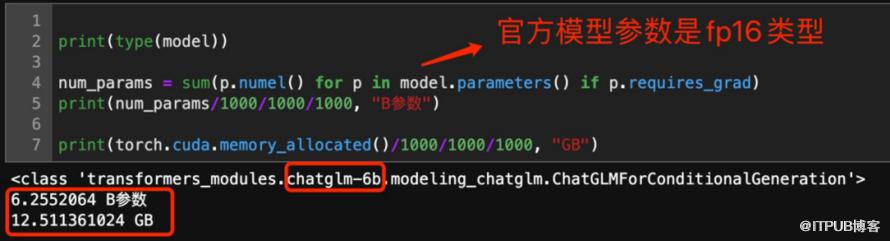
比如:对于 6B的模型,如果使用 FP16 精度进行大模型推理,那么大模型参数所占的显存空间约为 :6B * 2 = 12 GB。如果是使用单张 A10 卡进行推理,那么从显存中读取大模型参数的耗时约为:0.02秒(12/600 = 0.02,600 为 A10 的显存带宽(600GB/s))。如果是使用两张 A10 卡进行推理,并选择张量并行度=2,那么从显存中读取模型参数的耗时约为 0.01 秒(12/(600*2)= 0.01)。
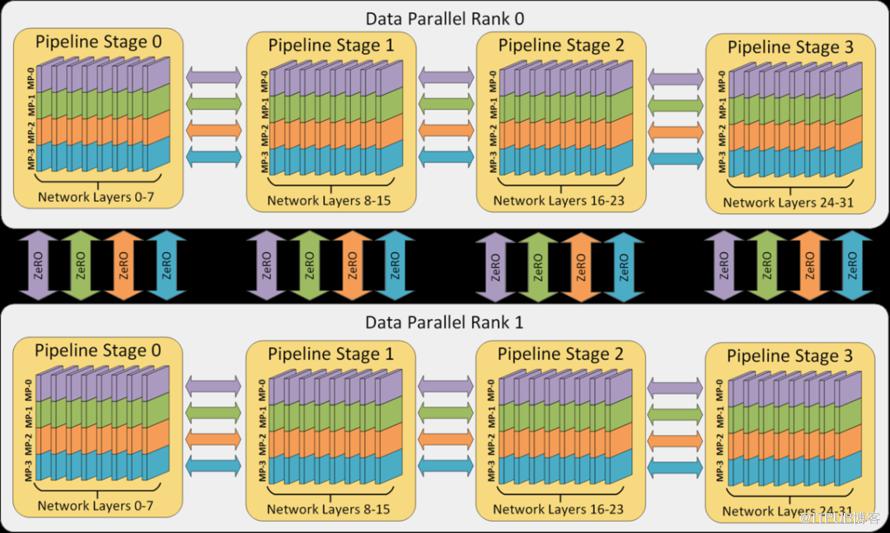
当然使用多卡进行大模型在线推理,并不是越多越好,因为张量并行策略会带领额外通信开销,所以需要根据大模型参数规模来选择折中方案,并通过实际测试来看哪个方案时延最优。进一步来讲,当单机8个 GPU 卡总的显存都放不下大模型参数时,就需要使用流水线并行技术(Pipeline Parallelism),以便将大模型参数切分到不同的显存服务器上。比如下图的 3D 并行,一共32个 workers 节点,由4路张量并行、4路流水线并行、2路数据并行构成。
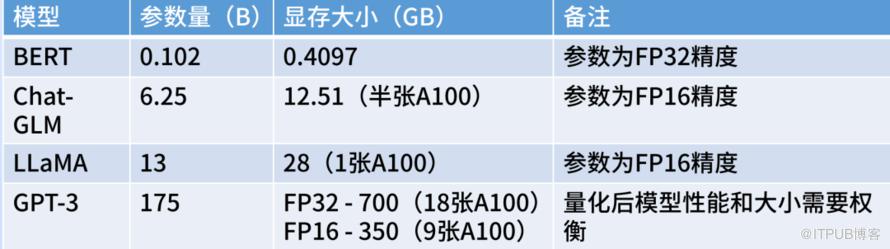
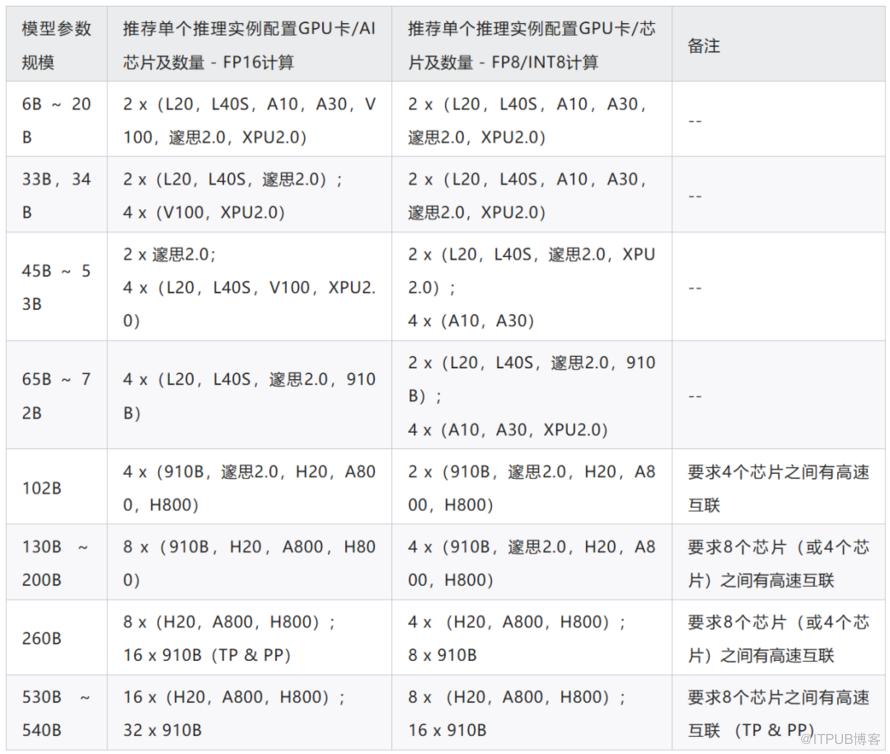
针对不同参数规模的大模型,其推理所使用的 GPU 资源选择也不一样,主要考虑的因素就是大模型参数所占的显存空间以及推理服务的性价比。使用 FP8 精度或 INT8 精度进行大模型推理,可以显著降低显存空间开销,也可以有效降低计算开销。一般情况下,使用FP8 精度推理比使用 INT8 精度推理可以获得更好的模型效果(或者说,相对于 FP16 计算,FP8 计算带来的大模型效果损失更小)。
基于实践经验优化大模型在线推理服务时延(比如:batch size = 1),我们推荐以下大模型推理资源配置。
—2—
大模型在线推理框架如何选择?

为了帮助同学们彻底掌握大模型的应用开发、部署、生产化,今晚20点我会开一场直播和同学们深度剖析,请同学们点击以下预约按钮免费预约。
—3—
送!AI大模型开发直播课程
立即扫码,即可免费预约
进入直播,大佬直播在线答疑!

本期名额有限
高度起始于速度(手慢无!!)
—4—
再送!!《AI 大模型技术知识图谱》
第二步:扫码后,点击以下关注按钮,就可关注我。
参考:https://zhuanlan.zhihu.com/p/678763741
END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

