
大家好,我是阿秀。
互联网公司一般都是有核心部门和业务的,比如字节抖音、腾讯天美、百度凤巢、微信 WXG 这些都是核心部门代表,这类核心部门在公司内部地位较高,资源都会优先倾斜,话语权更重。因此招人自然也就更慎重一些,面试次数都会比较多。当然了,如果社招从这些部门跳槽出来,double涨薪都很有可能 。
一般互联网技术岗最多 3 - 4 面,三轮技术面+一轮HR面算是多的了,但这类核心部门面试轮数上不封顶,最典型的就是微信WXG,六七面是常有的事,牛客网上很多 WXG 五六轮面试的分享。
分享一位师弟的WXG二面面经,这位师弟投递的是 C/C++/Golang 开发岗位,一面过的很快,只面了不到1个小时就结束了,但二面面了差不多一小时40分钟才结束。
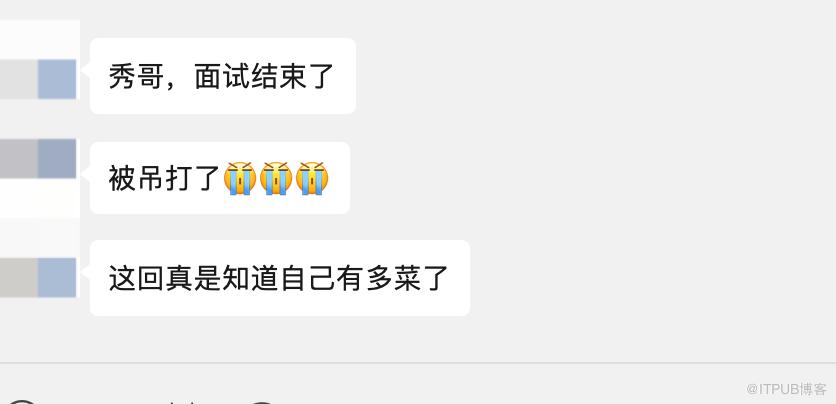
看师弟上图中的这个说法应该是挂了 ,不过他做了很好的复盘,给大家分享一下面经。二面面试中主要考察了编程语言、项目、操作系统、计算机网络、数据库MySQL和Redis以及两道算法题等,简单罗列下这次面经的考察内容:
C++:虚函数、STL、IO复用 Golang:切片、并发 操作系统:内存、状态、进程 网络:HTTPS加密、UDP MySQL:事务、B+树 Redis:缓存一致、跳表、哨兵 算法:接雨水升级版、寻找峰值
对于其中一些不错的题目,目前已经收录到阿秀去年开发的InterviewGuide网站上了,去年阿秀从字节离职,跳槽换工作期间开发了一个互联网大厂面试真题记录网站,支持按照行业、公司、岗位、科目、考察时间等查看面试真题。
有意者欢迎扫描下方二维码体验,已经有不少小伙伴遇到原题了,具体可以看下链接:2023年7月字节跳动后端研发岗面试考察题目Top10、局部性原理还真有用!
网址:https://top.interviewguide.cn/
C++
虚函数实现原理了解过吗?
在C++中,虚函数是通过虚函数表(virtual function table)来实现的。
当一个类声明了虚函数时,编译器会为该类生成一个虚函数表,虚函数表是一个指向虚函数的指针数组,每个指针指向一个虚函数的实际地址。
当一个对象被创建时,会在对象的内存布局中添加一个指向虚函数表的指针。这个指针被称为虚函数指针(vptr),当通过指向基类的指针或引用调用虚函数时,实际调用的是虚函数表中对应的虚函数。
那么它是如何调用的?
虚函数的调用过程如下:
1、编译器根据对象的静态类型确定要调用的虚函数,并通过虚函数表中的偏移量找到虚函数的地址。 2、使用虚函数指针(vptr)访问虚函数表,并根据偏移量找到虚函数的地址。调用虚函数。
这种机制实现了多态性,使得基类指针或引用可以在运行时指向派生类对象,并根据对象的实际类型调用相应的虚函数。
这样,即使通过基类指针或引用访问虚函数,也能正确地调用到派生类的实现。
STL中vector是如何实现的?和array有什么区别?
array占用的是静态空间,一旦配置了就不可以改变大小,如果遇到空间不足的情况还要自行创建更大的空间,并手动将数据拷贝到新的空间中,再把原来的空间释放。
vector则使用灵活的动态空间配置,维护一块连续的线性空间,在空间不足时,可以自动扩展空间容纳新元素,做到按需供给,在扩充空间的过程中仍然需要经历:重新配置空间,移动数据,释放原空间等操作。
Vector的扩容倍数听说是2倍,是真的?
Vector扩容倍数与平台有关,不同平台不一样,比如在Win + VS 下是 1.5倍,在 Linux + GCC 下是 2 倍。
测试代码:
#include <iostream>
#include <vector>
using namespace std;

int main()
{
    //在Linux + GCC下
 vector<int> res(2,0);
 cout << res.capacity() <<endl; //2
 res.push_back(1);
 cout << res.capacity() <<endl;//4
 res.push_back(2);
 res.push_back(3);
    cout << res.capacity() <<endl;//8
 return 0;


    //在 win 10 + VS2019下
    vector<int> res(2,0);
 cout << res.capacity() <<endl; //2
 res.push_back(1);
 cout << res.capacity() <<endl;//3
 res.push_back(2);
 res.push_back(3);
    cout << res.capacity() <<endl;//6

}
如果我打算使用epoll进行开发,需要注意什么问题?
使用epoll进行开发时,最重要的就是需要注意2个问题:
处理并发连接:epoll适用于处理大量并发连接的场景,但在实际开发中,需要考虑并发连接的管理和调度问题,如连接的创建和销毁、连接的分配和复用等。
避免资源泄露:使用epoll进行开发时,需要注意及时释放资源,避免资源泄露问题。例如,在处理完一个连接后,需要关闭相应的文件描述符、释放相应的内存等。
Golang
map和slice用过吗?它们哪个是线程安全的?
这里给我挖了个坑,其实两个都不是安全的。。。。
Go语言的map和slice都不是线程安全的。
在Go语言中,map和slice是引用类型,它们在多个协程之间共享数据时需要额外的同步机制来保证线程安全,如果多个协程同时对map或slice进行读写操作,可能会导致数据竞争和不一致的状态。
那在并发环境中怎么安全使用呢?你知道哪些方法?》
为了在并发环境中安全地使用map和slice,可以使用互斥锁(sync.Mutex)来提供同步访问。
通过在访问map或slice之前获取互斥锁,可以确保同一时间只有一个协程可以访问该数据结构,从而避免数据竞争。
Golang协程的通讯方式有哪些?
共享内存:协程通过共享内存来交换数据,这种方式简单直接,但需要考虑同步和互斥问题,否则会出现数据竞争等问题。 消息传递:协程通过消息队列等方式来传递数据,这种方式可以避免数据竞争等问题,但需要考虑消息的发送和接收顺序等问题。 信号量:协程通过信号量等方式来实现同步和互斥,这种方式需要考虑好信号量的数量和使用顺序,否则会出现死锁等问题。
操作系统
用户态和内核态是什么?有什么区别?
内核态指的是cpu可以访问内存的所有数据,包括外围设备,例如硬盘,网卡,cpu也可以将自己从一个程序切换到另一个程序。
用户态指的是只能受限的访问内存,且不允许访问外围设备,占用cpu的能力被剥夺,cpu资源可以被其他程序获取。
他们俩最大的区别就是权限不同,在运行在用户态下的程序不能直接访问操作系统内核数据结构和程序。
内存交换和覆盖有什么区别?
交换主要是在不同进程(或作业)之间进行,而覆盖则用于同一程序或进程中。
进程调度知道哪几种方法?
1、 先来先服务 first-come first-serverd(FCFS)
非抢占式的调度算法,按照请求的顺序进行调度。
有利于长作业,但不利于短作业,因为短作业必须一直等待前面的长作业执行完毕才能执行,而长作业又需要执行很长时间,造成了短作业等待时间过长。
2、 短作业优先 shortest job first(SJF)
非抢占式的调度算法,按估计运行时间最短的顺序进行调度。
长作业有可能会饿死,处于一直等待短作业执行完毕的状态。因为如果一直有短作业到来,那么长作业永远得不到调度。
3、最短剩余时间优先 shortest remaining time next(SRTN)
最短作业优先的抢占式版本,按剩余运行时间的顺序进行调度。当一个新的作业到达时,其整个运行时间与当前进程的剩余时间作比较。
如果新的进程需要的时间更少,则挂起当前进程,运行新的进程。否则新的进程等待。
4、时间片轮转
将所有就绪进程按 FCFS 的原则排成一个队列,每次调度时,把 CPU 时间分配给队首进程,该进程可以执行一个时间片。
当时间片用完时,由计时器发出时钟中断,调度程序便停止该进程的执行,并将它送往就绪队列的末尾,同时继续把 CPU 时间分配给队首的进程。
时间片轮转算法的效率和时间片的大小有很大关系:
因为进程切换都要保存进程的信息并且载入新进程的信息,如果时间片太小,会导致进程切换得太频繁,在进程切换上就会花过多时间。 而如果时间片过长,那么实时性就不能得到保证。
5、优先级调度
为每个进程分配一个优先级,按优先级进行调度。
为了防止低优先级的进程永远等不到调度,可以随着时间的推移增加等待进程的优先级。
6、多级反馈队列
一个进程需要执行 100 个时间片,如果采用时间片轮转调度算法,那么需要交换 100 次。
多级队列是为这种需要连续执行多个时间片的进程考虑,它设置了多个队列,每个队列时间片大小都不同,例如 1,2,4,8,…。进程在第一个队列没执行完,就会被移到下一个队列。
这种方式下,之前的进程只需要交换 7 次。每个队列优先权也不同,最上面的优先权最高。因此只有上一个队列没有进程在排队,才能调度当前队列上的进程。
可以将这种调度算法看成是时间片轮转调度算法和优先级调度算法的结合。
计算机网络
UDP可以实现可靠传输吗?
可以,你可以参考QUIC协议或者用一种比较简单的方式
那就是在应用层模仿传输层TCP的可靠性传输。下面不考虑拥塞处理,可靠UDP的简单设计。
1、添加seq/ack机制,确保数据发送到对端 2、添加发送和接收缓冲区,主要是用户超时重传。 3、添加超时重传机制。
补充说明:送端发送数据时,生成一个随机seq=x,然后每一片按照数据大小分配seq。数据到达接收端后接收端放入缓存,并发送一个ack=x的包,表示对方已经收到了数据。发送端收到了ack包后,删除缓冲区对应的数据。时间到后,定时任务检查是否需要重传数据。
HTTPS采用的加密方式有哪些?是对称还是非对称?
HTTPS 采用混合的加密机制,使用非对称密钥加密用于传输对称密钥来保证传输过程的安全性,之后使用对称密钥加密进行通信来保证通信过程的效率。
MySQL
说一下事务的一致性?可以举个例子吗?
一致性是指在事务开始之前和事务结束以后,数据库的完整性约束没有被破坏。
举个例子:比如A向B转账,不可能A扣了钱,B却没收到。
Hash表比B+树更快,为什么MySQL用B+树来存储索引?
MySQL中存储索引用到的数据结构是B+树,B+树的查询时间跟树的高度有关,是log(n),如果用hash存储,那么查询时间是O(1)。
采用Hash来存储确实要更快,但是采用B+树来存储索引的原因主要有以下两点:
一、从内存角度上说,数据库中的索引一般是在磁盘上,数据量大的情况可能无法一次性装入内存,B+树的设计可以允许数据分批加载。
二、从业务场景上说,如果只选择一个数据那确实是hash更快,但是数据库中经常会选中多条,这时候由于B+树索引有序,并且又有链表相连,它的查询效率比hash就快很多了。
Redis
延时双删是什么意思?
延时双删是用来解决缓存不一致问题的,一般是是先删除缓存,再更新数据库,最后再删除缓存删除缓存。唯一不同的是,我们把这个删除的动作,在不久之后再执行一次,比如 5s 之后。
Redis使用跳表的原因是什么?为啥不用树,比如红黑树?
内存占用低:跳表相对于红黑树来说,对于存储空间的利用率更高。红黑树需要额外的指针来维护红黑树的性质,而跳表不需要额外的指针,只需要存储节点的值和层级索引即可。
简单扩展:跳表在扩展方面比较简单,只需要增加层级索引即可。而红黑树在扩展方面相对复杂,需要进行平衡操作,可能需要重构整个树结构。
算法
接雨水升级版、寻找峰值。

你好,我是阿秀,普通学校毕业,校招时拿到字节跳动SP、百度、华为、农业银行等6个互联网中大厂offer,毕业后先于抖音部门担任全栈开发工程师,目前在上海某外企带领团队继续从事全栈开发,负责一个对印项目。
研三快毕业那年就组建了一个阿秀的学习圈,一直持续分享校招/社招跳槽找工作的经验,都是自己一路走过来的经验,目前已经累计服务超过 3300 +人,欢迎点此了解一二。
原文作者:拓跋阿秀;如有侵权,请联系管理员删除。

