译者注: 在应急响应建设过程中,MTTR是一个非常关键的指标,业界也经常有“1-5-10/5-5-10”之类的说法,如何对MTTR进行详细拆解,并在我们日常的应急响应工作中给予指导,本文可以作为一篇不错的参考文章。
前言
• 如果你没有良好的监控覆盖范围和/或自动报警系统,则MTTD是一个不错的指标可以开始使用。
• 在使用MTTR指标之前,一定要澄清“R”代表什么(至少有六种定义方式)。
• 根据你想要关注的重点领域,可能需要不同版本的MTTR。如果选择了错误的度量标准,则优化的方向可能会出现偏差。
• MTTResolve关注的是生产力成本,MTTRemedy关注的是面向客户的风险。
• 虽然MTT*中的“M”代表“平均”,但找到异常并聚焦于优化的一个好方法是使用百分位数。
“故障”是指未经计划的服务中断或降级,会对客户产生负面影响。网站可靠性工程师(SRE)和开发运营(DevOps)使用多个重要的时间指标来优化故障响应。本文将介绍这些指标含义、何时使用它们、它们的一些缺点以及进一步的阅读资源。
一、分解故障生命周期
让我们先看下故障期间都会发生什么:
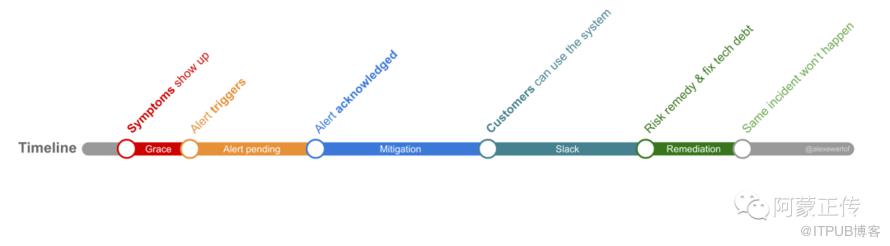
Symptoms show up - 现象出现
现在某些东西出了问题,导致用户受到了影响(例如网站宕机和其他的情况等等),稍后我们将讨论如何根据客户影响将故障分组,现在假设某些客户已经受到了故障的影响。
理想情况下,我们应该有一个监控工具来观察故障现象,并在必要时触发警报,通知值班人员采取措施。然而在产品刚上线或者SLO指标尚未定义的时候,可能会没有此类监控告警。另外,如果没有运维团队或缺乏观测经验,团队可能没有自动警报系统,只能通过不断观察监控报表(轮询)的方式来检测故障。这种情况可能就难以提前发现故障,直到客户发现问题并寻求支持。
在有了自动监控和警报工具的情况下,在警报触发之前通常会有一个宽限期。如果没有宽限期,每个轻微的现象都会唤醒值班人员,即使它会在几分钟内自行解决(例如,在负载峰值期间暂时增加错误率)。
告警宽限期可以是几分钟到几个小时。如果宽限期太长,将会影响用户体验(用户已经受到了影响,但是值班人员仍未收到告警),如果太短,值班人员将会非常辛苦(会收到频繁的告警)。需要在业务风险承受能力和团队士气之间找到平衡。
有个比较好的实践方式:是基于现象而不是原因来设置警报。例如,设置CPU利用率高于90%的警报可能很容易也很诱人,但是这个告警不一定有用(即使CPU90%,系统可能能够处理负载峰值而没有任何问题)。但是如果针对系统错误率进行告警,这个可能会更接近用户的实际体验。作为最佳实践,应根据现象设置警报。通过关注现象,我们确保如果值班人员接到通知,他们手头上有一个客户可感知的故障,而不是一个可能与用户体验无关痛痒的警报。
Alert triggers - 告警触发
现在我们知道有问题了:要么是来自客户支持,要么是来自监控系统。触发警报通知值班人员进行排查。在理想情况下,故障处理应立即开始,但实际上,警报触发只是让值班人员开始排查的第一步。例如,如果是晚上,他们需要起床,找到手机,重新思考自己的职业选择是否正确(译者注:一句玩笑话,意思是对半夜起床处理告警的吐槽) ,并了解发生了什么。
如果一线值班支持人员在指定时间内没有确认告警,那么二线值班支持人员可能会收到告警。
Alert acknowledged - 确认告警
值班人员确认已收到告警并开始进行排除故障:
• 先确认当前是否为确实需要处理的告警,这一步可以排除告警误报。
• 对故障进行影响级别评估(严重级别参考)
• 必要时通知其他相关的值班人员。
当开始处理故障时,请尽量避免以下反模式,包括:
• 让太多人参与电话会议并强迫他们留在会议中。(译者注:只让必要的人参与会议,不需要太多非必要的人员参与到会议中,其他人可以通过相关渠道关注进展)
• 一直在频繁的更新故障进展,一旦没有更新,就认为故障没有进展。(译者注:在处理事故时,人们可能会不断地更新进展情况,以保持所有人都知道最新情况。但是如果没有更新进展,可能是在分析问题,不要认为当前没有进展,从而给故障处理人员带来额外的压力)。
• 在处理故障时花费大量时间来评估故障的严重程度,或者犹豫不定是否将其升级给其他负责人来处理。(如果不确定,可以先用最高优先级。)
• 在处理故障时,将注意力转移到应急流程和相关制度上,这会导致重点被转移,建议将此类问题推迟到复盘环节再讨论。
• 跳过故障复盘、事后分析或改进计划。
Mitigation - 缓解(快速止血)
现在我们有了一项优先级排序的故障,并且相关人员已经到场。止血的主要部分开始了:
• 分析现象以找到原因并解决问题
• 可能需要更改、测试和部署生产配置或代码
随着团队对根本原因和故障爆炸半径的了解越来越多,其影响范围可能会从确认告警时的原始评估发生变化:如果故障影响更大,则可能会被升级,但如果故障影响较小,则可能需要降级。
此外,故障可能会被委托给另一个团队去处理,该团队可能拥有解决面向客户的影响的关键因素。
有时候为了尽快恢复业务,可能会采用一些临时方案来解决问题,但这会产生技术债务。
Remediation - 后续处理
过一段时间后,我们需要进行一次后续复盘,并从故障中学习。评估故障的风险并消除或者降低降低发生概率,是复盘的一个关键产出结果。同时,还会有进一步的改进计划:
• 清理:修复在缓解故障过程中所产生的技术债务。例如,手动设置配置而不使用基础设施即代码(IaC)的配置漂移。
• 纠正:实施一些措施以确保此故障不会再次发生。这可能需要阻止一些非授权访问,也可能需要对整个系统进行重构。
在某些情况下,评估的结果可能是不需要做任何的改变,事故发生的概率非常低,ROI太低以至于不值得进行额外的修复。这时候可以认为不需要采取任何行动,能接受故障风险。
二、Metrics - 指标度量
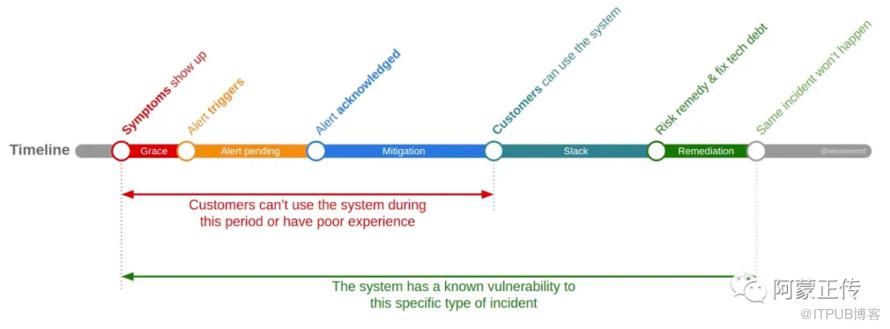
在我们深入了解指标之前,请记住两个时间段:
• 客户遭受故障的时间(实际风险)
• 企业易受该故障影响的时期(潜在风险)
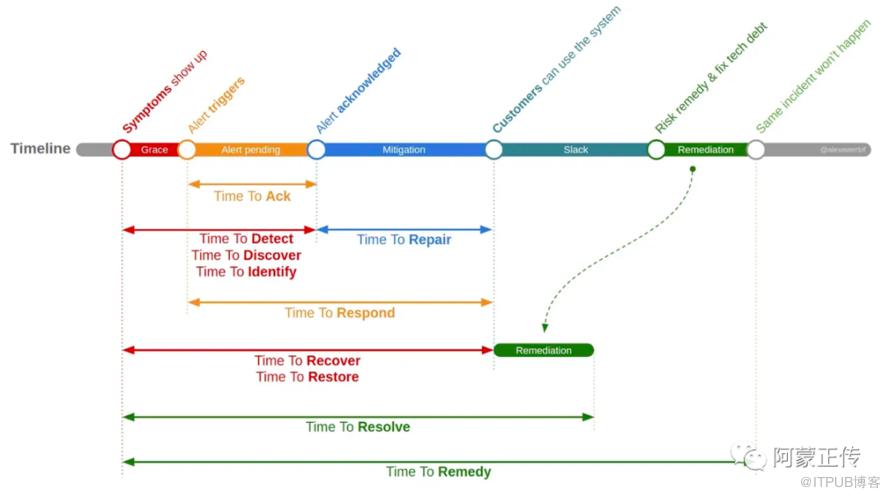
这种情况下,特定的故障可能只是一次性故障,但如果不进行修复,它可能会再次发生。以下是显示这两个时间段的插图:
MTTA
MTTA 代表平均确认时间。它是从触发告警的那一刻到值班人员确认它的时间。
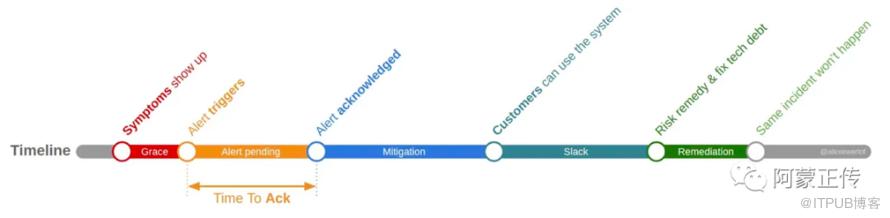
度量和优化MTTA的意义,可以确保工具配置正确,并且负责处理问题的人能够快速响应。
优化此指标时,请务必牢记两点:
• 正确性:确保监控系统会过滤掉误报,以便在通知值班人员时,他们会认真对待。
• 士气:处理告警是一件很辛苦的事情,特别是半夜去叫醒值班人员,或者打扰他们的工作/生活平衡时。如果一味地期望快速响应,会损害团队士气并导致员工流失,最终影响业务。
MTTD/MTTI
MTTD 代表平均检测时间或平均发现时间。MTTI 代表平均识别时间,只是 MTTD 的另一个名称。
它测量从故障首次出现到值班人员确认告警之间的时间。换句话说,它是从问题影响客户到你的企业发现问题的衡量标准。
如果您没有好的监控覆盖范围和/或自动警报功能,MTTD是一个不错的起点指标。目标是确保故障能通过监控系统(指标和日志)来发现,而不是依赖客户联系支持部门。
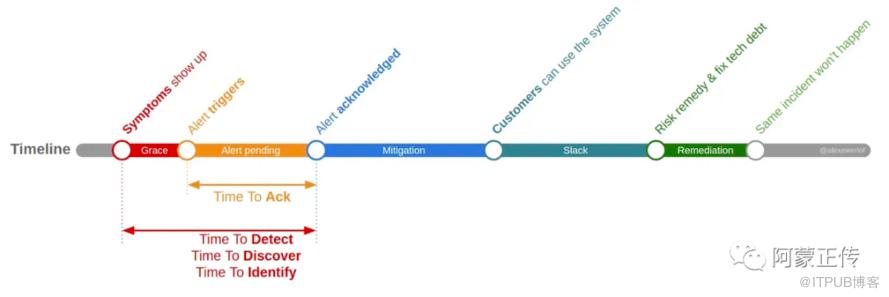
关注 MTTD 可以在 MTTA的基础上,发现更多的问题:
• 可观测性覆盖范围(Observability coverage):您是否有可靠的日志、指标和跟踪来很好地了解系统状态并识别所有类型的影响用户的故障?
• 指标质量(Metric quality):当前的指标是否准确地代表了系统状态,他们的来源是否正确或者是否存在偏差?例如:由于指标采样不当,数据可能会说系统是健康的或有故障的,而客户的体验并非如此。
• 警报宽限期(Alert grace period):您是否在触发警报之前等待了足够长的时间?为了减少噪音,可以在触发警报之前观察系统一段时间。宽限期太短和错误警报都可能会导致警报疲劳,但是如果宽限期太长,系统可能会消耗错误预算,并且企业可能会因违反服务水平协议 (SLA) 而蒙受损失。
MTTR
现在我们处于“MTTR”指标领域。您可能知道 MTTR 代表什么,但大多数人并不知道所有 6 个答案。尽管只有不到 4% 的英语单词以字母“R”开头,但几个重要的 SRE 单词都属于这一类:恢复、修复、解决、响应、恢复和补救。现在让我们指出它们的区别并决定如何使用它们。
MTTRepair
平均修复时间衡量的是从确认警报到客户可以再次使用系统的时间。如果 MTTA 和 MTTD 已经在可接受的范围内,则该指标是对它们的一个很好的补充。
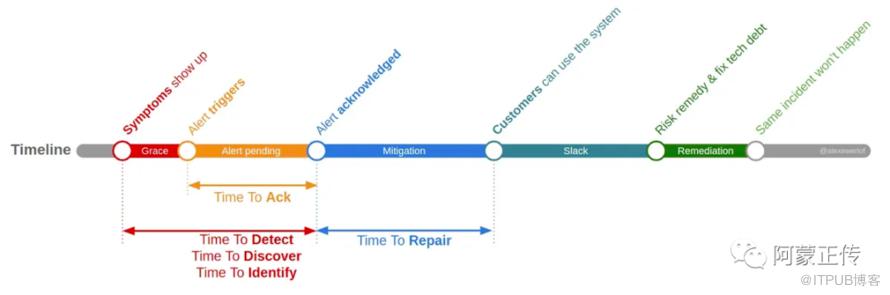
优化 MTTRepair 可以将你的重点集中在主要的故障处理活动中(通常是手动操作),并可以实现以下目标:
• 优先级排序(Prioritization) :首先解决已经影响到客户的故障。
• 准备工作(Preparation) :改进运行手册并在可能的情况下自动化部分操作。运行手册很容易偏离轨道并变成单调乏味的工作,但自动化可能需要更高的成本投入,有时候可能不值得这样做
• 演练(Practice) :经常使用这些流程,使其成为习惯,例如与团队一起进行模拟演练(模拟处理故障场景)。
• 授权(Mandate) :确保值班人员有正确的访问权限,能够评估系统并缓解故障(例如,对可观测性数据、运行手册、云提供商等的访问权限)。
• 方法(Approach) :确保负责值班的人有系统的解决问题方法,考虑所有备选方案,更重要的是验证他们的假设,并随着对故障了解的增加重新评估它们。。
• 取证(Forensics) :保存一些相关的证据以进行事后的根本原因分析(以缩短故障解决时间和故障修复时间)。
如果你有兴趣,Google SRE 书中有更多关于故障管理的信息。
MTTRespond
MTTRespond 测量从触发警报到消除客户面临的症状所花费的时间。

MTTRespond综合了MTTAck和MTTRepair的范围。显然,将两个独立变量(待处理的警报和缓解)聚合在一起存在分散注意力的风险。另一方面,它比任何一个指标都更广泛,可以确保优化一个指标的权衡不会伤害另一个指标。例如,为了减少跨时区办公室的公司的MTTAck,您可以采用“跟随太阳”的on-call模式,目标是在他们的工作时间内向on-call人员发送警报,而不是在夜间将他们叫醒。但由于沟通问题,亚洲或欧洲的MTTRepair可能与美国总部不同。
请注意,常用的故障响应平台PagerDuty使用了不同的术语。他们使用“resolved”代替“responded”,这可能会造成困惑。
如果您选择优化一个聚合指标,您可能希望将重点放在MTTRecover上,这与客户面临的症状更相符。
MTTRecover/MTTRestore
MTTRecover衡量了从客户端出现症状到这些症状对客户端被消除的时间。MTTRecover有时也被称为MTTRestore。
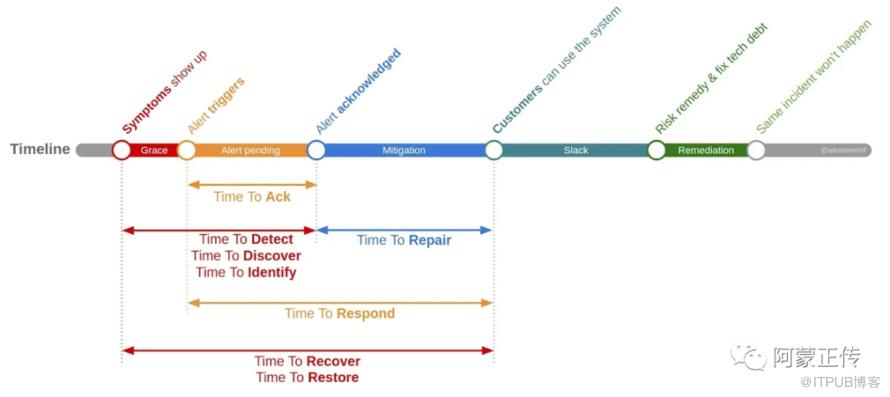
这是最重要的指标之一,因为它代表了客户经历故障的时间段。然而,它聚合了三个独立的变量(警报宽限期,待处理警报和缓解),这可能会分散优化的重点。另一方面,任何减少此指标的努力都将直接对客户产生影响。
MTTResolve
MTTResolve与MTTRecover相似,但它考虑到了修复系统并确保不会再次发生类似故障所需的时间。
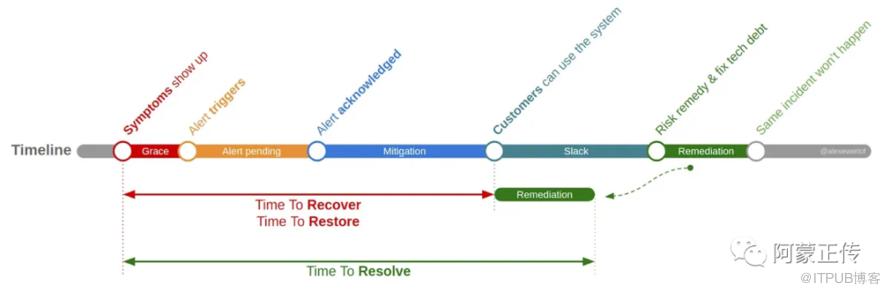
例如,你的产品可能会因为某个重要事件(比如超级碗广告,译者注:美国的类似春晚的节目)引起的流量突然变化而遇到负载激增。当然,缓解故障是最重要的,以最大化广告的投资回报,但确保系统下一次出现类似问题时不会遇到同样的问题同样重要。
只有当风险被消除后,事故才真正解决(因此称为MTTResolve)。这不是要优化的第一个指标,通常更适合已经优化了其他MTTR *指标的产品,并且现在需要优化适当的解决方案。
MTTResolve 往往很难计算,因为纠正问题所花费的时间往往难以追踪,并且需要手动跟踪。而 MTTRemedy 更容易计算。
并非所有的事故都需要进行纠正。可能根本原因不太可能再次发生,或者再次发生的可能性很小或者纠正措施成本很高,因此业务接受再次发生的风险,并在发生时进行缓解。
MTTRemedy
MTTRemedy 从风险实现成为问题到消除问题的过程中所需的时间。
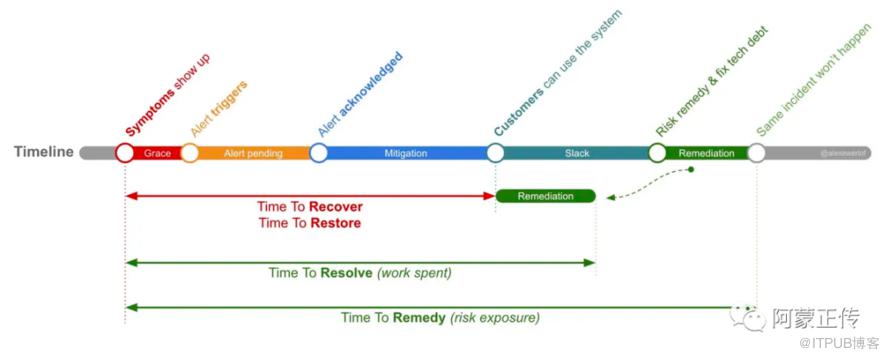
例如,如果由于最近的log4j零日漏洞,您的系统被黑客攻击,尽管已经采取了缓解措施,但在代码被重构、测试并部署到生产环境之前,系统仍然存在潜在的漏洞。
与 MTTResolve 更关注测量事故实际工作时间不同,MTTRemedy 关注的是系统存在漏洞的时间。MTTResolve 忽略了在事故缓解与纠正开始之间浪费的闲暇时间,而优化 MTTRemedy 鼓励尽早开始纠正措施。
作为一个附加的好处,MTTRemedy 更容易计算,因为更容易计算风险何时被消除。
其他需要关注的
Mean vs median 平均值与中位数
MTT代表“平均时间到达”。平均数在数据呈钟形曲线分布时效果很好。然而,中位数可以给出更好的图片,更准确地聚焦于优化工作。 作为SRE,我们经常使用百分位数来发现异常值。中位数就是50%的百分位数。根据事故数据和优化成熟度,您可能会选择使用“p50响应时间”而不是“平均响应时间”,这样可以更好地关注异常值。例如,这里是最近20个假想服务的MTTAck:
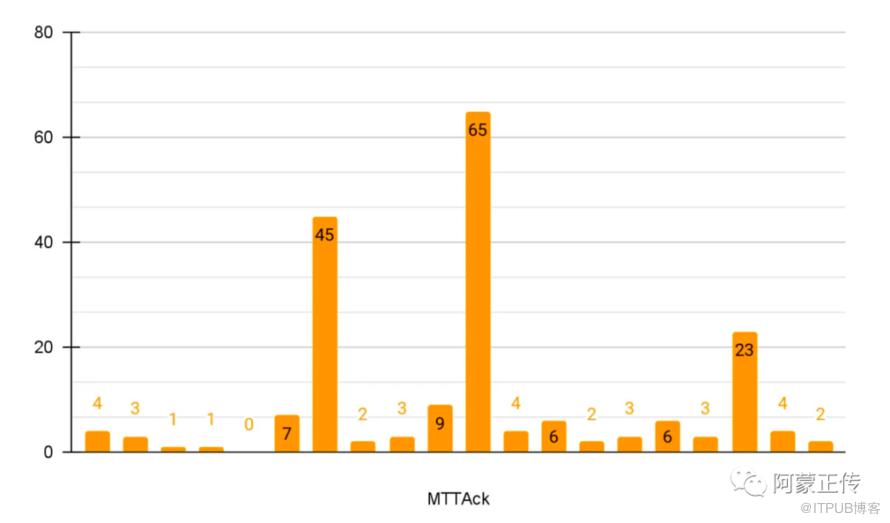
您可以看到,有时候接收警报的人花费了很长时间来确认警报。看起来优化的努力应该开始关注这些异常值。但是这个数据集的平均MTTAck时间少于10分钟,这可能是可以接受的。聚焦于百分位数告诉了不同的故事:
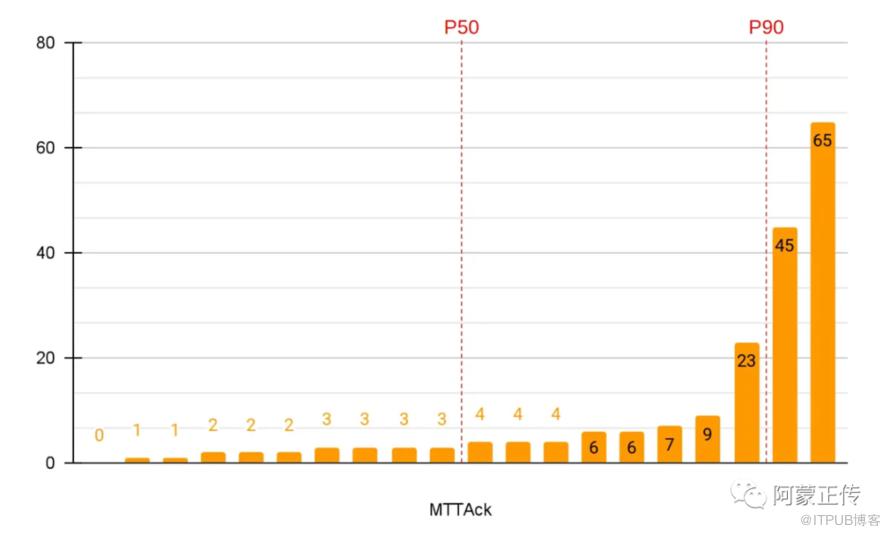
为了计算百分位数,数据按升序排列,将异常值放在最后。现在问题就是选择一个阈值来指导我们的关注点。在上面的数据集中,如果我们将阈值放在P90百分位数上,异常值就会显得非常突出。
使用百分位数可能有些复杂,需要提前进行一些教育来明确概念,但是它确实可以用来发现问题。
Look back window - 回顾窗口
MTTR* 是针对回顾窗口计算的,例如一周、一个月、季度等。在优化 MTTR* 时,可以将其与之前的回顾窗口进行比较以查看差异。例如,这是最近优化的假设服务的 MTTRecover:
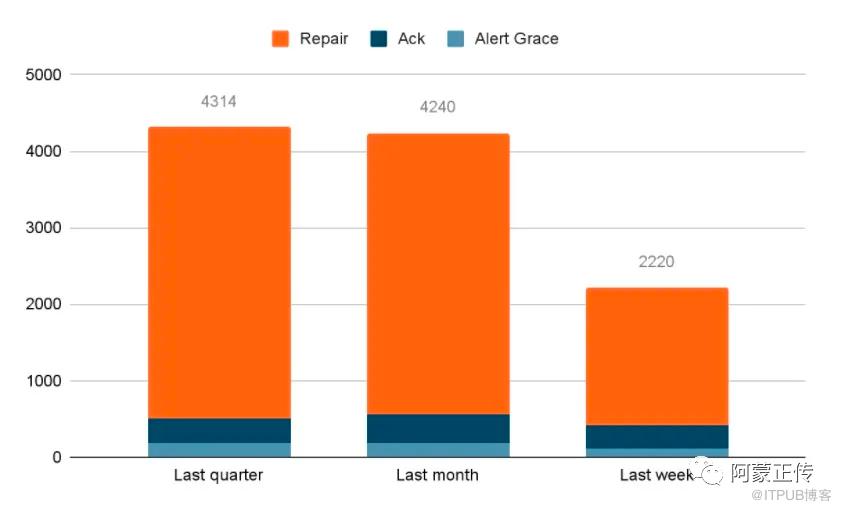
在这个例子中,我们可以看到虽然警报宽限期和等待确认没有显着变化,但与上个月和上个季度相比,修复阶段投入的精力实际上显着减少了 MTTRecover。
影响程度
并非所有故障都是平等的。根据影响不同,他们可能有不同的紧迫感。例如:
• Level 1:影响所有客户(例如网站已关闭)
• Level 2:影响一些客户(例如,iOS 应用程序不起作用,但WEB和 Android 可以)
• Level 3:影响一小部分客户(例如,旧版 iOS 应用程序无法运行或网站在已弃用的 IE6 上无法运行)
• Level 4:偶尔影响客户(例如,一项服务的错误率很高,但大多数客户都有重试机制)
根据影响程度,对故障的关注和精力可能会有所不同。虽然 1 级和 2 级故障可能需要在半夜叫醒值班人员,但 4 级故障可能只需要创建工单以便在工作时间处理就行。
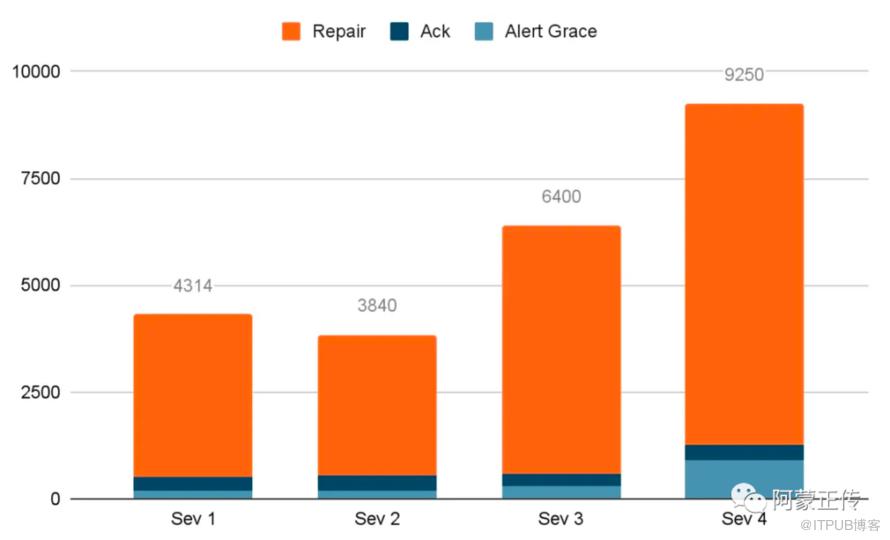
在测量和优化指标时,区分不同的影响级别以将精力集中在最具影响力的事件类型上非常重要。如果不做分级,只是盲目地去优化MTTResolve,这样会导致不必要的成本浪费。
以下是过去一个季度使用 SEV 术语的假设系统的 MTTRecover:
结论
让我们把它们放在一起,这是我们讨论过的所有指标的备忘单:
原文地址:https://www.infoq.com/articles/mtt-metrics-incident-response/
1. 原文链接: https://www.infoq.com/articles/mtt-metrics-incident-response/
2. (Attlassian) MTBF、MTTR、MTTA 和 MTTF https://www.atlassian.com/incident-management/kpis/common-metrics
3. Being On-Call https://sre.google/sre-book/being-on-call/
4. Incident Response https://sre.google/workbook/incident-response/
5. mean time to detect (MTTD) https://searchitoperations.techtarget.com/definition/mean-time-to-detect-MTTD
6. Mean Time To Resolve (MTTR) as a Service Desk Metric https://www.bmc.com/blogs/mttr-mean-time-to-resolve/
7. Why You Should Embrace Incidents and Ditch MTTR https://devops.com/why-you-should-embrace-incidents-and-ditch-mttr/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70041260/viewspace-3032753/ ,如需转载,请注明出处,否则将追究法律责任。

