
各位小伙伴儿,大家好哈。
今天我们来聊聊重删和压缩,这两个技术是目前最有效节约存储空间的技术,普遍应用在主存、闪存、备份软件和数据传输软件中。
那么数据重删和压缩技术区别是什么,在主存储和闪存中是如何实现的?
对于经常感觉存储爱情动作小电影硬盘空间不足的同学,今天的内容需要打起十二分精神来学习了。
▉ 重删和压缩到底是什么?
我们先来看看什么是重删,重删全称重复数据删除(Deduplication)是一种数据缩减技术。
在重删出现之前,人们发现在存储过程中,有大量的重复数据存在,这部分数据既占用传输带宽还消耗了相当多的存储空间,如果对所有相同的数据块都只保留一份实例,那么存储空间将大大减少--这就是重复数据删除技术的基础,其原理如下所示。
简单来说,重删就是说有很多分相同的数据,我只存储其中一份,其他的重复数据块我保留一个地址引用到这个唯一存储的块即可。
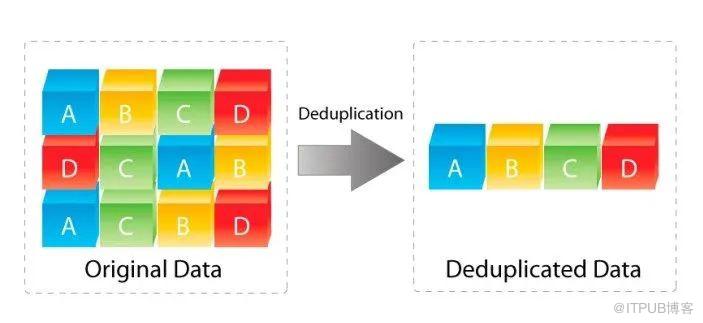
通过重删技术可以有效提高存储效率和利用率,数据可以缩减到原来的1/20~1/60。这种技术可以很大程度上减少对物理存储空间的需求,减少传输过程中的网络带宽,有效节约设备采购与维护成本。同时它也是一种绿色存储技术,能有效降低能耗。
压缩(Compression)技术的的起源可以追溯到信息论之父香农(Shannon)在1947年提出的香农编码。其原理就是将一个大字符串中的子串用一个很简短的数字来标记,然后检索该字符串出现的位置,用个简单的字符来替代。从而来减少数据表达所需要的空间,带来空间节省。
打比方来说,用1代表“AB”,用2代表“BC”,然后用255 来代表“Inside”。1到255只需要8个bit,而“AB”“CD”或者“Inside”则需要很多的空间,这样多次扫描替代之后,就可以快速的将数据缩减压缩。
用通俗的话说:重删就是讲相同的东西只存储一次,而压缩则是改造数据排布用一种算法来统计数据的排布模式,从而达到减少数据存储的模式。
重删和压缩通常会配合起来一起使用。如在备份场景中,为了提高数据的缩减效率,在数据经过重删之后会对唯一数据块再执行一次压缩。这样,数据的缩减效果就是重删和压缩效果的叠加。
▉ 重删和压缩是怎么实现的呢?
1.重删技术的实现
首先我们来看下重删是怎么来实现的?
重删一般分为文件级重删和块级重删,我们先看文件级重删,文件级重删理解起来比较简单,就比如我们的邮件服务器,我转发一份邮件给100个人,大家收到我的邮件后就会产生100个一样的文件,假设大家的数据盘使用的共享存储,存储只需要在每个人存入文件的时候查询一下这个文件本地有没有,有我就不再存储。这样在存储上就只存储了一个文件。

当然这只是一个最朴素的理解,那么在计算机里是怎么实现的呢?
在计算机里面有个技术名字叫做”指纹”,非常的形象生动,就好像每个人的指纹肯定不一样,那么我们是不是可以用一个很小的数据来标记一个文件的唯一信息。这里有很多的算法可以快速的得到一个唯一值,比如说MD5算法、Sha算法。
比较两个数据是否相同,就可以通过计算他的指纹,然后去对比指纹,而不是进行数据的逐字节比对。效率要高得多。
如果不是文件,块存储该怎么处理?
块级重删的基本原理就是对写入的数据按照固定长度进行切片,切片后进行hash计算,然后进行写入处理,非重复数据就单独写入,重复数据就写入引用即可。
块级重删有两种方式,定长重删和变长重删。定长重删将数据按照固定长度进行分块,之后进行重删。例入一个文件大小为128M,按照128K来切,切完就是一千份的子文件,然后对这一千份进行对比,把重复数据去掉就是定长重删。

但是这种处理方式重删率是比较低的,比如说一个文件,我们只在文件上添加一个字符,然重新写入,这个文件采用定长方式切片后就无法找到和以前相同的块,导致无法被重删掉数据。因此业界也有很多的变长重删的算法。
变长重删将数据划分成不同大小的块进行重删,一般来说变长重删可以获得更好的重删效果,因为对企业来说数据是不断更新的。比如定长重删下数据被切割形成一系列字母组合,由于数据变化插入了一个字母,因此整个数据的顺序就改变了,再按照128K切的话,对于备份软件来说所有行都是一个全新的数据块,所以要重新做备份。而变长重删可以保证其余的数据块不变,只在新增字母的块增加一个大小上限就可以了,因此变长重删效率更高。
但是变长重删对性能和算法要求都比较高,同时对于CPU内存消耗也大,影响了数据的实时处理效率。毕竟存储主要还是处理主机的IO读写响应的。只有在备份归档领域用的比较多,因为这个场景节省空间比快速响应要求高的多。
以下面这个图片为例,变长重删效率可能达到10:1,而定长重删只有3:1。
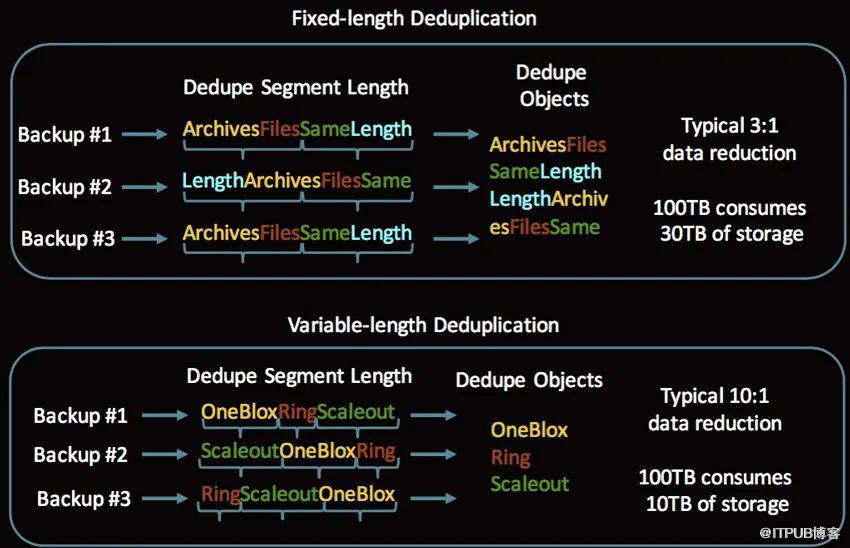
因此,对于全闪存存储这种响应要求高的,建议定长重删,速度快。对于归档、备份这种冷存储建议变长重删,重删率高节省成本。
值得注意的事,其实重删这个功能在全闪存市场用处并不大,因为很多时候定长重删的效果很有限,比较典型的比如数据库场景,重删率只有可怜的1.05:1几乎可以忽略不计。对于全闪存来说压缩更有效,下面我们来看看压缩技术。
2.压缩技术的实现
压缩技术由来已久,分为无损压缩和有损压缩。
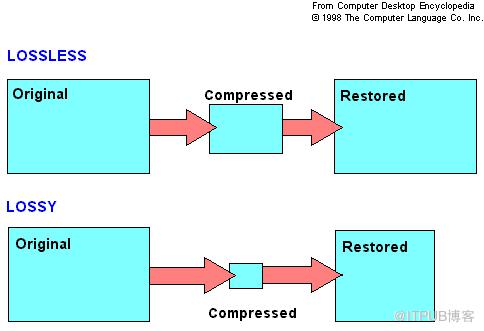
有损压缩主要用于图像处理领域,比如说我微信发一个照片,明明本地10M的高清图片传输到朋友手机里面就有300K的图片。这主要为了节省网络传输的流量以及微信存储空间节省。
存储系统领域用的压缩都是无损压缩。借助于算法的普及,业界主流存储厂商的压缩实现几乎都没有算法上的区别,只是在于压缩的实现选择上,主要考虑兼顾性能和数据缩减率。
基于EMC Unity Sizer的性能评估工具,我们大概可以看到开启压缩相对于不开启压缩,IOPS从20万左右降低到了12万,存储性能下降大概是40%。
其实在intel CPU里面已经集成了压缩算法,我上次私下里和我们测试经理进行了数据的了解,在开启压缩,满负载的进行存储性能压力测试,存储CPU利用率75%的时候,其中用于压缩所消耗的CPU资源不到3%。
为什么存储性能下降了这么多?
我们知道, 传统的存储,不需要压缩的时候,我们每个数据都是由自己在硬盘上的固定地址的。记录这些数据存储的位置的方式非常简单。我只需要记录一共由几块盘,一共组成了几个RAID组,每个RAID条带深度是多少,起始地址是多少,就能在内存中快速的用这些基本数据算出数据对应的物理地址是多少。这种基本的写入模式叫做COW(copy on write),就是说写前拷贝。
由于压缩后一个8KB的数据有可能变成了1Kb、2KB、3KB也可能是8KB,那么我的数据就是一个可变的长度,如果还采用物理地址和逻辑地址一一对应的方式我就达不到节省空间的效果了。我将一个8KB的块压缩成了1KB,结果你还是给我分配了8KB物理空间来存储,这简直就是不合适。因此在压缩的实现上,存储一般都采用ROW架构来实现。
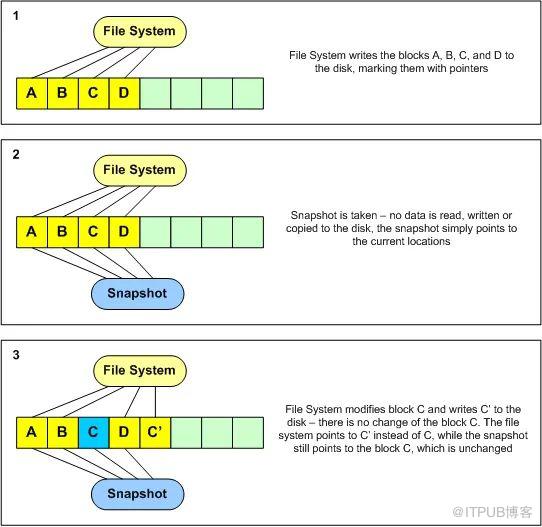
由于ROW架构每个块都需要单独存储一次地址的映射关系,所以容量越大,产生的元数据量也越大,所以ROW架构一般容量越大,性能越差。为了更好的处理数据,肯定想元数据全部在内存中缓存是效率最好的,所以ROW架构存储对内存的诉求很大。
同时,由于ROW架构每次写入都需要记录地址元数据,处于可靠性考虑,我们肯定需要持久化,每次都要元数据下盘,这样一次写入就会产生两次的操作,写入元数据,写入数据。
并且由于ROW架构的数据写入采用了新找地址写入,这样原来逻辑上连续的数据会被不断的离散化,最终连续IO也会变成随机IO,对性能影响较大
ROW带来了另一个问题,以上图为例,我们如果没有快照,那么C这个数据块就是一个无效的数据,但是我们并不会在写入的时候立即的删除这个数据,因为会影响性能。我们就需要在没有连续空间或者业务空闲的时候专门来处理这些失效的块。这个也就是我们经常所说的垃圾回收,垃圾回收对性能影响很大,很多厂商干脆就不回收,而采用直接填空写入的方式。不管哪种方式对于垃圾空间的重复利用是对性能影响极大的一个操作。
这些问题在传统硬盘场景影响更为明显,这也是以前Netapp在HDD时代性能被诟病的一个原因。
而SSD盘内部的数据处理也是类似,SSD中开启垃圾回收导致的性能下降被称之为“写悬崖”

压缩对于存储性能带来的冲击,根本不是来自与压缩本身,而是由于实现压缩的架构而带来的影响。
按照当前业界主流存储厂商的软件架构和效率来评估,一般ROW架构的存储相对于COW架构在性能上大概要下降35%左右,而压缩本身带来的性能损失一般在5%以内,所以对于整个存储系统来说,开启压缩性能下降幅度大概在40%左右。
目前,很多存储厂商在产品宣传时也将性能无损压缩当成产品的一个两点。在PowerStore的官方资料中,就提到可以实现无损4:1的数据缩减能力,这在业界应该属于非常领先的一个能力,能够在不影响性能的情况实现这个缩减比率是非常出色的。
▉ 重删和压缩的珠联璧合
数据压缩与重复数据删除两种技术具有不同层面的针对性,并能够结合起来使用,从而实现更高的数据缩减比例。
值得一提的是,如果同时应用数据压缩和重复数据删除技术,为了降低对系统的处理需求和提高数据压缩比率,通常需要先应用数据删除技术,然后再使用数据压缩技术进一步降低"结构图"和基本数据块的体积。
如果顺序颠倒会出现什么样的结果呢?
压缩会对数据进行重新编码,从而破坏了数据原生的冗余结构,因此再应用重复数据删除效果则会大打折扣,而且消耗时间也更多。而先执行重复数据删除则不同,它首先消除了冗余数据块,然后应用数据压缩对唯一副本数据块进行再次压缩。
这样,两种技术的数据缩减作用得到叠加,而且数据压缩的消耗时间大大降低。因此,先去重后压缩,可以获得更高的数据压缩率和性能。


原文作者:了不起的云计算;如有侵权,请联系管理员删除。

