1.样例数据
有数据表t_sample包含ID,type,val三个字段1~10000行数据,type为随机分配的1~3,val为0~1的随机数;其中根据ID进行分10个桶;
建表语句和数据生成语句如下:
set hive.enforce.bucketing=true;
-- 建表语句
CREATE TABLE t_sample (
  id bigint,
  type bigint,
  val double
)
CLUSTERED BY (id) INTO 10 BUCKETS
STORED AS ORC;

--数据插入
insert into t_sample(id,type,val)
select ind+1 as id,floor(rand()*3)+1 as type,rand() as val from(select split(space(9999),'') as a) t lateral view posexplode(a) tt as ind,space_val;
样例数据查看
+-------+-------+----------------------+
|  id   | type  |         val          |
+-------+-------+----------------------+
| 1928  | 1     | 0.8149664325591012   |
| 4320  | 3     | 0.41168841833279834  |
| 5323  | 2     | 0.40307445813137033  |
| 9731  | 1     | 0.2036838175568444   |
| 3915  | 2     | 0.0226902346921094   |
| 659   | 3     | 7.92836807809949E-4  |
| 1299  | 3     | 0.3501926828217895   |
| 2976  | 1     | 0.7974942217644628   |
| 6173  | 3     | 0.2531007613722899   |
| 7462  | 1     | 0.14091100049939698  |
+-------+-------+----------------------+
2.随机抽样
2.1 随机抽取N行
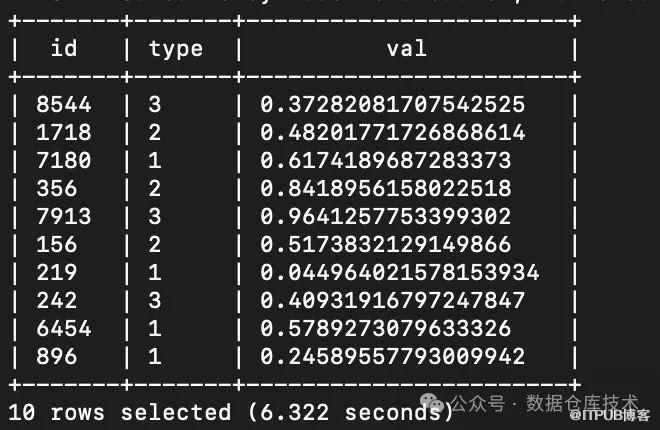
如何随机抽取N行,假设N=10.我们使用rand()函数新生成一列,根据rand()值进行排序,正序倒序均可,然后使用limit限制10行即可。
实现SQL
select
id,
type,
val
from t_sample
order by rand() asc
limit 10
为了验证是随机的,我们执行多次,结果应该是不一样的,这里我们执行两次,下面是结果

2.2抽取一定比例数据(大致)
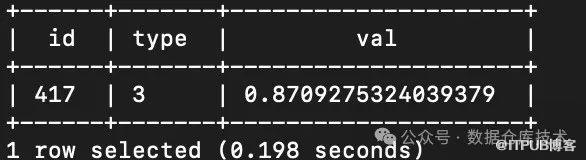
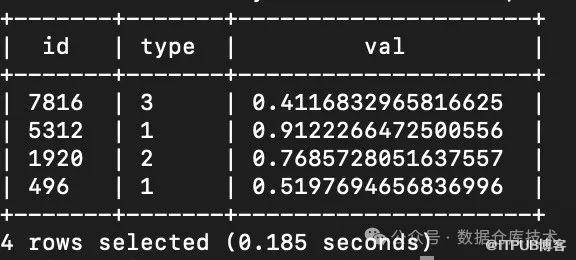
假设我们不知道总行数,抽0.05%的数据。依旧使用rand()函数,我们知道rand()是随机生成的0~1的数据,所以我们认为如果rand()值小于0.0005 则是抽取的对应比例的数据。当数据量越大的时候,数据也越准确 。所以这里是一个大致结果。因为我们知道数据行数为10000,理论上应该是5条,但是由于我们的数据量比较小,应该会有比较大的偏差。我们还是执行2次,看下结果.
实现SQL
select
id,
type,
val
from t_sample
where rand()<=0.0005
查询结果
2.3抽取一定比例数据 (精确)
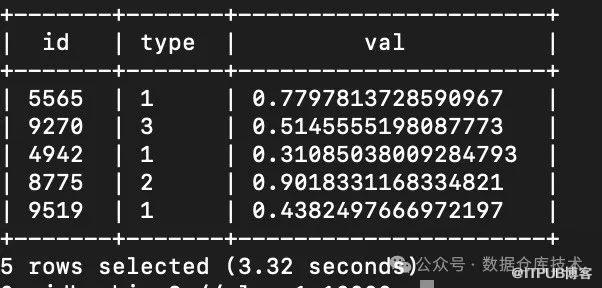
如果我们想要精确地抽取对应比例的数据,该怎么办呢?首先需要统计出总的行数cnt,然后使用row_numer()开窗,根据一个rand()进行排序生成序号rn,然后rn/cnt<=0.0005即可。
实现SQL
select
id,
type,
val
from
(select
id,
type,
val,
row_number()over(order by rand()) as rn,
count(1)over() as cnt
from t_sample) t
where rn/cnt <=0.0005
执行结果
2.4分组随机抽样 抽取N行
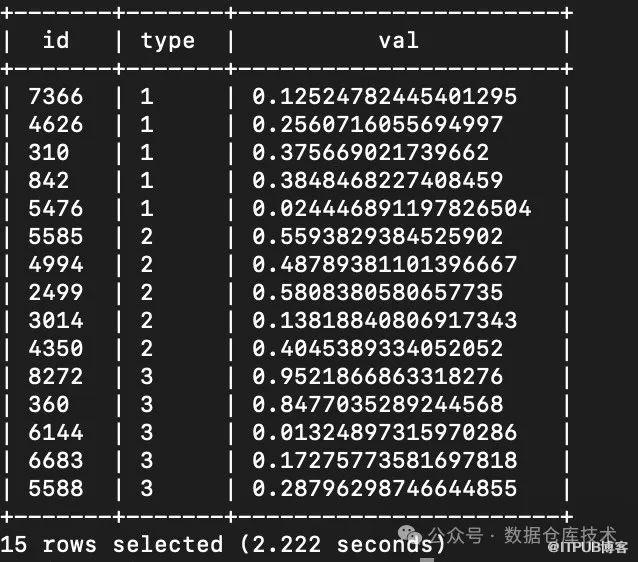
现在需求进一步增加,我们需要按照type进行分组,然后每组抽取5行数据。这里我们要进行分组排序:使用开窗函数row_number()根据type进行分组,根据rand() 进行排序,然后得到序号rn,限制rn<=5即可。
实现SQL
select
id,
type,
val
from
(select
id,
type,
val,
row_number()over(partition by type order by rand()) as rn
from t_sample)t
where rn <= 5
执行结果
3.分箱抽样
我们假设按照ID进行分箱,共分成5箱,每箱随机抽取2个值。这里我们使用ntile来进行分箱n_box,然后根据n_box进行分组,每组抽取随机抽取2个值。为了方便查看我在sql最后加了按照id排序;
实现SQL,
select
id,type,val
from
(select
id,type,val,n_box,
row_number()over(partition by n_box order by rand()) as rn
from
(select
id,type,val,ntile(5)over(order by id) as n_box
from t_sample
)t
)tt
where rn <=2
order by id asc
执行结果
4.数据块抽样
4.1整体数据块抽样
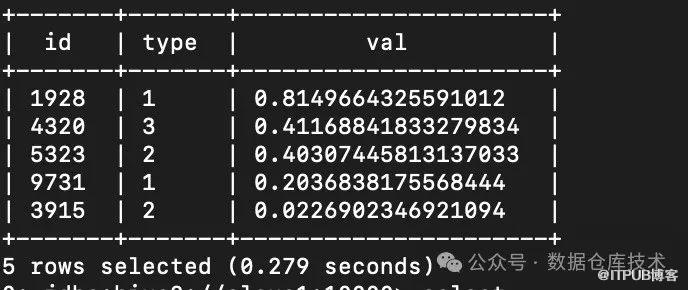
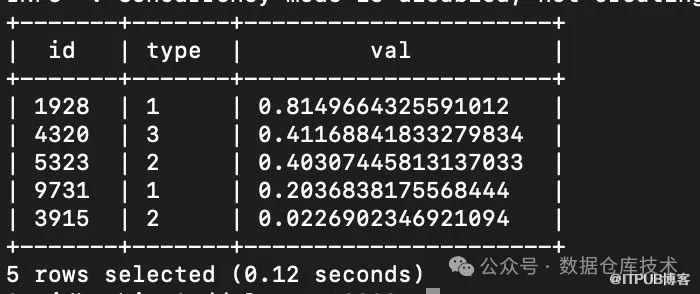
使用tablesample进行数据块抽样,指的是抽取一块数据。这里不能保证数据的随机性,因为获取数据就是头开始连续获取要的数据内容。我们可以看到多次执行同一个SQL,返回的结果是一致的。例如我抽取5行数据。
实现SQL
select
id,
type,
val
from t_sample
TABLESAMPLE (5 rows)
两次执行结果
4.2分桶数据块抽样
分桶数据块抽样,同样有数据块抽样的特点,但是指定了抽取那个桶的数据。如果总的桶数量和默认表内桶数量一致,则直接从原有桶内抽取指定桶内数据,否则对表内数据重新分桶抽取。
查询SQL
select
id,
type,
val
from t_sample
TABLESAMPLE (BUCKET 1 OUT OF 10)
limit 10
本文同步在微信公众号”数据仓库技术“和个人博客”数据仓库技术“发表。原文: 同时有“数据仓库技术”社群以及有几十位小伙伴一起讨论数据仓库相关技术,关注公众号,后台回复“加群”,添加好友加入;
原文作者:数据仓库技术;如有侵权,请联系管理员删除。

