样例数据:我们创建一张hive表 t_box,包含两列(id,val), 其中id为1~1000,val 为随机数浮点数。
分箱(Binning)是一种数据预处理技术,它将连续的数据划分为离散的区间或“箱子”。这种方法在数据分析、统计学和机器学习中非常常见,尤其是在处理大规模数据集时。在数仓或数据分析常用以下三种”分箱”方式
1.基于规则的分箱
基于规则的分箱是一种数据预处理方法,它根据预先定义的规则或标准将数据点分配到不同的箱子(或区间)中。这种方法通常涉及到对数据的业务理解和特定领域的知识。以下是基于规则分箱的一些关键特点和步骤:
特点:
我们假设规则:(0~0.4] 为1组,(0.4~0.6]为2组,(0.6~1)为3组
实现SQL:
selectid,val.case when val >0 and val <= 0.4 then 1when val >0.4 and val <= 0.6 then 2when val >0.6 and val <1 then 3 end as box_indxfrom t_box
样例结果

根据分箱box_indx统计
with t as (selectid,val,case when val >0 and val <= 0.4 then 1when val >0.4 and val <= 0.6 then 2when val >0.6 and val <1 then 3 end as box_indxfrom t_box)selectbox_indx,count(1)from tgroup by box_indx
查询结果
2.等距分箱
等距分箱是一种将连续数值数据分布到固定数量的等间隔区间的方法。在等距分箱中,数据的整个范围被均匀地分割成若干个箱子,每个箱子的宽度(即间隔)是相同的。
等距分箱的关键特点:
n个箱子,每个箱子的宽度是相同的。我们假设规则:分为3组
实现SQL
selectid,val,ceil(if((val-min_val)=0,1,(val-min_val)/((max_val-min_val)/3))) as box_indxfrom t_boxjoin(selectmin(val) as min_val,max(val) as max_valfrom t_box) t1
样例结果
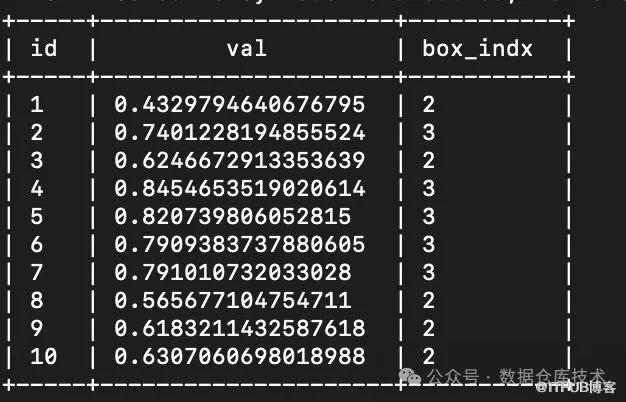
根据分箱box_indx统计
with t as (selectid,val,ceil(if((val-min_val)=0,1,(val-min_val)/((max_val-min_val)/3))) as box_indxfrom t_boxjoin(selectmin(val) as min_val,max(val) as max_valfrom t_box) t1)selectbox_indx,count(1)from tgroup by box_indx
统计结果
3.等频分箱
等频分箱是将数据集划分为具有相同数量的区间或“箱子”。这种方法的目标是确保每个箱子中包含的数据点数量大致相同,而不是像等距分箱那样将数据范围均匀分割。等频分箱在处理具有不同密度区域的数据集时特别有用,因为它可以更好地反映数据的实际分布。
等频分箱的关键特点:
我们假设规则:分为3组
实现SQL
selectid,val,ntile(3)over(order by val asc) as box_indxfrom t_box
样例结果
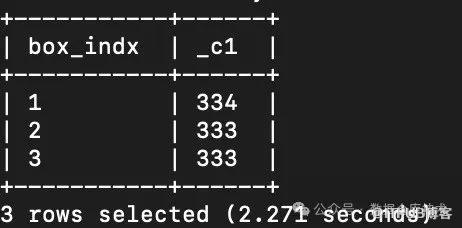
根据分箱box_indx统计
with t as (selectid,val,ntile(3)over(order by val asc) as box_indxfrom t_box)selectbox_indx,count(1)from tgroup by box_indx
查询结果
建表语句及数据插入语句
--建表语句create table if not exists t_box (id bigint,val double)ROW FORMAT DELIMITEDFIELDS TERMINATED BY ','STORED AS orc;--数据插入insert into t_box(id,val)select ind+1 as id,rand() as val from(select split(space(999),'') as a) t lateral view posexplode(a) tt as ind,space_val;
本文同步在微信公众号”数据仓库技术“和个人博客”数据仓库技术“发表。原文:
微信社群“数据仓库技术”有几十位小伙伴一起讨论数据仓库相关技术,关注公众号后台回复“加群”,添加好友加入;
原文作者:数据仓库技术;如有侵权,请联系管理员删除。

