非关系型数据库的分类与特点
随着数据量呈指数级增长和数据类型日益多样化,传统关系型数据库在处理海量非结构化数据时面临着严峻挑战。非关系型数据库(NoSQL)应运而生,它摒弃了传统关系模型的约束,采用更灵活的数据存储方式,为大数据时代的多样化需求提供了解决方案。
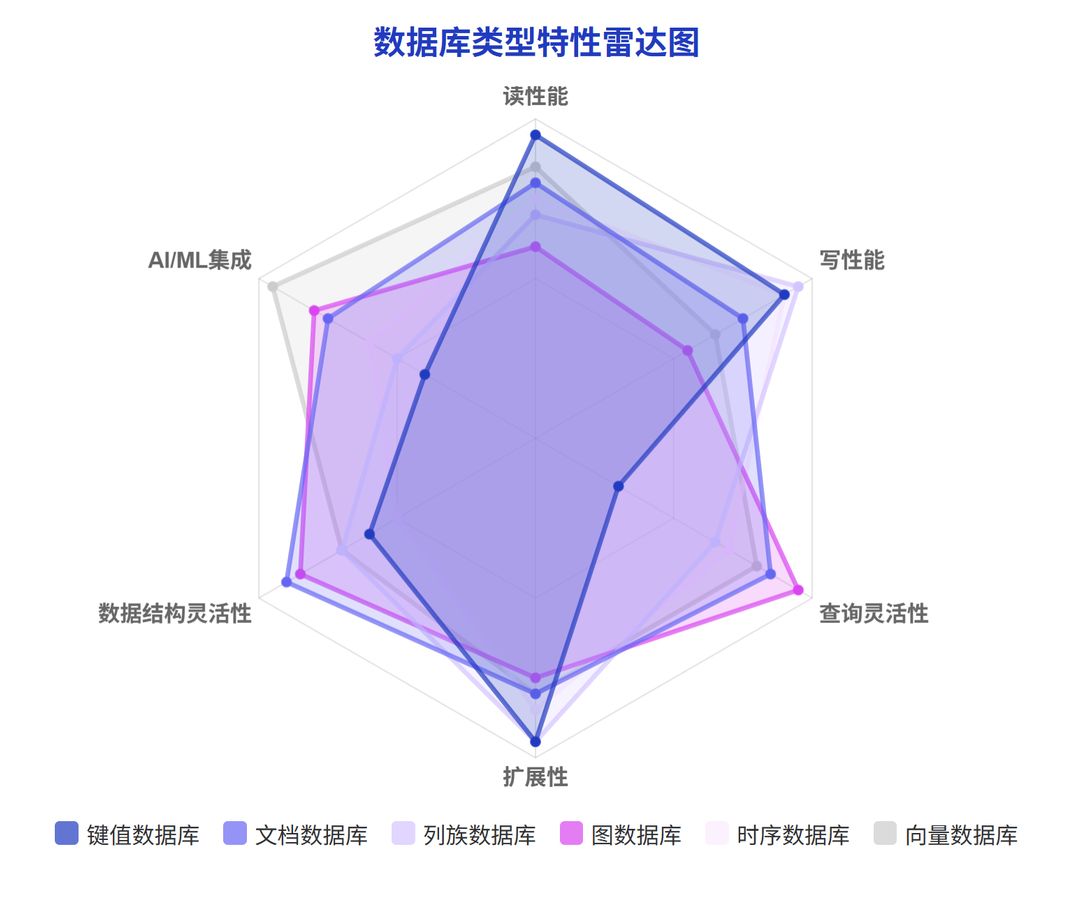
2025 年,非关系型数据库已经发展成为数据基础设施的重要组成部分,根据其数据模型和存储特点,可以将非关系型数据库分为以下几大类型:
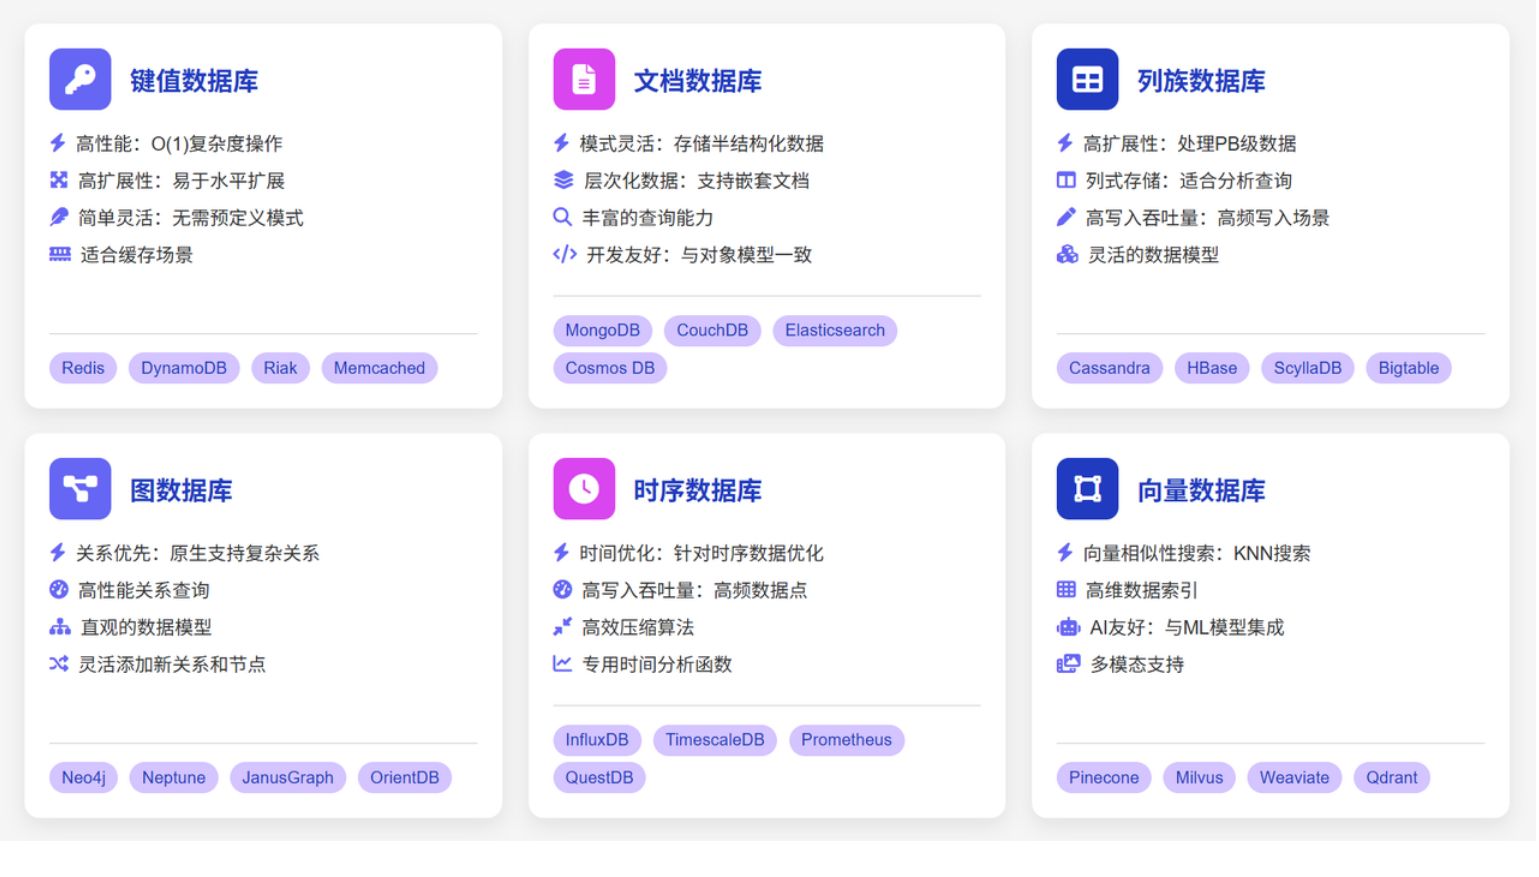
键值(Key-Value)数据库
键值数据库是最简单直观的非关系型数据库类型,它将数据存储为键值对的集合,类似于哈希表结构。每个键都与一个且仅一个值相关联,通过键可以快速访问对应的值。
主要特点:
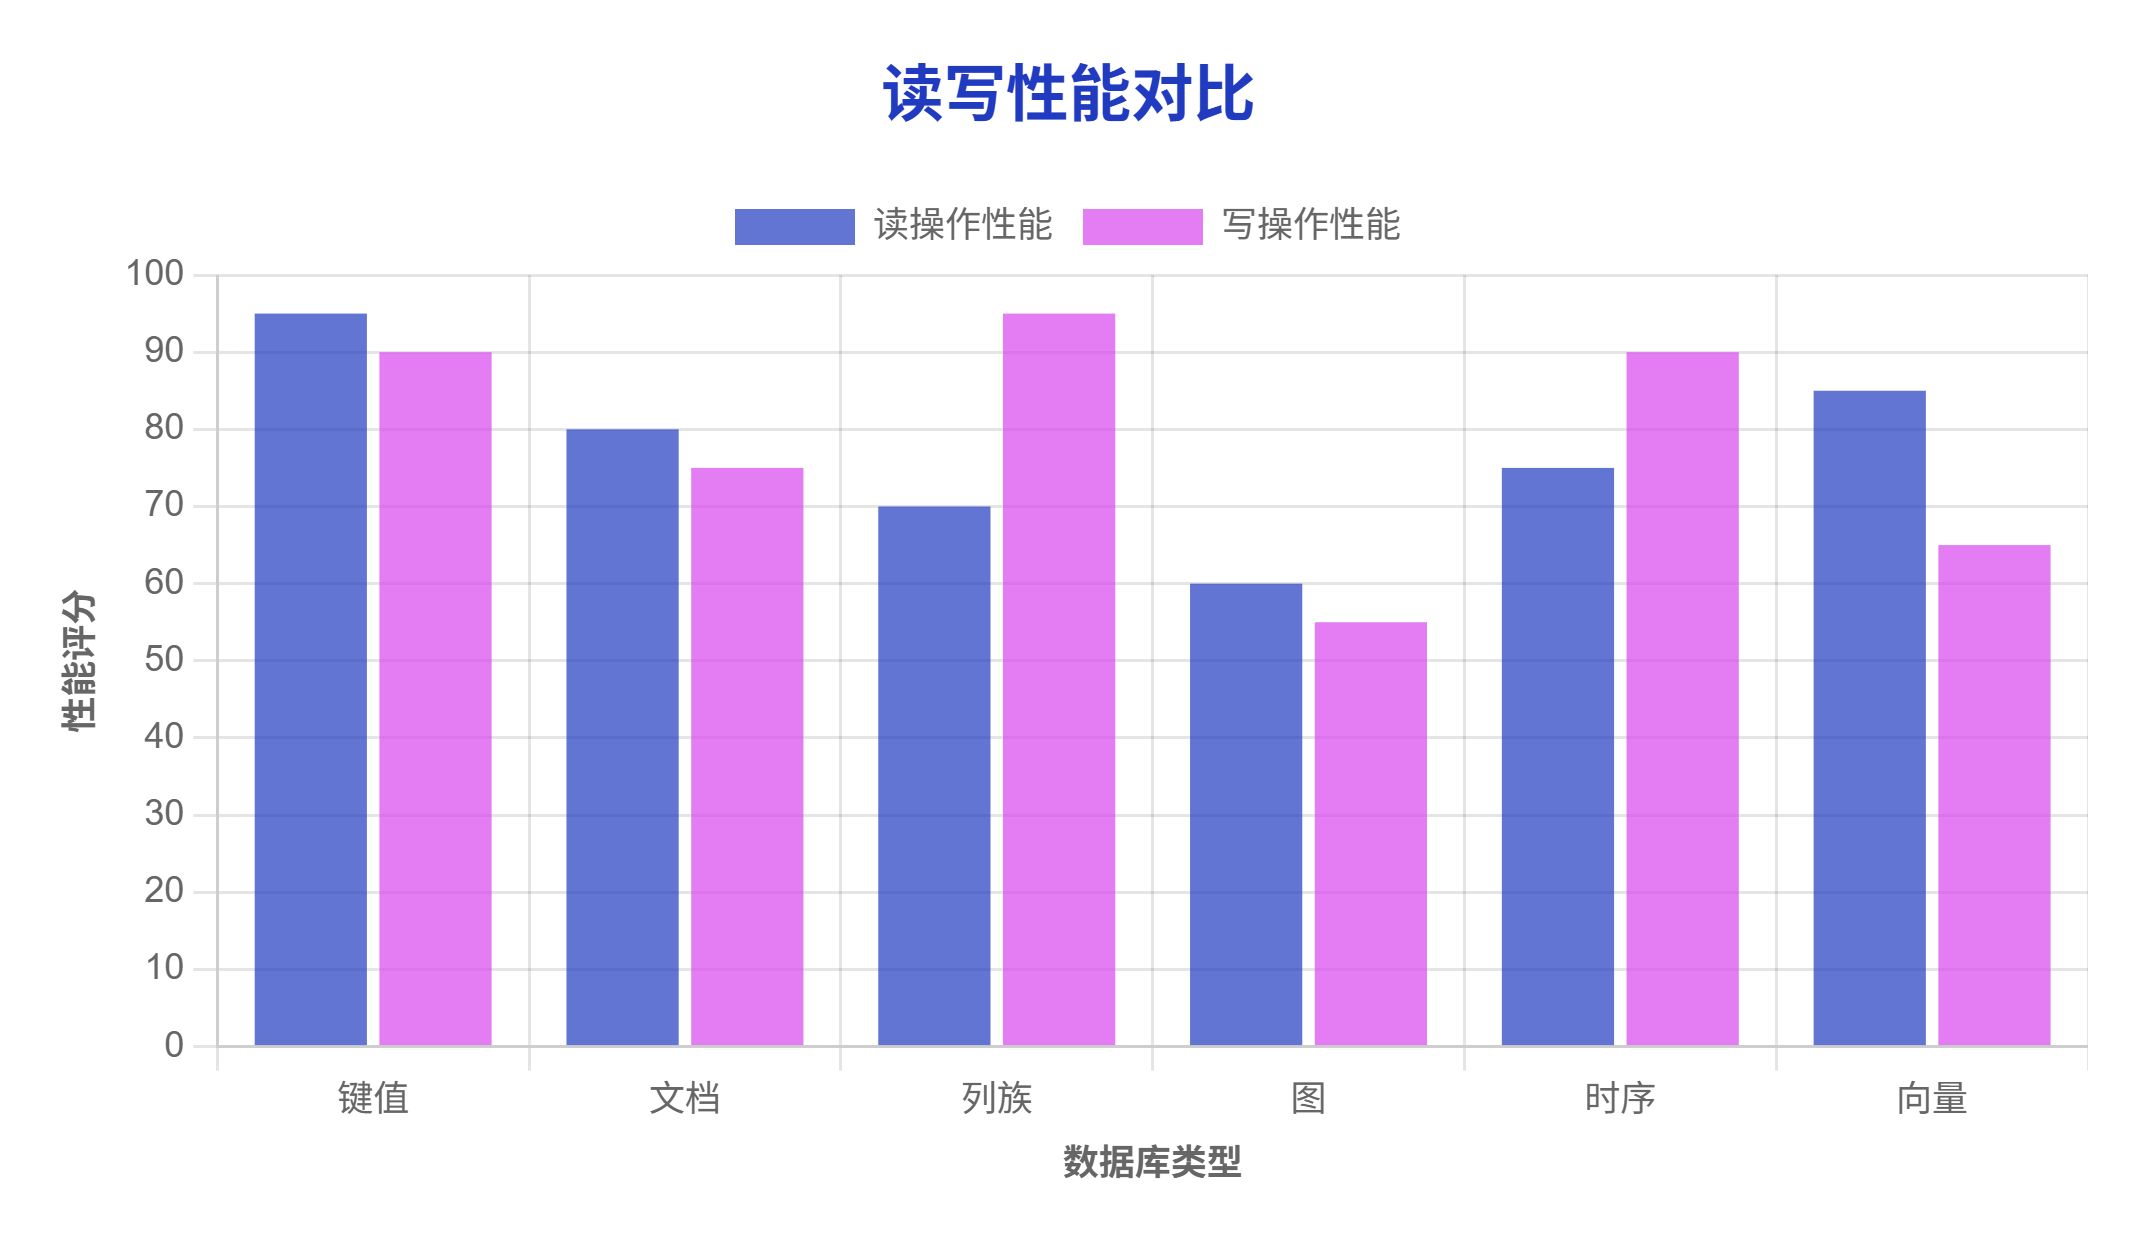
- 高性能:提供极快的读写速度,通常是 O(1)复杂度的操作
- 高扩展性:易于水平扩展,支持分布式架构
- 简单灵活:无需预定义模式,可存储任意类型的值
- 适合缓存场景:常用于会话管理、用户配置存储等
代表产品:
- Redis、 DynamoDB 、Riak、 Memcached
文档(Document)数据库
文档数据库将数据存储在灵活的、类似 JSON 的文档中,每个文档可以有不同的结构,字段可以随时添加、删除或修改,无需预先定义模式。
主要特点:
- 模式灵活:无需预定义结构,可存储半结构化数据
- 层次化数据:支持嵌套文档和数组,适合表示复杂关系
- 丰富的查询能力:支持字段、全文和地理空间查询
- 开发友好:文档结构通常与应用程序对象模型一致
代表产品:
- MongoDB、CouchDB、 Elasticsearch 、 Azure Cosmos DB
应用场景:
文档数据库特别适合存储和管理半结构化数据,如:内容管理系统、用户档案、产品目录、实时分析应用等。2025 年,随着 AI 应用的普及,文档数据库在存储和检索非结构化内容方面发挥着关键作用,特别是在 RAG(检索增强生成)系统中作为知识库的基础设施。
列族(Column-Family)数据库
列族数据库采用列式存储模式,将相关的列组织在一起形成列族,适合处理大规模稀疏数据。这种设计使得列族数据库在读取特定列时非常高效,特别适合分析型工作负载。
主要特点:
- 高扩展性:设计用于处理 PB 级数据,易于水平扩展
- 列式存储:按列而非按行存储数据,适合分析查询
- 高写入 吞吐量:优化的写入路径,适合高频写入场景
- 灵活的数据模型:同一表中不同行可以有不同的列
代表产品:
- Apache Cassandra 、HBase、ScyllaDB、Google Bigtable
应用场景:
列族数据库特别适合时间序列数据、推荐系统、风险检测、IoT 数据存储等需要处理大量写入并按特定维度进行分析的场景。在 2025 年的数据湖架构中,列族数据库常作为原始数据的高效存储层,为上层分析提供基础。
图(Graph)数据库
图数据库专为存储和查询高度互联的数据而设计,它使用节点、边和属性来表示和存储数据,使复杂关系的查询变得简单高效。
主要特点:
- 关系优先:原生支持复杂关系的存储和查询
- 高性能关系查询:相比关系型数据库,在多级关系查询上性能优越
- 直观的数据模型:数据结构与现实世界的关系模型一致
- 灵活性:易于添加新类型的关系和节点
代表产品:
- Neo4j 、Amazon Neptune、JanusGraph、OrientDB
应用场景:
图数据库特别适合社交网络分析、推荐引擎、欺诈检测、知识图谱、网络拓扑等需要处理复杂关系的场景。
时序(Time Series)数据库
时序数据库专为高效存储、检索和分析按时间索引的数据而设计,它针对时间戳数据进行了特殊优化,提供高效的写入和查询性能。
主要特点:
- 时间优化:针对时间序列数据的存储和查询进行优化
- 高写入 吞吐量:设计用于处理高频率的数据点写入
- 高效压缩:针对时间序列数据的特点提供高效压缩算法
- 专用函数:提供时间聚合、降采样等专用分析功能
代表产品:
- InfluxDB、TimescaleDB、Prometheus、QuestDB
应用场景:
时序数据库特别适合 IoT 数据存储、应用监控、金融市场数据、传感器数据分析等场景
向量(Vector)数据库
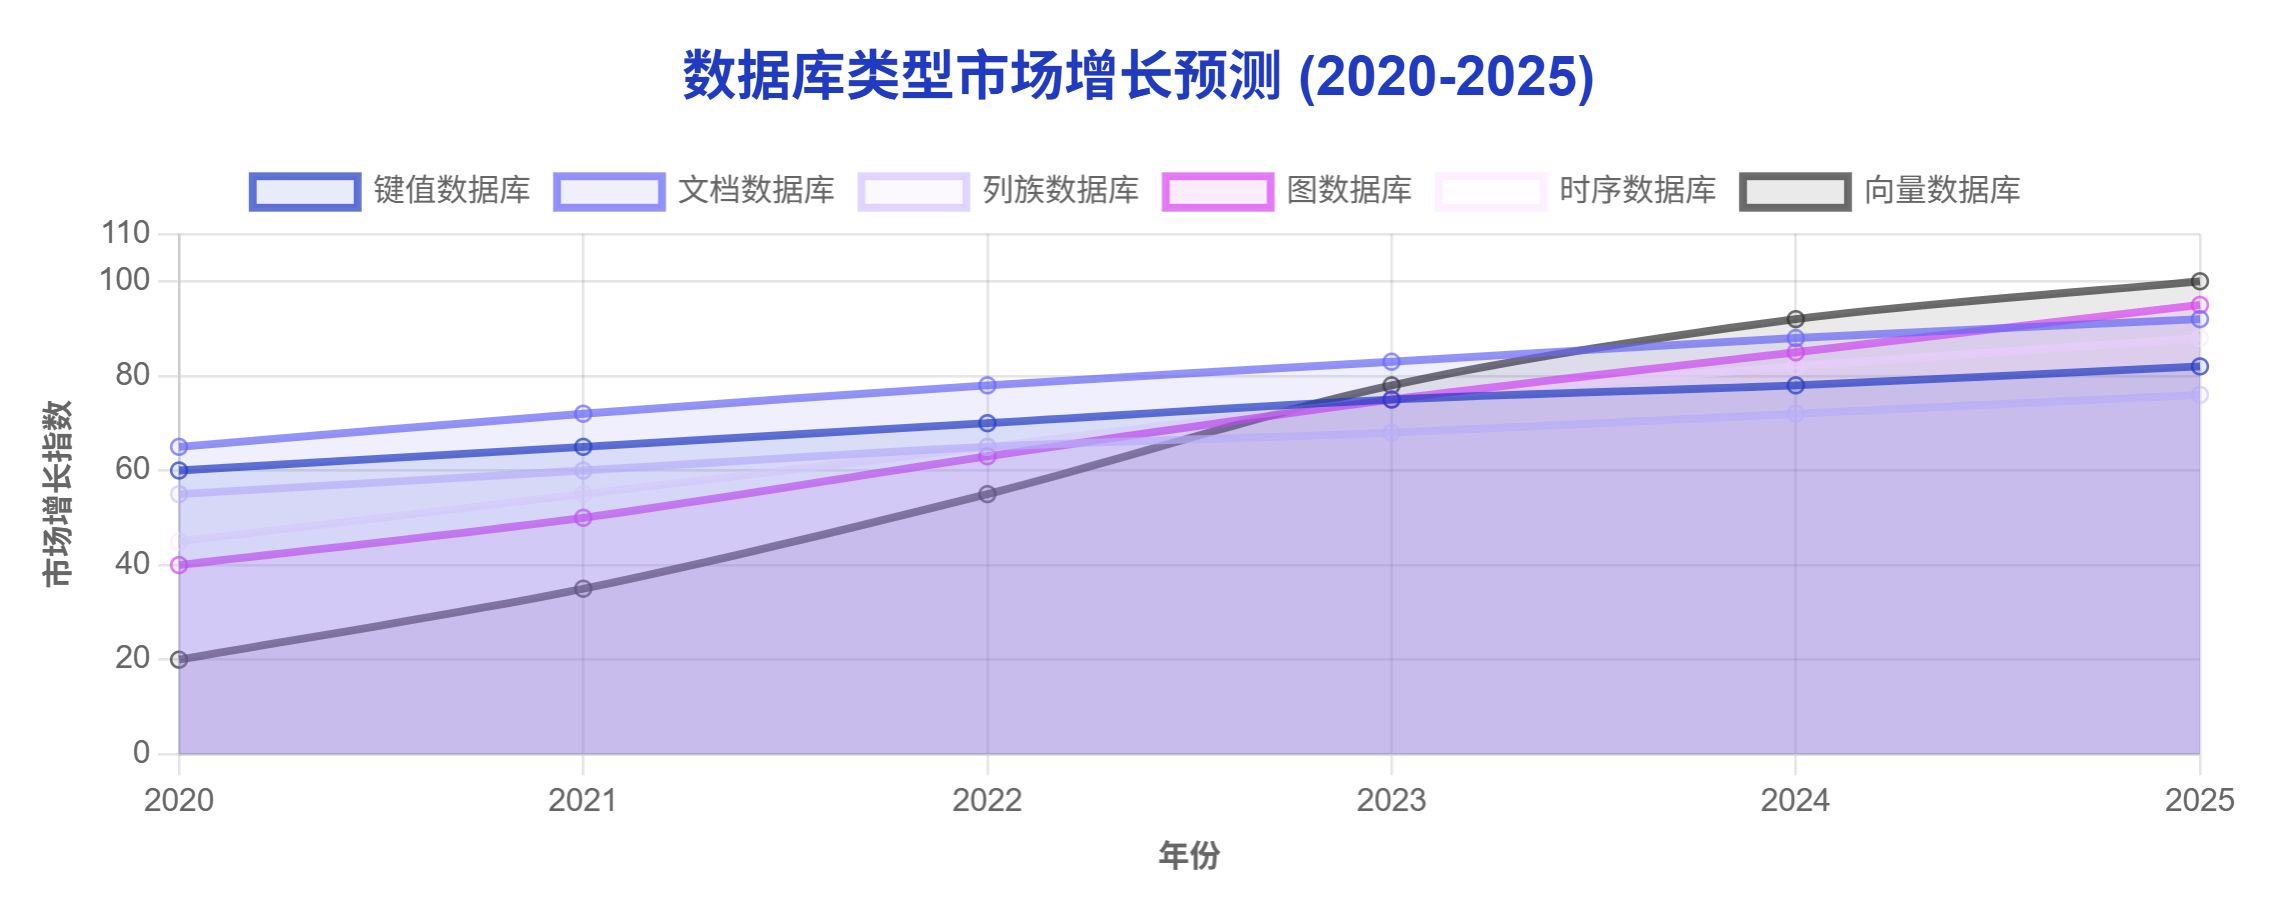
向量数据库是 2025 年最受关注的新兴数据库类型之一,它专为存储和检索高维向量数据而设计,主要用于支持机器学习和 AI 应用中的相似性搜索。
主要特点:
- 向量相似性搜索:高效执行 K 最近邻(KNN)搜索
- 高维数据索引:针对高维向量的特殊索引结构
- AI 友好:与机器学习和深度学习模型无缝集成
- 多模态支持:可处理文本、图像、音频等多种数据类型的向量表示
代表产品:
- Pinecone、Milvus、Weaviate、Qdrant
应用场景:
向量数据库在 2025 年的 AI 应用中扮演着核心角色,主要应用于语义搜索、推荐系统、图像识别、异常检测、RAG 系统等场景。
2025 年非关系型数据库发展趋势
随着数据量的爆炸性增长和应用场景的多样化,非关系型数据库技术在 2025 年呈现出几个明显的发展趋势:
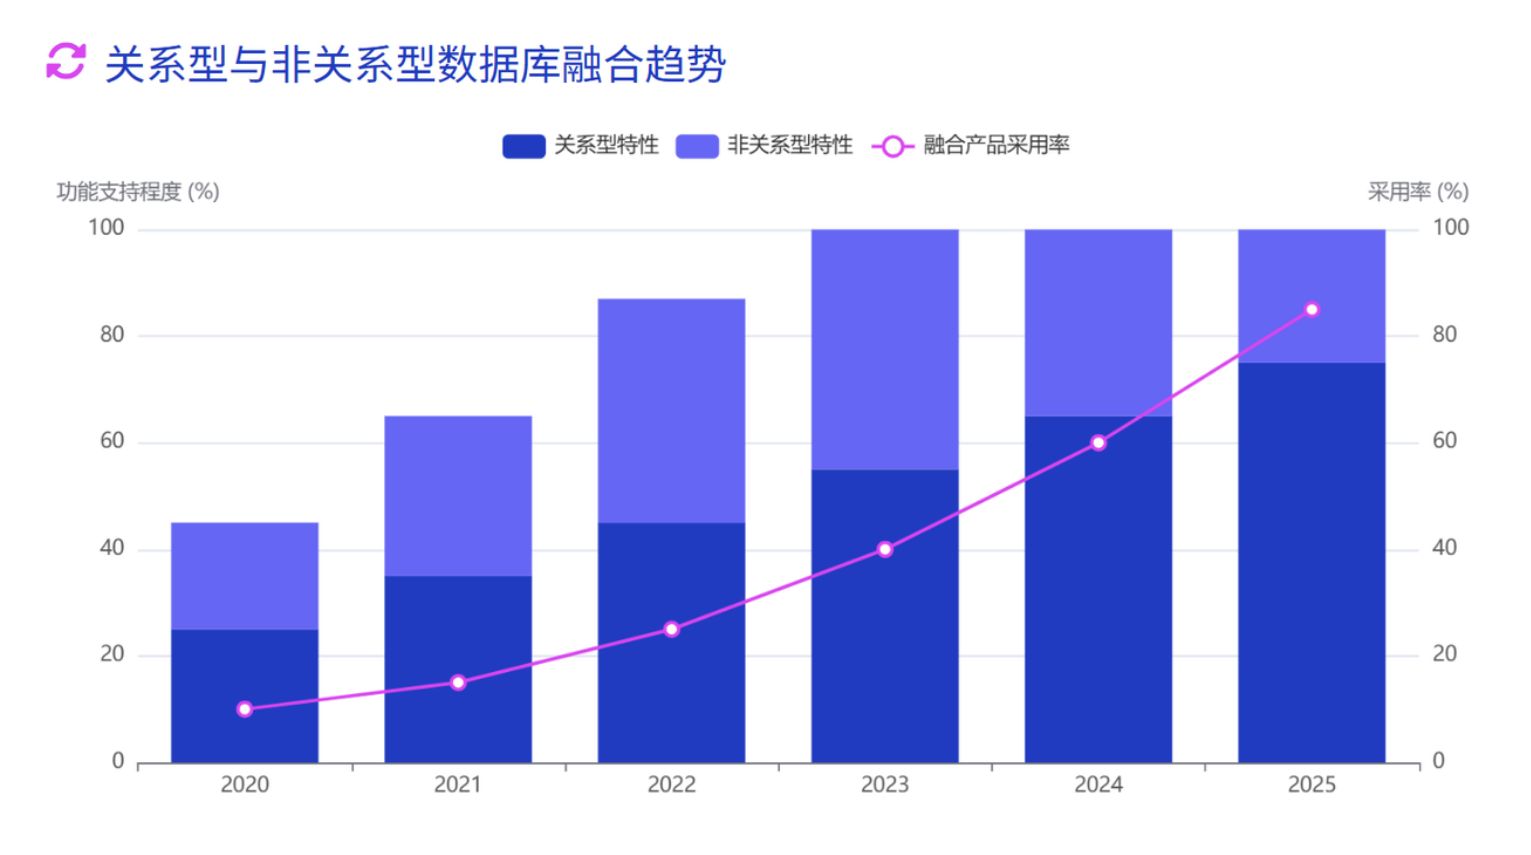
边界模糊:关系型与非关系型的融合
2025 年,传统的关系型与非关系型数据库之间的界限正在逐渐模糊。一方面,传统关系型数据库如 PostgreSQL、MySQL 等不断增强对 JSON、空间数据等非结构化数据的支持;另一方面,非关系型数据库也在不断增强对事务、ACID 特性和 SQL 查询的支持。
这种融合趋势催生了一批新型数据库产品,如 StarRocks、镜舟数据库等,它们既保留了关系型数据库的强一致性和 SQL 查询能力,又具备非关系型数据库的高扩展性和灵活性,为企业提供了更全面的数据管理解决方案。
融合的关键技术突破:
- 多模型支持:单一数据库同时支持多种数据模型(文档、图、关系等)
- SQL ++:扩展 SQL 以支持半结构化和非结构化数据查询
- 分布式 ACID:在保持高扩展性的同时提供强一致性保证
- 混合事务分析处理 ( HTAP ):同时支持事务处理和分析查询工作负载
这种融合不仅简化了企业的技术栈,还大大降低了数据集成的复杂性,使企业能够更加专注于数据价值的挖掘而非底层技术的整合。
湖仓一体:数据湖与数据仓库的统一
2025 年,湖仓一体(Lakehouse)架构已成为企业数据基础设施的主流选择。这种架构结合了数据湖的灵活性和低成本与数据仓库的高性能和数据质量保证,为企业提供了统一的数据管理平台。
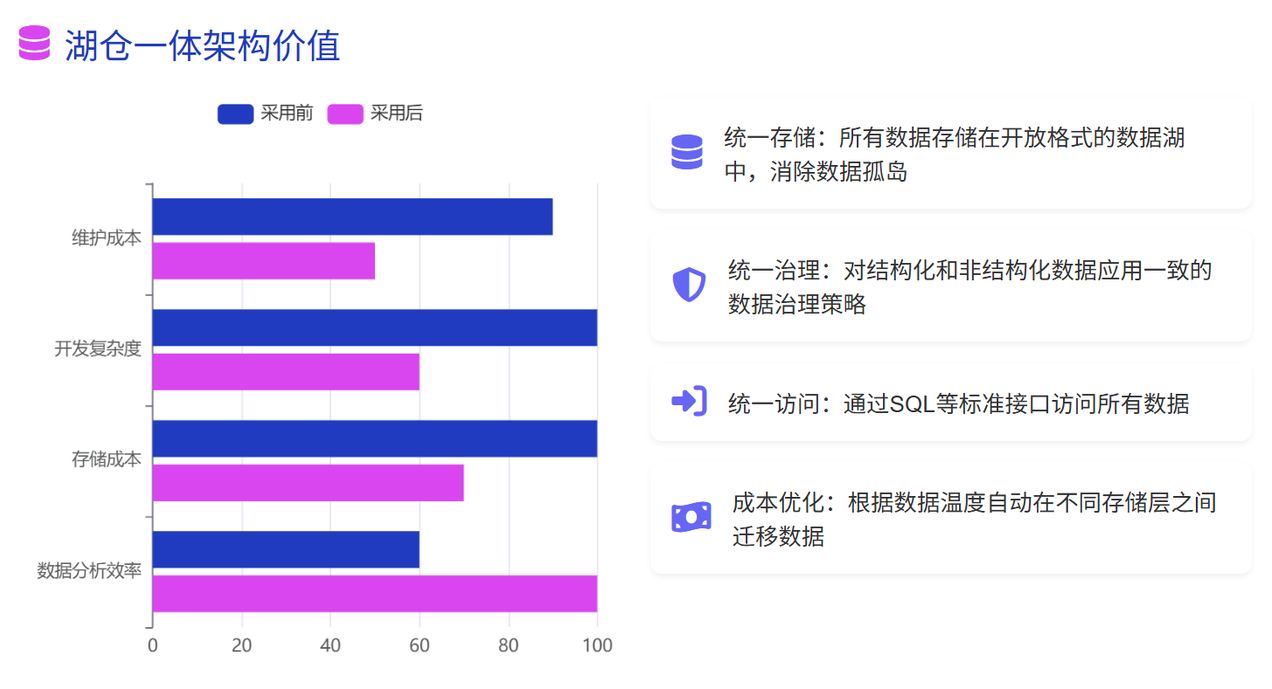
在这一趋势下,非关系型数据库,特别是列族数据库和时序数据库,正在与开放数据格式(如 Apache Iceberg、Apache Hudi 和 Delta Lake)深度集成,形成新一代数据分析解决方案。
湖仓一体的核心优势:
- 统一存储:所有数据存储在开放格式的数据湖中,消除数据孤岛
- 统一治理:对结构化和非结构化数据应用一致的数据治理策略
- 统一访问:通过 SQL 等标准接口访问所有数据
- 成本优化:根据数据温度自动在不同存储层之间迁移数据
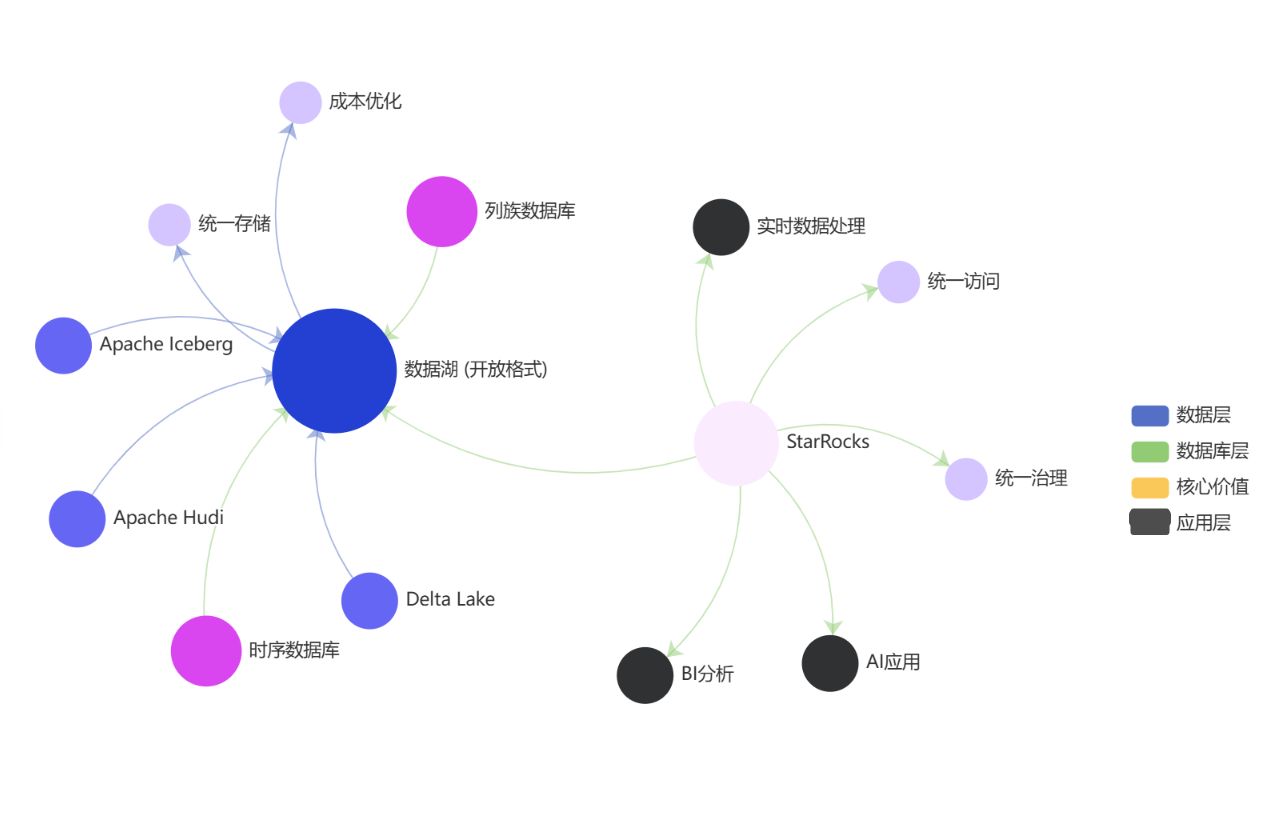 根据最新研究,采用湖仓一体架构的企业在数据分析效率上平均提升了 40%,同时将数据存储成本降低了 30%以上。StarRocks 作为这一领域的创新者,通过其独特的技术优势,正在引领湖仓一体架构的实践与发展。
AI 驱动的数据库创新
2025 年,AI 技术与数据库系统的深度融合已成为行业焦点。一方面,数据库系统为 AI 应用提供数据存储和检索服务;另一方面,AI 技术也在重塑数据库系统本身,从查询优化到自动索引,从资源调度到异常检测,AI 正在改变数据库的设计和运行方式。
AI 与数据库融合的主要方向:
- 自适应查询优化:利用机器学习自动选择最优查询计划
- 智能资源管理:预测工作负载并动态调整资源分配
- 自动化运维:AI 驱动的性能监控、故障预测和自愈能力
- 自然语言查询:通过 Text-to-SQL 技术实现自然语言数据查询
- 向量检索能力:支持大规模向量相似性搜索,为 RAG 系统提供基础
在这一趋势下,StarRocks 已经在 AI 场景相关能力上持续提升,不仅支持向量检索能力,还通过 Lakehouse 架构实现了一份开放格式的数据同时服务 AI 和 BI 等应用场景。
StarRocks:突破非关系型与关系型边界的创新实践
在数据库技术边界日益模糊的 2025 年,StarRocks 作为一款新一代分析型数据库,正在重新定义数据库的分类和应用边界。虽然 StarRocks 基于关系模型设计,但它融合了多种非关系型数据库的优势特性,为企业提供了统一的数据分析解决方案。
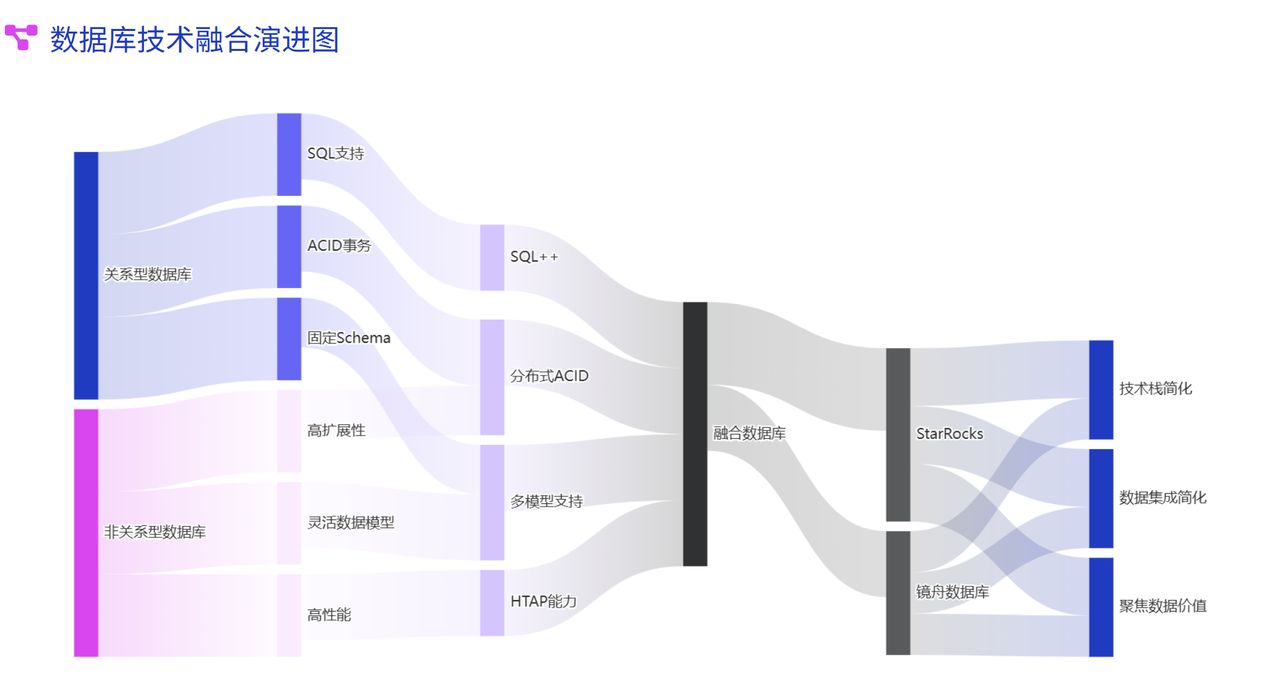
融合非关系型数据库的优势特性
StarRocks 虽然基于关系模型设计,但它融合了多种非关系型数据库的优势特性,突破了传统数据库的边界限制:
1. 列族 数据库的高性能分析能力
StarRocks 采用列式存储引擎,类似于列族数据库(如 Cassandra、HBase),但进一步优化了查询性能:
- 向量化执行引擎,批量处理数据,充分利用现代 CPU 的 SIMD 指令
- 高效的数据压缩算法,显著降低存储成本和 I/O 开销
- 延迟物化技术,减少不必要的数据处理
2. 文档数据库的灵活模式支持
StarRocks 支持半结构化数据类型,如 ARRAY、MAP、STRUCT 和 JSON,使其能够像文档数据库一样灵活处理复杂数据结构:
- 生成列功能,可以百倍提速半结构化数据分析
- JSON 函数和操作符,支持复杂 JSON 数据的查询和处理
- 灵活的模式演化,支持动态添加和修改列
3. 向量数据库的 AI 支持能力
2025 年,StarRocks 已经增强了对 AI 应用的支持,特别是在向量检索方面:
- 支持向量索引,用于高效的相似性搜索
- 与大语言模型集成,支持构建 RAG 应用
- 数据加工处理和部分列更新能力,提升模型数据准备和训练效率
通过融合这些非关系型数据库的优势特性,StarRocks 为企业提供了一站式的数据分析解决方案,无需在不同类型的数据库之间迁移和转换数据。
镜舟数据库:StarRocks 的企业级实践
镜舟数据库是 StarRocks 的商业化版本,在开源版本的基础上提供了更多企业级特性和服务支持。作为 StarRocks 商业化公司,镜舟科技推动社区持续迭代,同时与阿里云、腾讯、火山引擎等业界知名企业合作,共同推动 StarRocks 技术的发展和应用。
镜舟数据库的企业级增强:
镜舟数据库提供全面的企业级安全和管理功能:
- 细粒度的访问控制和权限管理
- 数据加密和安全审计
- 多租户资源隔离
- 完善的监控和告警系统
通过这些企业级增强,镜舟数据库为企业提供了更加可靠、安全和高效的数据分析解决方案,满足企业在生产环境中的严苛需求。
企业实践案例:StarRocks 打破数据孤岛
在 2025 年的数据驱动型企业中,StarRocks 已成为打破数据孤岛、实现统一分析的关键技术。以下是几个典型的企业实践案例,展示了 StarRocks 如何在实际应用中解决非关系型和关系型数据库割裂的问题。
京东物流:统一分析平台 Udata
京东物流基于 StarRocks 构建了服务分析一体化平台 Udata,成功解决了多种数据源割裂的问题。在实施前,京东物流面临多套实时存储方案并存的挑战,包括 ElasticSearch、ClickHouse 等多种非关系型数据库,导致运维成本高昂、数据孤岛严重。
实施方案:
京东物流采用 StarRocks 作为统一的分析引擎,逐步替换原有的 ElasticSearch 和 ClickHouse,实现实时层的存储统一。同时,通过 StarRocks 的外部表功能,实现对 MySQL、Elasticsearch、Apache Hive 等多种数据源的联邦查询,打破数据隔离。
成果与价值:
- 实现了实时层存储的统一,显著降低了运维成本
- 打破了数据孤岛,支持跨数据源的联合分析
- 提升了查询性能,满足高并发、低延迟的业务需求
- 简化了技术栈,降低了技术复杂度
58 集团:全业务线的深度实践
58 集团作为中国领先的分类信息平台,数据量庞大且类型多样。在采用 StarRocks 之前,58 集团面临着多种数据库并存、查询性能不足、运维复杂等挑战。
实施方案:
58 集团基于 StarRocks 构建了统一的数据分析平台,覆盖全业务线的数据分析需求。他们充分利用 StarRocks 的多种数据模型(明细模型、聚合模型、主键模型)和多种导入方式,整合和接入了多种现有系统,包括 Apache Spark、Apache Flink、Apache Hive 和 ElasticSearch 等。
技术架构:
StarRocks 在 58 集团的应用中采用了分布式架构,对表进行水平划分并以多副本存储。集群规模可以灵活伸缩,支持 10PB 级别的数据分析,同时支持 MPP 并行加速计算和多副本容错。
成果与价值:
- 统一了数据分析平台,简化了技术栈
- 显著提升了查询性能,支持更复杂的分析需求
- 增强了数据的可用性和可靠性
- 降低了总体拥有成本(TCO)
未来展望
2025 年,非关系型数据库已经发展成为企业数据基础设施的重要组成部分,与关系型数据库一起,共同构成了现代数据管理的两大支柱。然而,随着技术的发展和业务需求的变化,传统的数据库分类边界正在逐渐模糊,融合型数据库解决方案正成为新的趋势。
无论是传统的非关系型数据库还是新兴的融合型解决方案,选择适合的数据库技术都应该以业务需求为导向,以数据价值为中心,为企业的数字化转型和数据驱动决策提供坚实的技术基础。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3091839/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
- Databricks 再提 LTAP,AI 时代的数据底座为何重回大一统叙事?
