引言:数据时代的高效查询需求
在大数据时代,企业面临着海量数据分析的挑战。传统行式数据库在处理复杂分析查询时往往力不从心,查询缓慢且资源消耗大。随着数据量呈指数级增长,分析师们不得不等待漫长的查询时间,严重影响决策效率。列式数据库正是为解决这一痛点而生,通过创新的存储结构和处理机制,为大数据分析场景带来了革命性的性能提升。
什么是列数据库?基础概念解析
行存储 vs 列存储:存储结构对比
在传统的行式数据库中,数据是水平存储的,每一行记录被连续存放。而列式数据库则采用垂直存储方式,将同一列的数据存储在一起。
- 行式存储:用户A的姓名、年龄、地址等所有信息连续存储
- 列式存储:所有用户的姓名存储在一起,所有用户的年龄存储在一起
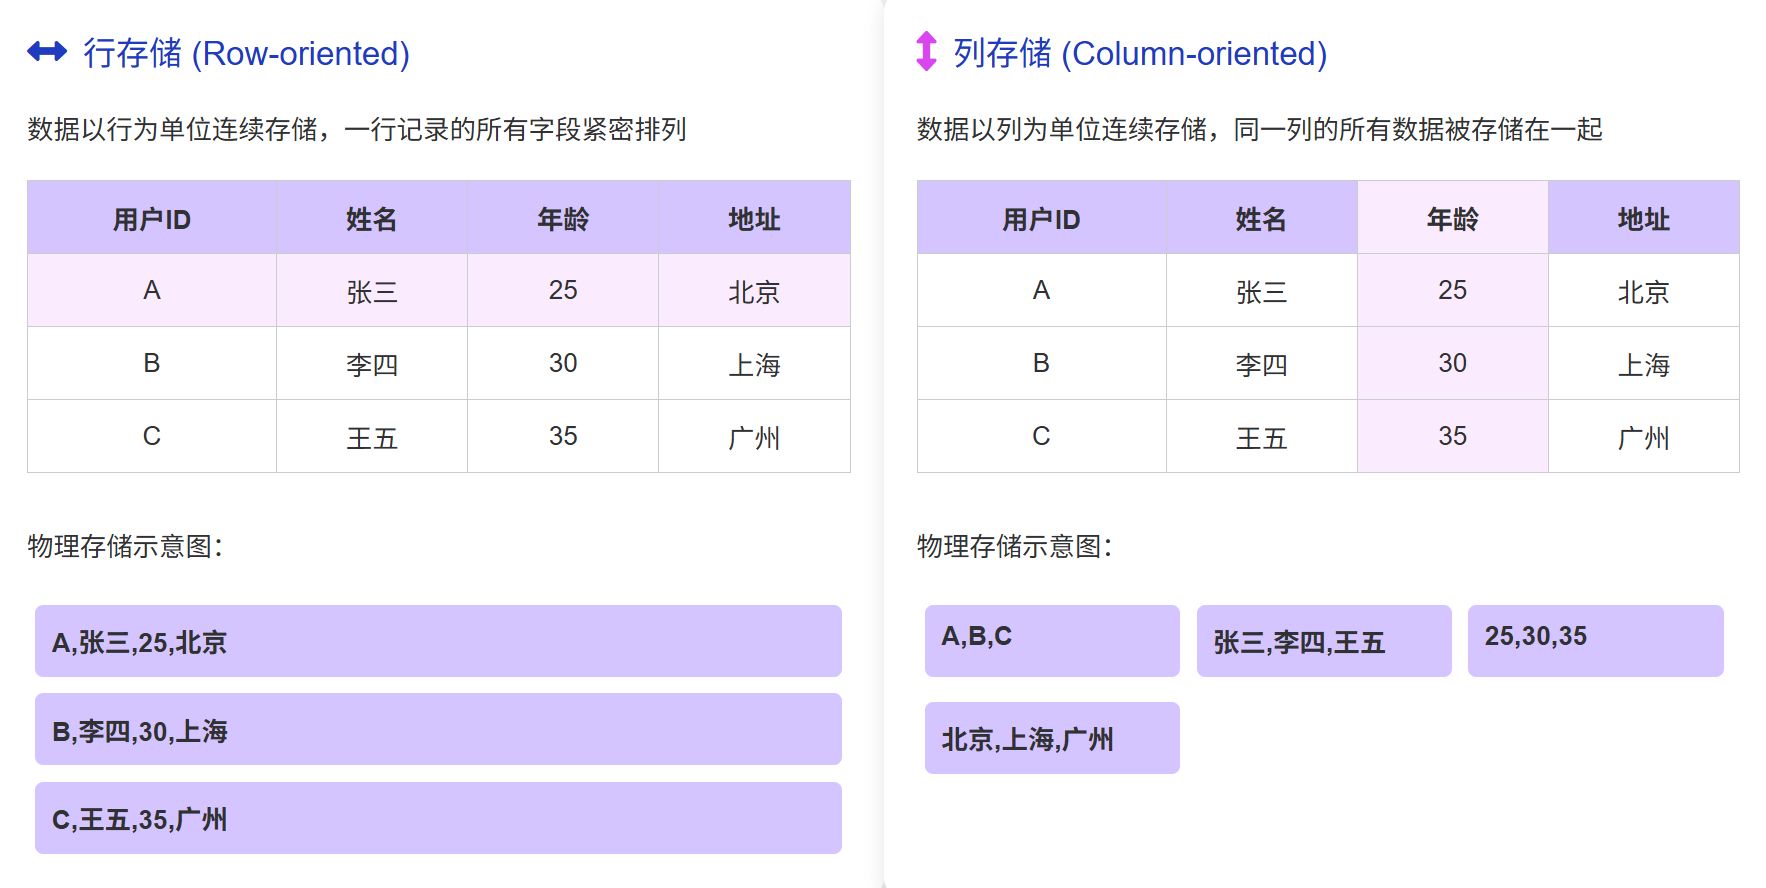 想象一个包含用户信息的表格:在行式存储中,用户A的姓名、年龄、地址等所有信息会被连续存储;而在列式存储中,所有用户的姓名会被存储在一起,所有用户的年龄会被存储在一起,以此类推。这种存储方式使得列数据库在只需访问特定列时具有显著优势,因为它只需读取查询所需的列数据,不像行式数据库那样读取整行数据。
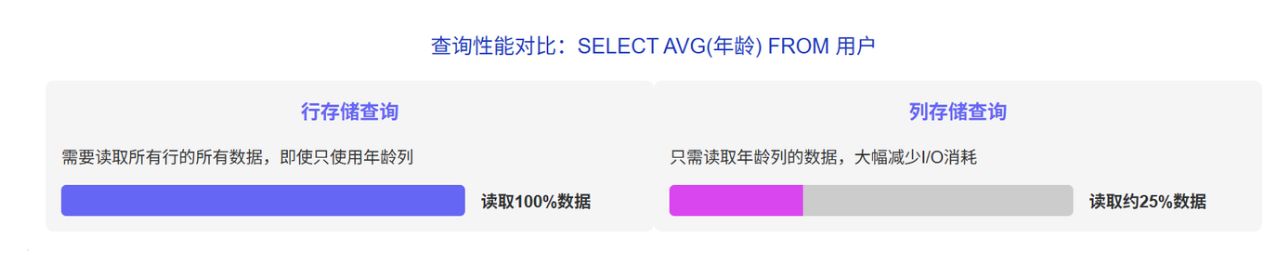
列式存储通过改变数据的物理组织方式,从根本上优化了分析型查询的性能表现。
列数据库的关键特征
列数据库具有几个显著特征,使其在分析场景中表现出色:
- 按列压缩与编码技术:同一列的数据通常具有相似性,可应用字典编码、位图索引等压缩算法,实现3-10倍的压缩率。
- 高效 I/O 与向量化计算:列数据库只读取查询所需的列,大幅减少了I/O操作。同时,许多现代列数据库支持向量化查询执行,能够同时对多个数据点执行操作,充分利用CPU的向量指令,提高处理效率。
- 延迟物化(Late Materialization):列数据库采用延迟物化原则,只在绝对必要时才将列数据组合成完整记录,最大限度减少数据移动,提高查询性能。
列式数据库通过这些关键特征,实现了数据分析场景下的高效查询处理和资源优化利用。
列数据库如何工作?技术原理解密
1. 列式存储的数据结构原理
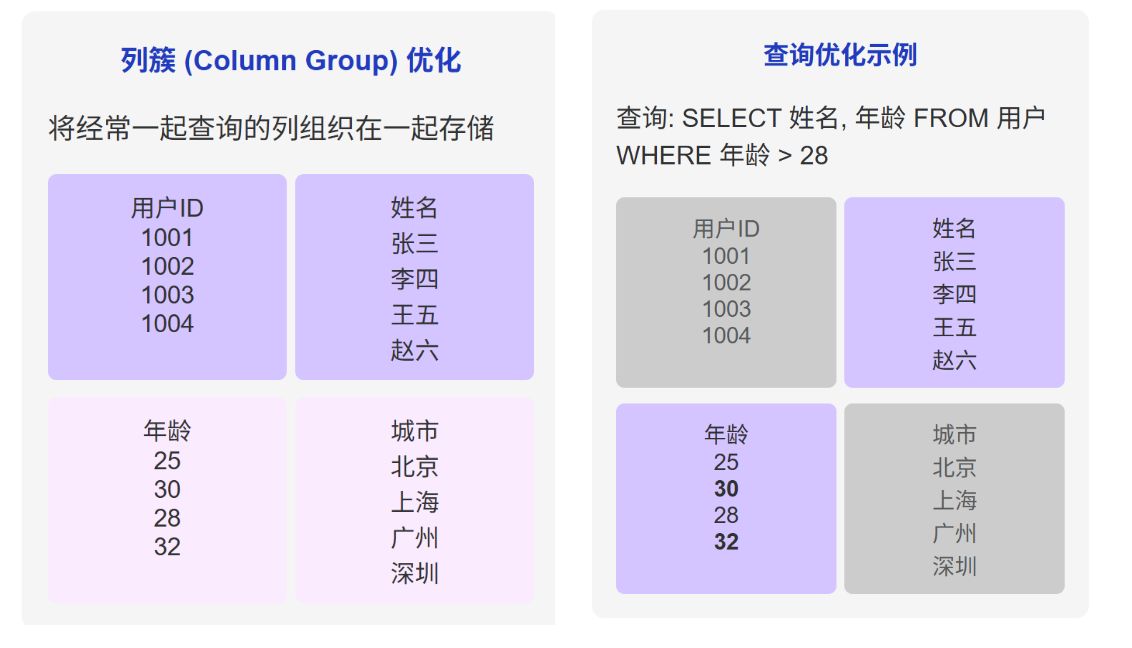
列数据库的工作原理建立在其独特的数据结构基础上。在实际实现中,列数据库通常采用数据分块和列簇(Column Group)技术来优化存储和查询。
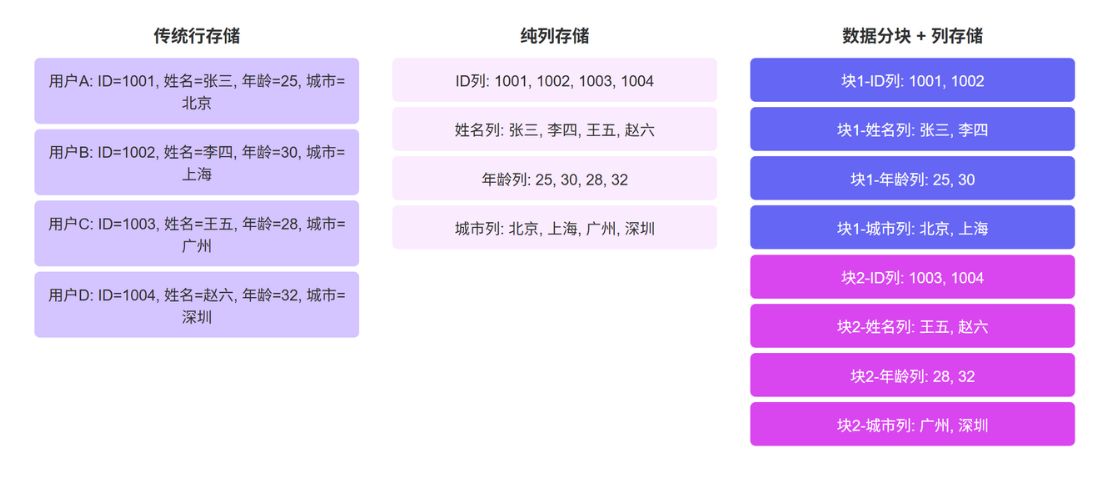
数据分块将大表划分为更小、更易管理的部分,而列簇则将经常一起查询的列组合存储,在保持列式存储优势的同时减少跨列查询的开销。
此外,列数据库广泛应用稀疏索引来加速特定列的查询。由于数据按列存储,索引可以直接指向列中的特定值,而不必遍历整个表格。
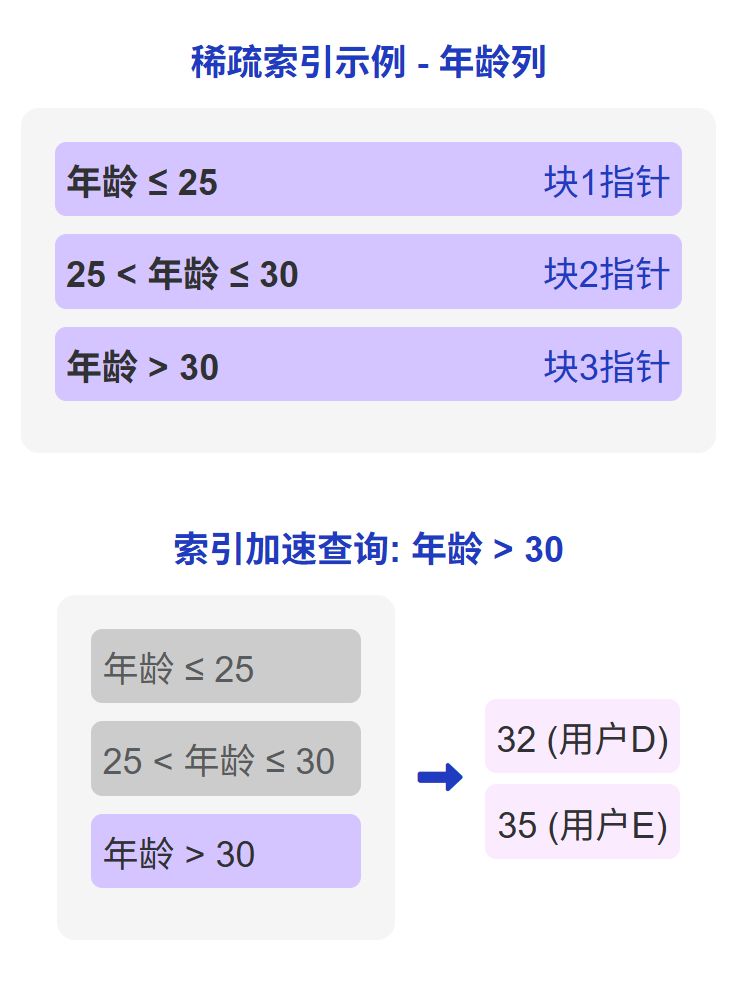 这种索引结构特别适合于大规模数据集的过滤和聚合操作,能够快速定位满足条件的数据块。列式存储的数据结构设计充分考虑了分析型查询的特点,通过优化的物理组织方式提供卓越的查询性能。
2. 查询性能提升的底层逻辑
列数据库查询性能优越的核心在于两个方面:减少磁盘I/O和高效的执行引擎。
在减少磁盘I/O方面,列数据库只读取查询涉及的列,而不是整行数据。例如,如果一个表有100列,而查询只需要2列,列数据库只会读取这2列的数据,大幅减少了I/O操作。此外,由于同一列的数据类型相同,列数据库能够实现更高效的数据压缩,进一步减少了需要从磁盘读取的数据量。
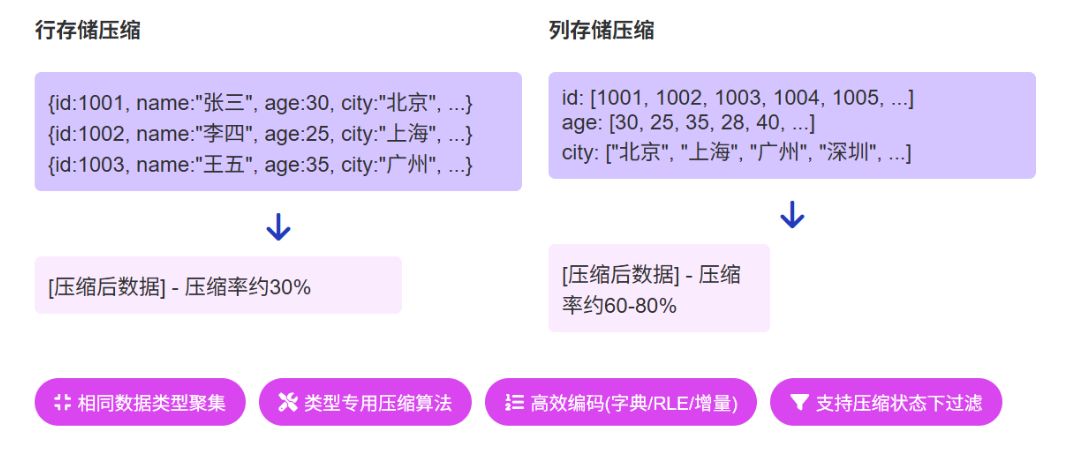
在执行引擎方面,现代列数据库普遍采用向量化执行引擎,能够批量处理数据。这种引擎利用CPU的SIMD(单指令多数据)指令,同时对多个数据点执行相同操作,显著提高了CPU利用率。
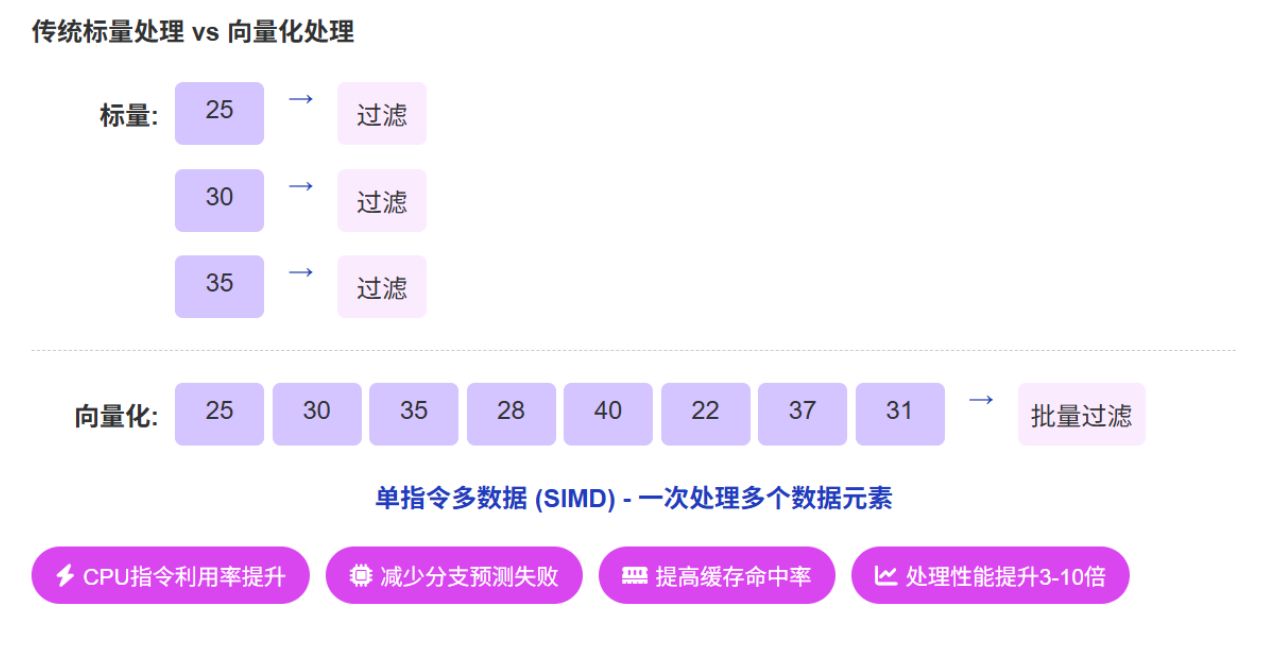
同时,列数据库的数据结构也更适合并行处理,能够充分利用多核CPU的优势。列数据库通过最小化I/O操作和优化计算资源利用,从底层架构上实现了查询性能的质的飞跃。
StarRocks:新一代列数据库的创新实践
StarRocks作为新一代列式数据库,在传统列存技术基础上引入了多项创新设计:
- 强大的向量化执行引擎:批量处理数据,充分利用现代CPU的并行处理能力;
- 基于成本的优化器 ( CBO ):根据数据特征和查询模式,自动选择最优执行计划;
- 实时数据更新机制:在保持高查询性能的同时,支持高频率的数据写入和更新;
StarRocks通过这些创新技术,实现了列式存储的全面升级,为企业提供了兼具高性能和高灵活性的数据分析解决方案。
什么场景适合选择列数据库?
列数据库特别适合以下场景:
- BI 分析与报表生成:快速处理复杂的聚合查询和多维分析,是商业智能系统的理想选择;
- 实时 数据仓库:支持高频数据写入和复杂分析查询,适合构建实时数据仓库;
- 日志分析与监控:处理半结构化数据如日志文件,实时监控系统健康状况,快速定位问题;
- 用户行为分析:快速生成多维度报表,帮助企业深入了解用户行为模式;
- 金融风控:实时计算各类风险指标,监测异常交易行为,及时发现和预防欺诈风险。
虽然列数据库在分析场景中表现出色,但并非所有场景都适合使用列数据库:
- 高并发事务处理:对于OLTP系统,如订单处理、库存管理等,传统行式数据库通常更合适;
- 单行查询密集型应用:对于主要执行单行查询的应用,行式数据库能提供更好的性能。
结语:掌握列式存储,开启高效数据分析
列数据库不是全能的解决方案,但在分析密集型场景中,它能够发挥最大价值,为企业提供卓越的性能和灵活性。选择合适的数据库技术,应根据业务特点和查询模式进行评估,在适当的场景中选择适当的技术。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3089249/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
- Databricks 再提 LTAP,AI 时代的数据底座为何重回大一统叙事?
