一、引言:数据驱动决策的关键工具
在当今数字化时代,分析型数据库已成为企业数据驱动决策的核心基础设施。以某知名零售企业为例,通过实时分析库存数据,他们将供应链效率提升了 35%,显著降低了库存成本并提高了商品周转率。分析型数据库的核心价值在于:
- 快速响应复杂查询,支持亿级数据秒级返回
- 处理高并发分析请求,满足企业全员数据分析需求
- 高效处理海量结构化/半结构化数据,支持多维度深度分析
二、分析型数据库基础概念解析
1. 定义与本质区别
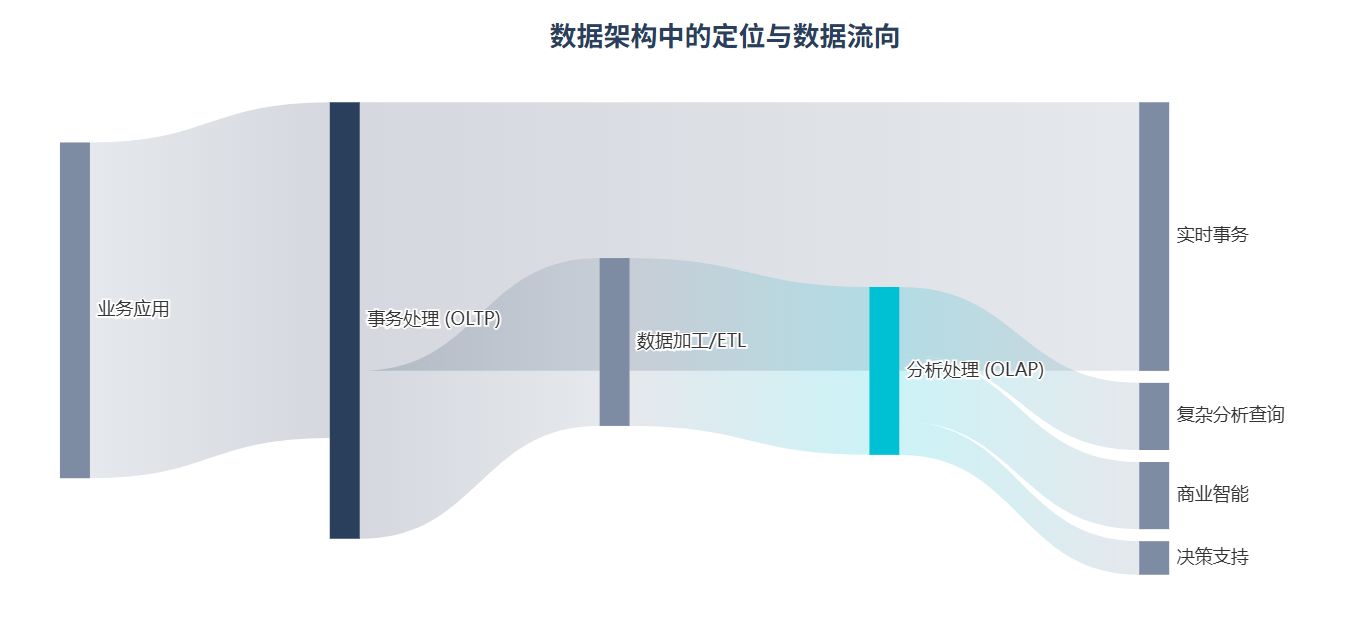
 分析型数据库(OLAP)与事务型数据库(OLTP)有本质区别:OLAP 专为复杂分析查询优化,而 OLTP 侧重于高频事务处理。这种架构差异决定了它们在企业数据架构中的不同定位。
2. 典型应用场景
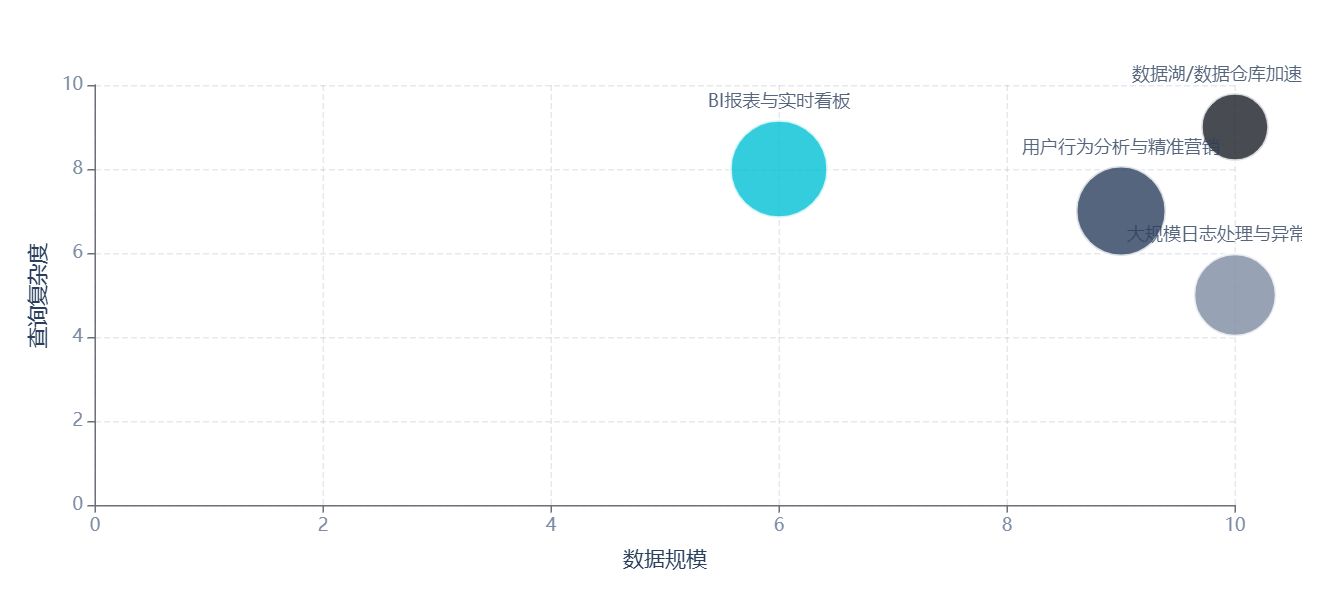
- 业务智能(BI)报表与实时看板:支持企业决策层实时监控业务指标,快速生成多维度报表,分析业务趋势和异常。数据量一般在TB级。
- 用户行为分析与精准营销:对海量用户交互数据进行多维分析,构建用户画像,支持实时个性化推荐和精准营销。数据量一般在PB级。
- 大规模日志处理与异常检测:实时分析系统日志和监控数据,快速发现异常模式和性能瓶颈,提高系统运维效率。数据量一般在PB级。
- 数据湖/数据仓库加速查询:为已有的数据湖或数据仓库提供查询加速层,显著提升复杂分析查询的响应速度。数据量一般超过PB级,甚至可达EB级。
三、选型的 5 个关键指标(务实避坑指南)

1. 查询性能
- 并发能力:支持数百用户同时查询而不降级
- 响应时间:复杂查询的平均响应时间(亚秒级为佳)
- 多表关联效率:大表 JOIN 操作的性能表现
2. 数据实时性
评估业务对数据新鲜度的要求,明确秒级/分钟级延迟对决策的影响。例如,金融风控场景通常要求秒级数据更新,而月度销售分析可接受小时级延迟。
3. 扩展成本
对比硬件投入与云原生弹性伸缩方案的总体拥有成本(TCO)。云原生方案通常能将扩展成本降低 40-60%,但需评估数据出入云的成本。
4. 生态兼容性
考察与现有数据工具链(如 Spark、Flink、Kafka)的集成便捷度,避免技术孤岛。理想的分析型数据库应支持标准 SQL 接口和主流 BI 工具连接。
5. 运维复杂度
某金融客户误选 HBase 作为分析型数据库后,运维成本翻倍,最终不得不迁移平台。评估是否需要专职 DBA 团队,以及自动化运维能力。
四、主流方案对比:从开源到商业化
主流分析型数据库横向对比
以下是对主流分析型数据库的横向对比分析,涵盖开源与商业化特性、架构设计、性能特点及适用场景等维度:
|
数据库 |
存储模型 |
查询引擎 |
事务支持 |
索引类型 |
数据更新 |
优势场景 |
局限性 |
|---|---|---|---|---|---|---|---|
|
Apache Druid |
列式存储 |
实时流批一体 |
不支持 ACID |
位图索引、倒排索引 |
仅追加,不支持流式更新 |
实时日志分析、监控仪表盘(高并发)、用户行为分析 |
JOIN 能力弱,不支持流式更新 |
|
ClickHouse |
列式存储 |
单机高性能 |
有限事务(MergeTree 表) |
主键索引、跳表索引 |
支持批量插入,更新需重写分区 |
日志/事件数据分析、单表复杂查询、离线报表 |
高并发能力差,不适合频繁更新的场景 |
|
Snowflake |
混合存储 |
云原生分离式 |
完整 ACID |
自动索引优化 |
实时增删改查 |
云上数据仓库、跨平台数据整合、企业级扩展性 |
成本高,依赖云服务,无开源选项 |
|
StarRocks |
列式存储 |
MPP 分布式 |
支持 ACID(主键模型) |
主键索引、位图索引、全局字典 |
秒级实时更新 |
实时分析、多表关联查询、数据湖加速、高并发 BI |
生态工具较新,部分功能需商业化支持 |
|
Trino |
无存储层 |
联邦查询引擎 |
无事务支持 |
依赖外部存储(如 Hive、JDBC 表) |
仅查询,不管理数据 |
跨数据源联邦查询(Hive、JDBC 等)、即席分析 |
无存储层,性能依赖外部系统 |
|
Greenplum |
行存/列存 |
MPP 分布式 |
完整 ACID |
B 树索引、位图索引 |
支持标准 SQL 更新 |
传统数据仓库迁移、复杂 ETL 任务、结构化数据分析 |
实时性较弱,架构复杂度高 |
性能对比
StarRocks 在宽表和多表查询性能上表现出色,特别是在宽表场景下,其查询速度远超行业知名数据库。
1. 宽表场景
- StarRocks:比 ClickHouse 快 1.7-2.2 倍,比 Druid 快 2.2-8.9 倍 。
- ClickHouse:适合大宽表场景,但高并发性能较差(建议并发<100) 。
- Druid:在高并发查询(如 UI 交互)下表现优异,但单表查询性能较弱 。
2. 多表关联
- StarRocks:支持 Colocate Join、Shuffle Join,比 Trino 快 14.6 倍 。
- Greenplum:依赖传统 MPP 优化,适合复杂 ETL 任务 。
- Trino:依赖外部存储,多表查询性能受数据源影响大 。
3. 低基数聚合
- StarRocks:通过全局字典优化,性能比 ClickHouse 快 2.3 倍 。
- ClickHouse:需预计算或物化视图加速,灵活性较低 。
各个分析型数据库的 SQL 兼容性与生态集成
StarRocks 完全兼容 MySQL 协议,支持 Hive/Iceberg/Hudi 外部表。ClickHouse 兼容 MySQL 语法,但部分函数与标准 SQL 差异较大。Greenplum 基于 PostgreSQL,兼容 PG 生态。Trino 支持 ANSI SQL,可跨 Hive、Kafka、Redis 等查询。Snowflake 高度兼容标准 SQL,深度集成云服务(AWS/Azure/GCP)。
五、2025 年趋势预测
企业应避免盲目追求新技术,应优先匹配业务发展阶段。初创企业可选择云服务降低前期投入,成熟企业则需考虑长期 TCO 和数据治理难度。
1.云原生架构主导
Serverless 按需计费模式可能成为主流,企业可根据实际分析需求弹性调整资源,避免资源浪费。同时,私有化部署仍将在金融、政府等特定行业保持重要地位。
2. AI 驱动的查询优化
智能索引推荐、自动查询重写和异常检测将大幅降低使用门槛,使非技术人员也能高效进行数据分析。
六、行动建议:三步走落地策略
1. 需求优先级排序
提供业务部门访谈模板,明确核心分析场景和性能指标。关注指标应包括:查询复杂度、数据量级、并发用户数和实时性要求。
2. 小规模 PoC 验证
提供基准测试清单,确保在真实业务场景下评估各方案性能。建议使用实际业务数据的 10%进行初步测试,再逐步扩大规模。
3. 迁移风险控制
采用灰度发布策略,先迁移非核心业务,积累经验后再迁移关键应用。同时,确保完善的数据回滚方案,以应对潜在问题。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038017/viewspace-3081518/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从 StarRocks 到 MIP:数据平台的下一步是“理解”
- Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
- Semantic View 技术解析(二):业务口径如何进入数据库执行路径
- 从单条 SQL 到完整任务:Agent 带来的五个数据负载变化
- 从 DBA 经验到 Agent:镜舟如何构建生产级智能排障体系
- 为什么 Text-to-SQL 总是停在 Demo?
- AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口
- 一句话发起排障,镜舟 DevOps Agent 正式上线
- WAIC 2026 交卷时刻:Agent落地新标尺是什么?
- Databricks 再提 LTAP,AI 时代的数据底座为何重回大一统叙事?
