过完年了,今天正式上班,新的一年祝大家工作顺利,事事如意,龙年行好运,万事遂心愿!
上一篇我们聊了如何用SQL语句创建delta表,详见:如何创建Delta表之方式一:By SQL
这次我们接着聊,如何用DataFrame API来创建Delta表。其实这个DataFrame API就是通过Python,R和Scala等常见的编程语言来创建Delta表。为什么是这些语言?因为我们都是基于Spark引擎来对数据进行操作的。
注意:本次是基于pyspark来做演示。
准备
还是上一篇提到的,你需要一个Azure Databricks Workspace,创建一个基于Python的Notebook + 标准的Databricks Runtime计算集群(这里使用最新LTS版本:13.3 LTS)
# 数据源路径data_source = "dbfs:/databricks-datasets/learning-spark-v2/flights/summary-data/json/2010-summary.json"# 读取数据df = spark.read.format("json").load(data_source)
先看一下读取的数据是什么样子的:
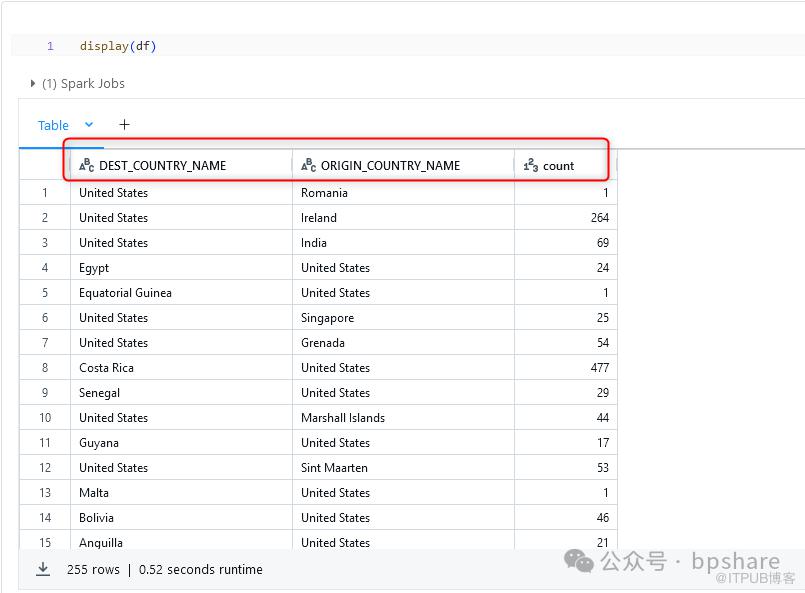
从结果来看,一共3列,第一列:目的地国家名称,字符类型。第二列:出发国家名称,字符类型。第三列:航班数量,整型。
我们来直接保存数据为delta,用DataFrame API方式还是比较简单的,使用下面一行代码即可:
# 写入delta表table_name = "flights_summary"df.write.saveAsTable(table_name)
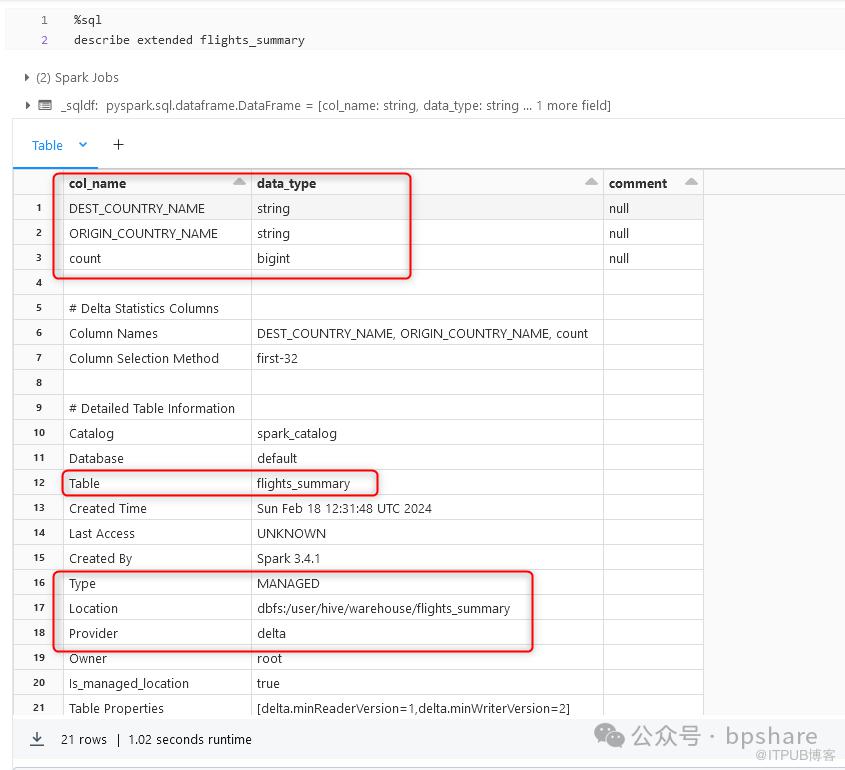
用命令行检查一下delta表:flights_summary是否创建成功:
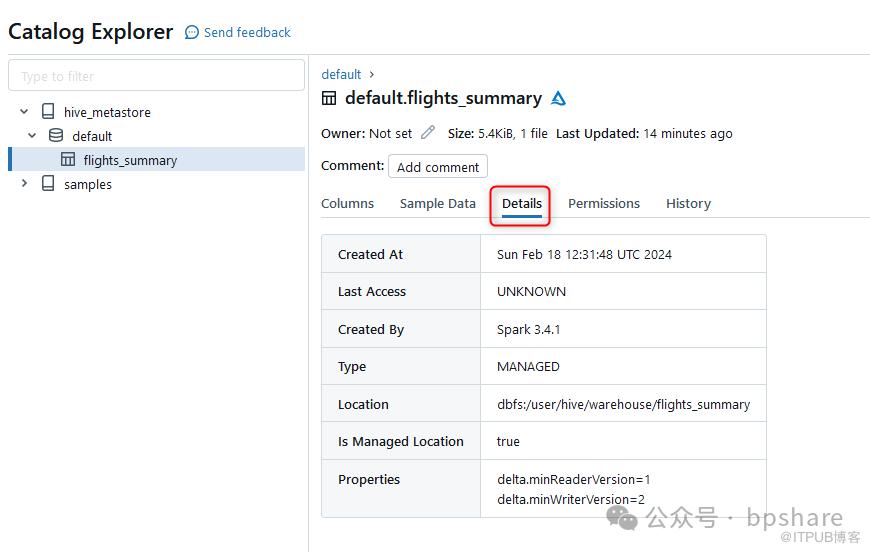
从UI上也可以检查,到Catalog->hive_metastore->default就可以看到:

还可以看到Sample Data:
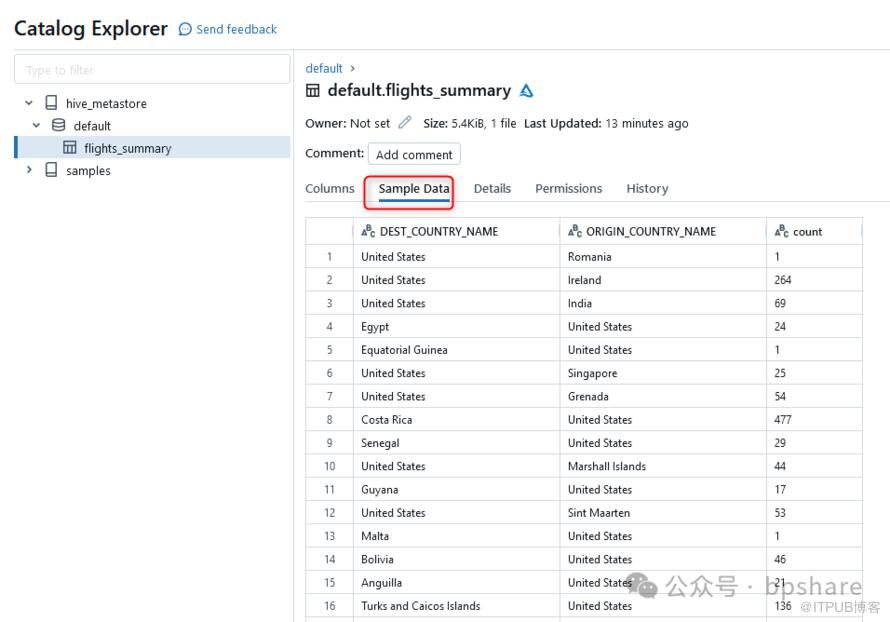
Details里有详细的信息:
好了,这次就先分享到这里!
点击关注本公众号,解锁更多Databricks知识!
原文作者:BPShare;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
